단원 홈

Ⅲ. 데이터 모델링과 평가8차시

무리에 이름을 붙이면
무엇이 보이고 무엇이 숨을까

이름은 가설이다 — 쓰지 않은 증거로 채점한다

7차시는 서울 지하철 239개 역을 네 무리로 갈라 놓고 번호만 돌려주었습니다. '업무지형'·'주거지형' 같은 이름은 컴퓨터가 아니라 사람이 붙입니다. 무엇을 근거로 붙이고, 그 이름이 맞았는지는 무엇으로 채점합니까?

  • [12데과03-03]
  • 50분네 정거장
  • 새 도구배율표와 열지도
  • 자료서울 지하철 239역 · 2024년 11월
Ⅲ 단원 지도8 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    무리의 얼굴(가운데 역의 하루 곡선 · 네 칸 배율표)을 읽고, 이름이 어느 칸에서 나왔는지 말할 수 있다.

  2. 손으로

    군집에 쓰지 않은 자료(주말 비율)를 이어 붙여 내가 붙인 이름을 스스로 채점할 수 있다.

  3. 확인에서

    이름과 어긋나는 역을 지우지 않고, 보고서에 함께 적을 것을 한 줄로 쓸 수 있다.

1
여는 장면 · 5분

번호만 적힌 목록과, 아직 뜯지 않은 봉투 하나

Ⅲ-7 에서 가져옴서울 지하철 239역을 하루 모양(시각별 승차·하차 몫 40칸)으로 재어 KMeans 로 k = 4 로 나눴습니다. 무리 크기는 67 · 32 · 92 · 48역. 그리고 7차시 확인 문제가 이미 말했습니다 — 번호는 이름표가 아니다.

컴퓨터가 돌려준 것은 역마다 붙은 0 · 1 · 2 · 3 네 개의 숫자뿐입니다. 이 숫자에는 뜻이 없습니다. 무리 1이 무리 0보다 크지도, 먼저도 아니에요. 그런데 이 결과를 남에게 보여 주려면 결국 말이 필요합니다 — "이 32개 역은 업무지형입니다" 처럼요.

그 말은 데이터가 하지 않았습니다. 사람이 붙인 가설입니다. 가설이라면 채점할 수 있어야 합니다. 그래서 오늘은 봉투를 하나 준비했습니다 — 239개 역의 주말 붐빔(주말·공휴일 하루 평균 ÷ 평일 하루 평균)이 들어 있고, 이 값은 7차시의 군집에 한 번도 쓰이지 않았습니다. 이름을 다 붙인 뒤에 열 것입니다.

오늘의 출발점번호 넷 · 봉투 하나
7차시가 돌려준 것무리 292역무리 132역무리 348역무리 067역이름은 아직 없다 — 번호뿐이다봉인주말 붐빔239역 · 주말 ÷ 평일 하루 평균이름을 다 붙인 뒤에 연다

자료: 서울교통공사 역별 일별 시간대별 승하차인원 정보(2024) — 2024년 11월 평일 21일 하루 평균으로 가공(원장 계산)

표 17차시가 돌려준 표서울 지하철 239역 · 2024년 11월 평일
무리 번호역 수몫이름주말 붐빔
무리 06728.0%가려 둠봉인
무리 13213.4%가려 둠봉인
무리 29238.5%가려 둠봉인
무리 34820.1%가려 둠봉인

표가 말해 주는 것은 번호와 역 수뿐입니다. 가장 큰 무리가 92역이라는 것은 알지만, 그 92역이 어떤 동네인지는 한 칸도 적혀 있지 않습니다. 자료: 서울교통공사, 역별 일별 시간대별 승하차인원 정보(2024), 공공데이터포털(15048032), 이용허락범위 제한 없음 — 2024년 11월 평일 하루 평균으로 가공(원장 실측)

먼저 예측

아직 아무 그림도 보지 않았습니다. 서울 지하철 239개 역을 네 덩어리로 나눈다면 어떤 넷이 될까요? 네 이름을 한 문장으로 적어 보세요. 그리고 아래 빈 명패 넷을 공책에 옮겨, 무리 2(가장 큰 92역)에 어떤 이름을 걸지 한 가지만 먼저 정해 둡니다. 3정거장 실험실에서 여러분이 실제로 이름을 걸고, 봉투가 그것을 채점합니다.

무리 0 67역
이름
무리 1 32역
이름
무리 2 92역
이름
무리 3 48역
이름
체크포인트 1

번호 넷과 역 수만 손에 쥐었고, 붙일 이름을 한 문장 적어 두었다 — 봉투는 아직 봉인되어 있다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

이름은 어디에서 오고, 무엇이 그 이름을 채점하나

2-1무리의 얼굴을 읽는다

한 무리에 속한 역이 92개라면, 그 92개의 하루를 한꺼번에 볼 수는 없습니다. 대신 무리의 얼굴을 그립니다 — 시각마다 그 무리 역들의 중앙값을 이어 가운데 역의 하루를 한 줄로 만드는 것이지요. 평균이 아니라 중앙값을 쓰는 까닭은 나중에 다시 나옵니다.

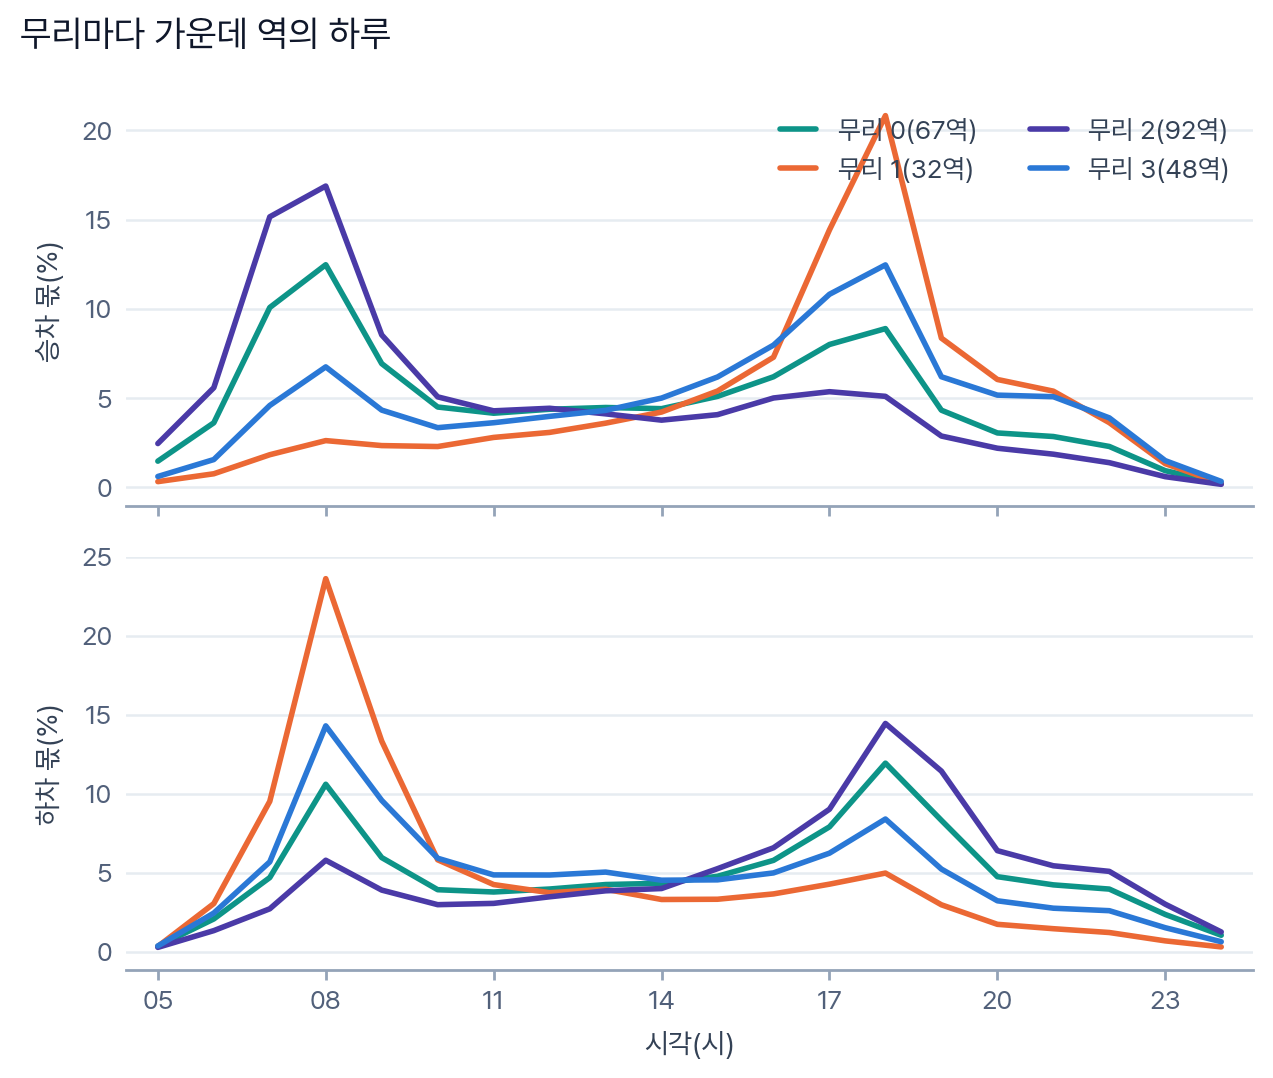
그림 1을 위아래로 읽어 보세요. 무리 2는 아침에 타고(08시 16.9%) 저녁에 내립니다(18시 14.4%). 무리 1은 정확히 그 반대예요 — 아침에 내리고(08시 23.6%) 저녁에 탑니다(18시 20.8%). 사람이 집에서 나가는 역과 일터에 닿는 역의 하루가 거울처럼 뒤집혀 있습니다.

그림 1무리마다 가운데 역의 하루왼쪽 타는 사람 · 오른쪽 내리는 사람 · 주황 삼각형은 봉우리
승차 몫(%)가로: 시각(시) · 05 ~ 2408시 16.9%무리 292역18시 20.8%무리 132역18시 12.5%무리 348역08시 12.5%무리 067역0510152024하차 몫(%)가로: 시각(시) · 05 ~ 2418시 14.4%무리 292역08시 23.6%무리 132역08시 14.3%무리 348역18시 11.9%무리 067역0510152024 승차 몫(%)가로: 시각(시) · 05 ~ 2408시 16.9%무리 292역18시 20.8%무리 132역18시 12.5%무리 348역08시 12.5%무리 067역0510152024하차 몫(%)가로: 시각(시) · 05 ~ 2418시 14.4%무리 292역08시 23.6%무리 132역08시 14.3%무리 348역18시 11.9%무리 067역0510152024

네 무리의 얼굴이 모두 다릅니다. 무리 2와 무리 1은 아침·저녁이 거울처럼 반대, 무리 3은 봉우리가 낮은 대신 낮과 밤이 두껍고, 무리 0은 네 봉우리가 모두 어중간합니다. 자료: 서울교통공사, 역별 일별 시간대별 승하차인원 정보(2024), 공공데이터포털(15048032), 이용허락범위 제한 없음 — 2024년 11월 평일 하루 평균 · 무리마다 시각별 중앙값(원장 실측)

그런데 곡선만 보고 이름을 붙이면 미끄러지기 쉽습니다. 네 줄을 한 장에 겹쳐 놓으면 큰 역의 곡선이 화면을 차지하고, 무리 3처럼 봉우리가 낮은 무리는 "특징이 없다"고 읽히기 때문입니다. 그래서 다음 칸에서 곡선을 숫자 네 개로 줄입니다.

2-2배율표 — 이름은 '튀는 칸'에서 나온다

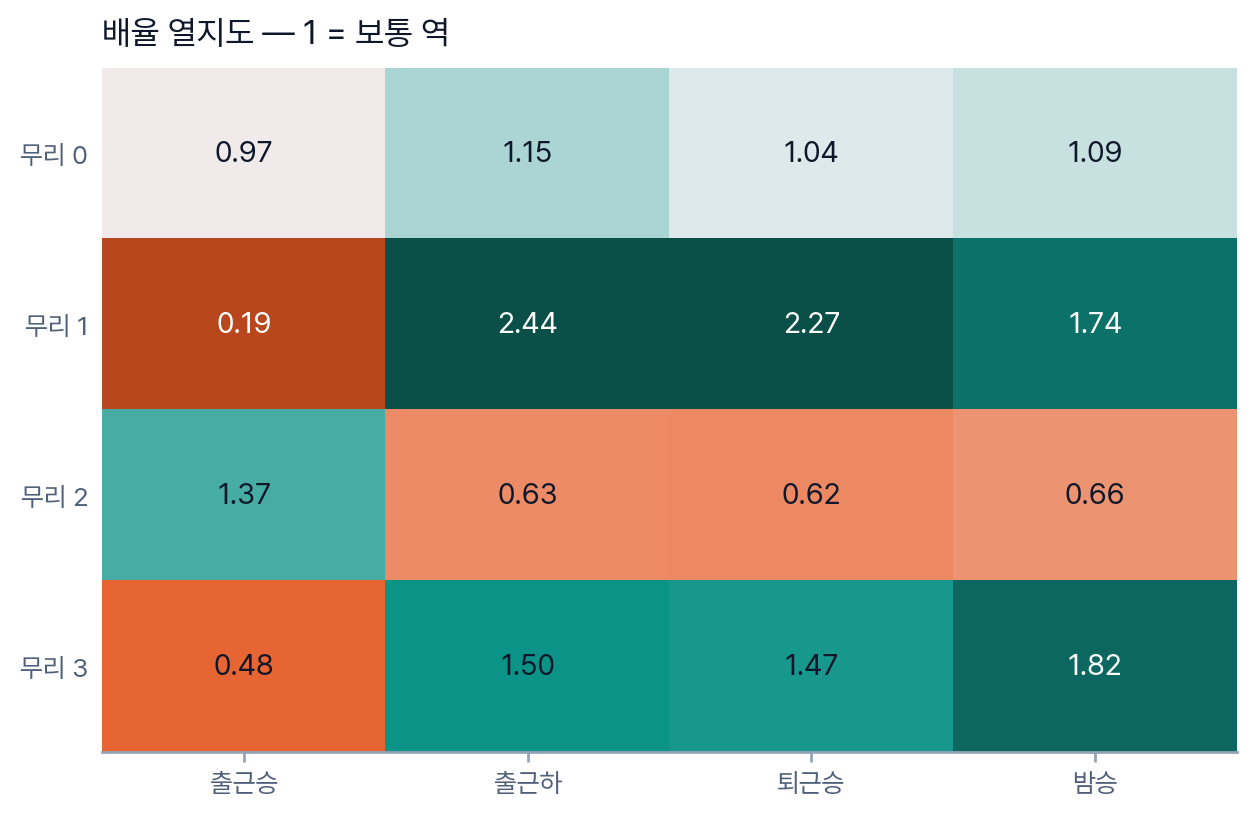
하루 40칸을 네 칸으로 줄입니다. 출근 승차(07·08시에 탄 몫) · 출근 하차 · 퇴근 승차(18·19시에 탄 몫) · 밤 승차(21시~막차에 탄 몫). 그리고 무리마다 그 네 칸의 중앙값을 낸 뒤, 239역 전체의 중앙값으로 나눕니다. 나온 숫자가 배율입니다 — 1이면 보통 역과 같고, 2.44면 보통 역보다 두 배 넘게 많다는 뜻입니다.

그림 2의 왼쪽이 그 배율 열지도입니다. 칸 색이 진할수록 1에서 멉니다 — 청록은 보통 역보다 많다, 주황은 적다. 오른쪽은 같은 16개 숫자를 칸마다 자 위에 세운 것입니다. 줄마다 혼자 튀어나온 점이 보이지요? 이름은 그 점에서 나옵니다.

그림 2배율표를 두 가지로 — 열지도와 자배율 = 무리 중앙값 ÷ 239역 중앙값
배율 = 무리 중앙값 ÷ 239역 중앙값1 = 보통 역과 같다출근승출근하퇴근승밤승무리 292역1.370.630.620.66무리 132역0.192.442.271.74무리 348역0.481.501.471.82무리 067역0.971.151.041.091.25 이상0.80 이하 — 이 칸에서 이름이 나온다같은 값을 칸마다 자 위에 세우면가로: 배율 0 ~ 2.6 · 점선 1 = 보통 역 · 숫자는 무리 번호출근승1302주거지형출근하2031업무지형퇴근승2031업무지형밤승2013번화·대학가형012무리 0 은 네 줄 어디에서도 튀지 않는다 → 혼합형 배율 = 무리 중앙값 ÷ 239역 중앙값1 = 보통 역과 같다출근승출근하퇴근승밤승무리 292역1.370.630.620.66무리 132역0.192.442.271.74무리 348역0.481.501.471.82무리 067역0.971.151.041.091.25 이상0.80 이하테두리가 있는 칸에서 이름이 나온다같은 값을 칸마다 자 위에 세우면가로: 배율 0 ~ 2.6 · 점선 1 = 보통 역 · 숫자는 무리 번호출근승1302주거지형출근하2031업무지형퇴근승2031업무지형밤승2013번화·대학가형012무리 0 은 네 줄 어디에서도 튀지 않는다 → 혼합형

무리 1은 출근 하차 2.44배·퇴근 승차 2.27배인데 출근 승차는 0.19배 — 아침에 내리기만 하는 역들입니다(업무지형). 무리 2는 출근 승차 1.37배에 나머지가 모두 0.7 아래(주거지형). 무리 3은 밤 승차 1.82배(번화·대학가형). 무리 0은 네 칸이 0.97~1.15 — 어느 줄에서도 튀지 않습니다(혼합형). 자료: 서울교통공사, 역별 일별 시간대별 승하차인원 정보(2024), 공공데이터포털(15048032) — 2024년 11월 평일 하루 평균(원장 실측)

규칙이름을 붙일 때는 그 이름을 만든 칸과 배율을 함께 적는다 — “업무지형(출근 하차 2.44배 · 퇴근 승차 2.27배)”. 칸을 못 대는 이름은 이름이 아니라 인상이다.

2-3군집에 쓰지 않은 증거로 채점한다

여기까지는 같은 자료를 다시 요약한 것뿐입니다. 이름이 맞았는지는 아직 아무도 말하지 않았어요. 그래서 봉투를 엽니다. 봉투 안에는 역마다 주말 비율 (주말·공휴일 하루 평균 ÷ 평일 하루 평균)이 들어 있고, 이 값은 군집을 만들 때 한 번도 쓰이지 않았습니다.

이름이 예언을 합니다. '업무지형'이 맞다면 주말에 비어야 하고, '번화·대학가형'이 맞다면 주말에도 붐벼야 합니다. 이 예언이 맞는지를 보는 것이 이름의 채점입니다.

표 2봉투를 열면 — 무리별 주말 비율주말·공휴일 9일 ÷ 평일 21일, 하루 평균
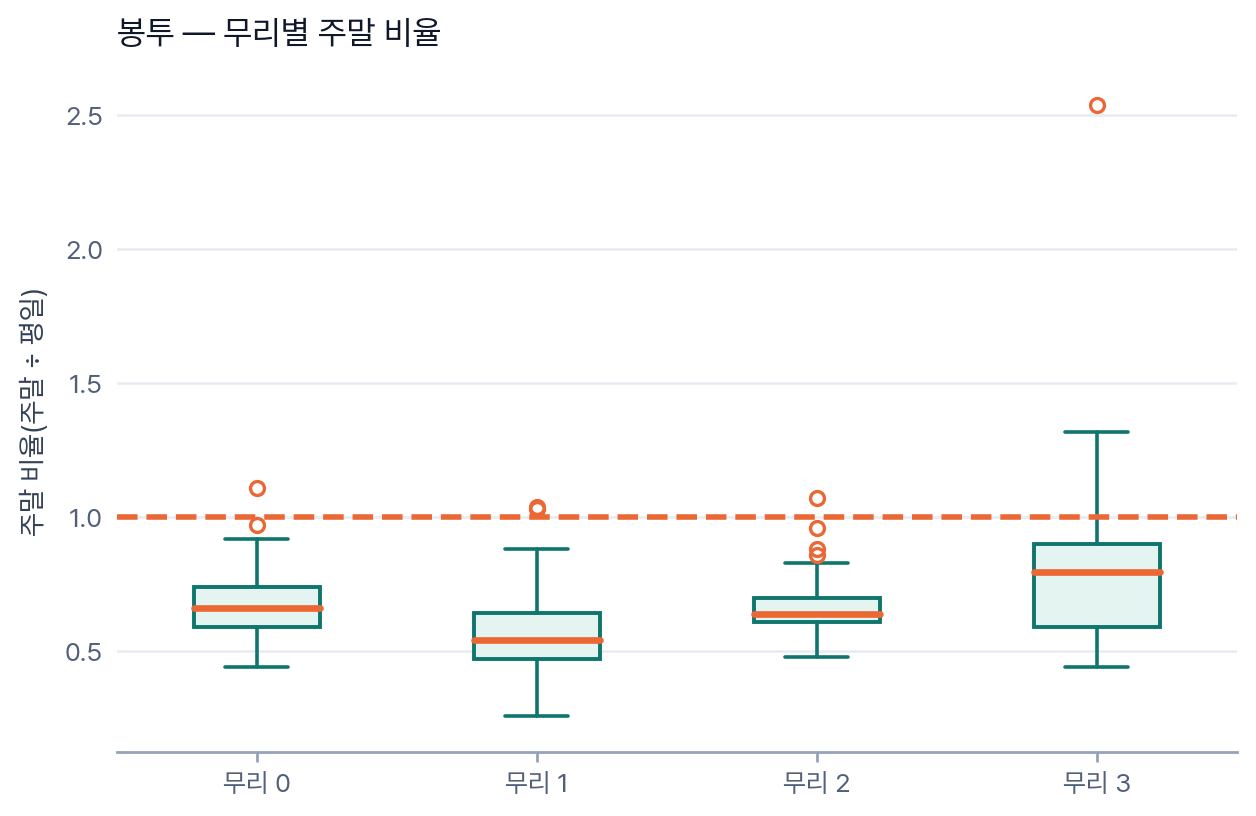
이름(사람이 붙인 것)역 수아래 1/4중앙값위 1/41 넘는 역
주거지형 무리 2920.610.640.701
업무지형 무리 1320.470.540.642
번화·대학가형 무리 3480.590.800.908
혼합형 무리 0670.590.660.741

봉투가 업무(0.54)와 번화·대학가(0.80)는 갈랐습니다 — 이름이 맞았다는 증거입니다. 그런데 주거(0.64)와 혼합(0.66)은 거의 같습니다. 봉투는 이 둘에 대해 아무 말도 하지 못합니다. 자료: 같은 파일 같은 달(2024-11) — 주말·공휴일 9일과 평일 21일의 하루 평균 승하차로 계산(원장 실측). 2024년 11월은 공휴일이 0일이다

그림 3상자로 보고, 겨루어 보고왼쪽 분포 · 오른쪽 한 역씩 뽑아 겨룬 승률
무리별 주말 비율가로: 주말 ÷ 평일 하루 평균 · 점선 1 = 주말도 평일만큼주거무리 2 · 92역0.641 을 넘는 역 1곳업무무리 1 · 32역0.541 을 넘는 역 2곳번화·대학가무리 3 · 48역0.801 을 넘는 역 8곳혼합무리 0 · 67역0.661 을 넘는 역 1곳0.51.01.52.02.5한 역씩 뽑아 겨루면두 무리에서 역을 하나씩 뽑았을 때 앞이 이길 확률번화·대학가 대 업무77%주거 대 업무74%혼합 대 업무72%혼합 대 주거52%50%60%70%80%50% = 동전 던지기 무리별 주말 비율가로: 주말 ÷ 평일 하루 평균 · 점선 1 = 주말도 평일만큼주거무리 2 · 92역0.641 을 넘는 역 1곳업무무리 1 · 32역0.541 을 넘는 역 2곳번화·대학가무리 3 · 48역0.801 을 넘는 역 8곳혼합무리 0 · 67역0.661 을 넘는 역 1곳0.51.01.52.02.5한 역씩 뽑아 겨루면두 무리에서 역을 하나씩 뽑았을 때 앞이 이길 확률번화·대학가 대 업무77%주거 대 업무74%혼합 대 업무72%혼합 대 주거52%50%60%70%80%50% = 동전 던지기

상자가 겹치면 두 무리가 갈리지 않는다는 뜻입니다. 그것을 숫자 하나로 만든 것이 오른쪽 겨루기예요 — 두 무리에서 역을 하나씩 뽑았을 때 앞쪽이 이길 확률입니다. 번화·대학가가 업무를 이길 확률은 77%, 혼합이 주거를 이길 확률은 52% — 동전 던지기와 거의 같습니다. 자료: 무리별 주말 비율 239개 값의 모든 짝을 견준 값(원장 실측)

봉투가 가른 짝 · 업무와 번화·대학가
0.54업무 중앙값
vs
0.80번화 중앙값
업무번화1

겨루기 77% — 이름이 한 예언이 맞았다.

봉투가 못 가른 짝 · 주거와 혼합
0.64주거 중앙값
vs
0.66혼합 중앙값
주거혼합1

겨루기 52% — 봉투가 못 가른다.

주거지형 · 출근 승차 배율을 만드는 법
1.37중앙값으로
→
1.50평균으로
중앙값 1.37평균 1.50

몇몇 역이 평균을 끌면 얼굴이 바뀐다.

업무지형 32역 가운데 이름을 배반한 역
0.54무리 중앙값
인데
1.04경복궁
업무 32역경복궁 1.041

주말에 더 붐빈다 — 오류가 아니다.

자료: 위 네 쌍의 숫자는 모두 3정거장 코드 ② · ③ · ④가 찍는 값과 같다 — 평균 배율(1.50)은 코드 ②의 도전에서 .median() 을 .mean() 으로 바꿔 찍는 값이다(원장 실측).

2-4이름은 해석이고, 꼬리표가 될 수 있다

'한산한 역'이라는 이름을 생각해 봅시다. 여기에는 규모만 들어 있고 성격은 없습니다. 게다가 우리는 구성비(몫)로 나누면서 규모를 이미 지웠으니, 이 이름은 우리 데이터가 대지 못하는 이름입니다. 반대로 '혼합형'은 "네 칸이 모두 1 언저리"라는 모양을 말하므로 근거를 댈 수 있습니다.

역이 아니라 동네나 사람을 묶을 때는 이 차이가 훨씬 무거워집니다. 이름이 곧 대우가 되기 때문입니다 — 집값 평가, 상권 등급, 순찰 배치. 그래서 군집 결과를 보고할 때는 이름만 적지 않고 이름이 서 있는 자리를 함께 적습니다.

이름을 붙이는 네 걸음 — 이 차례로

  1. 튀는 칸배율이 1에서 가장 먼 칸을 찾는다 — 1.25 이상이거나 0.80 이하
  2. 이름그 칸이 말하는 모양으로 이름을 짓는다 — 규모가 아니라 모양으로
  3. 증거군집에 쓰지 않은 자료로 그 이름의 예언을 채점한다
  4. 배반이름과 어긋난 역을 세고, 지우지 말고 보고서에 적는다

네 걸음 가운데 셋째가 가장 잘 빠집니다. 같은 자료로 이름을 짓고 같은 자료로 확인하면 언제나 맞는다고 나옵니다 — 그건 채점이 아니라 되풀이입니다.

규칙군집 결과를 보고할 때 함께 적는다 — 무리 크기 · 이름의 근거 칸 · 이름과 어긋나는 역 수 · 넣지 않은 속성(우리 자료에서는 규모와 주말).

체크포인트 2

이름이 배율표의 튀는 칸에서 나오고, 군집에 쓰지 않은 봉투가 그 이름을 채점한다는 것을 말할 수 있다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

이름을 붙이고, 봉투에게 채점받는다

오늘의 장비

열지도 — 표를 그림으로 읽는 matplotlib 함수

배율표는 숫자 16개짜리 작은 표입니다. 그런데 어느 칸이 튀는지를 눈으로 잡으려면 색이 빠릅니다. imshow 는 표를 그대로 격자 그림으로 칠해 줍니다. 처음 실행은 몇 초 멈춥니다 — matplotlib 과 scikit-learn 을 그 칸에서 처음 준비하는 중이에요(쪽마다 한 번).

부르는 모양

fig, ax = plt.subplots()
ax.imshow(배율.to_numpy(), cmap="ds_div",
          vmin=0, vmax=2, aspect="auto")
ax.text(c, r, f"{v:.2f}", ha="center")
plt.show()   # 출력 칸에 그림이 들어간다

오늘 쓰는 함수 넷

imshow
표를 칸 그림으로 — cmap 으로 색, vmin·vmax 로 눈금
set_xticklabels
칸 번호 자리에 이름을 단다
ax.text
칸마다 숫자를 직접 얹는다
groupby
무리마다 통계 하나로 — .median()

열지도를 읽을 때 지킬 셋

  1. 가운데가 1vmin=0, vmax=2 — 1이 한가운데 오게 눈금을 잡는다
  2. 숫자를 함께색만으로는 1.47과 1.82를 못 가른다 — ax.text 로 값을 얹는다
  3. 색은 두 방향ds_div 는 많다/적다 두 방향뿐 — 무지개 색표를 쓰지 않는다

대가 — 색은 눈금을 어디에 잡느냐에 따라 같은 표가 달라 보입니다(7차시의 축 이야기와 같습니다).

1

7차시와 같은 코드로 다시 나누고, 얼굴을 본다

2분

코드 ①은 7차시와 똑같은 코드(구성비 표 · KMeans(n_init=10, random_state=0))로 다시 나눕니다. 같은 데이터·같은 씨앗이니 무리 크기도 같아야 합니다. 그리고 그림이 나오기 전에 하나 짐작해 두세요 — '밤에 붐비는' 무리의 가운데 역은 하루 중 언제 가장 많이 내릴까요?

기본 코드 ①은 채워져 있습니다. K = 4 는 7차시에서 고른 값이에요 — 다른 k를 골랐다면 그 값으로 바꿔 ▶ 실행하세요.

도전 K 를 3이나 5로 바꿔 보세요. 무리 크기가 통째로 달라지고 봉우리 시각도 바뀝니다 — 같은 자료인데 얼굴이 몇 개인지가 사람이 고른 값에 달려 있습니다.

탐구 .median() 자리를 .mean() 으로 바꿔 곡선을 다시 그려 보세요. 어느 무리의 봉우리가 가장 크게 움직이나요? 그 무리에 무엇이 들어 있을까요?
2

배율표와 열지도 — 이름이 나올 칸을 찾는다

4분

하루 40칸을 네 칸으로 줄이고 239역 중앙값으로 나눕니다. 1에서 가장 먼 칸은 어느 무리의 무엇일까요? 그림 1의 곡선을 떠올리며 하나만 짚어 두세요.

기본 빈칸 ①에 무리마다 네 칸의 중앙값을 내는 함수 이름을 채우고 ▶ 실행합니다. 묶음.groupby(무리) 뒤에 올 것 하나입니다.

도전 .median() 을 .mean() 으로 바꿔 보세요. 주거지형의 출근 승차가 1.37 → 1.50 으로 오르고, 혼합형의 출근 하차는 1.15 → 0.96 으로 1 아래까지 내려갑니다. 평균으로 만든 배율표는 다른 이름을 붙이게 할 수 있습니다. 이 갈림을 확인 문제 5에 적어 제출 →

탐구 칸을 네 개로 자른 것은 사람입니다(출근 7~9시 · 퇴근 18~20시 · 밤 21시~막차). 점심 시간이나 주중 오후 칸을 하나 더 만들면 어느 무리가 새로 튈까요? 칸 딕셔너리에 한 줄을 더해 보세요.

무리 의 이름은 이고, 그 근거는 칸의 배율 배다. 이 배율이 말하는 것은 이고, 말하지 않는 것은 이다.

확인 문제 1에 적어 제출 →
3

실험실 — 이름에 띠를 걸고 봉투를 뜯는다

5분

이름을 붙이기 전에 한 가지만 정해 두세요. '업무지형'이라는 이름이 맞다면 그 무리 역들의 주말 비율은 1보다 클까요, 작을까요? 그리고 얼마나 좁은 구간 안에 들어갈까요? 실험실에서 그 구간을 띠로 걸게 됩니다 — 좁게 걸수록 맞혔을 때 점수가 큽니다.

아래 실험실에서 1막 → 2막 → 3막을 합니다. 띠란 "이 이름이 맞다면 주말 비율이 이 사이에 있을 것이다"라고 미리 걸어 두는 구간입니다. 봉투는 군집에 쓰지 않은 주말 비율 239개예요. 열지도에서 튀는 칸을 눌러 이름을 주고, 이름마다 띠를 걸어 잠근 다음, 봉투를 뜯습니다. (0막 몸풀기 한 장은 선생님과 함께 먼저 풀어 봅니다.)

시뮬레이터

봉인된 주말

이름에 띠를 걸고, 군집에 쓰지 않은 증거로 채점받는다

  1. 1열지도에서 튀는 칸을 눌러 무리에 이름을 준다
  2. 2이름마다 띠를 걸어 잠근다 — 좁을수록 점수가 크다
  3. 3봉투를 뜯어 채점받고, 겨루고, 튄 역을 가른다
막
무리 수 k — 7차시에서 고른 값
몸풀기 — 내 답을 잠근다
① 고른 무리에 이름 주기
② 띠 걸기 — 무리를 고르세요
③ 봉투
④ 이 이름 대 저 이름
—
—
—
보고 카드로 옮기기
0막 · 몸풀기밤에 붐비는 무리는 언제 가장 많이 내릴까?

튀는 칸 = 배율이 1.25 이상이거나 0.80 이하인 칸 · 띠 점수 = 내 띠와 봉투의 가운데 절반(아래 1/4 ~ 위 1/4)이 겹친 길이 ÷ 둘을 합친 길이 × 100 — 좁게 걸어 맞힐수록 높다 · 주장 ○ = 봉투의 중앙값이 내 띠 안에 들어옴

튄 역 = ① 주말 중앙값이 가장 낮은 무리에서 주말 비율이 가장 높은 역 둘 + ② 제 무리 중앙값에서 가장 멀리 벌어진 역 하나 · 판정은 7차시 실루엣 s — s ≥ 0.25 두 쓰임 · 0 ≤ s < 0.25 경계 · s < 0 이름이 안 맞음

봉투가 맞다고 한 이름—/ 4
붙인 이름0
띠 점수 평균—
겨루기—
튄 역 판정0/3
별0
도전 1

봉투를 뜯은 뒤 4막에서 가장 잘 가르는 짝과 가장 못 가르는 짝을 둘 다 찾아 맞대어 보라 — 승률은 각각 몇 %인가?

도전 2

띠를 좁게 걸고도 이름 셋 이상을 ○ 로 맞혀라 — 그러면서 띠 점수 평균 40점을 넘겨라.

도전 3

k 를 2 로 바꿔 보라. 7차시에서 실루엣 점수가 가장 높았던 나눔이다 — 봉투는 그 두 무리를 얼마나 가르는가?

자료: 서울교통공사, 역별 일별 시간대별 승하차인원 정보(2024), 공공데이터포털(15048032), 이용허락범위 제한 없음 — 2024년 11월 · 239역 × (네 칸 값 · 주말 비율 · k=2~6 무리 번호 · 7차시 실루엣)을 쪽 안에 실었다. 판의 숫자는 3정거장 코드 ② · ③ · ④가 찍는 값과 같다(원장 실측).

봉투는 와 를 갈랐지만, 와 는 가르지 못했다. 가르지 못했다는 것은 는 뜻이지 는 뜻이 아니다.

확인 문제 2에 적어 제출 →
4

아는 역은 어느 무리에 · 봉투를 코드로 잇는다

4분

여의도 · 강남 · 홍대입구 · 신림 · 서울역. 다섯 곳이 각각 어느 무리에 들었을지 먼저 짚어 보세요. 그리고 하나 더 — 번화·대학가형의 주말 비율 중앙값은 1을 넘을까요? "주말에도 붐비는 곳"이라면 넘어야 할 텐데요.

기본 빈칸 ②에 두 표를 역 이름으로 잇는 인자를 채웁니다 (Ⅰ-7에서 한 그대로 — 봉투 표와 on=). 짝을 못 찾은 역 수부터 확인하세요. 0곳이 아니면 이은 결과를 믿으면 안 됩니다.

도전 quantile 자리에 [0.1, 0.5, 0.9] 를 넣어 보세요. 가운데 절반 대신 바깥 10%까지 보면 무리끼리 얼마나 겹치는지 달라 보입니다 — 같은 자료라도 어디를 잘라 보느냐가 결론을 바꿉니다.

탐구 강남이 '업무지형'이 아니라 번화·대학가형(무리 3)에 들어간 것이 뜻밖일 수 있습니다. 출근 하차 몫이 24%로 여의도(50%)의 절반뿐이에요. 강남에는 일터 말고 무엇이 더 있을까요?

번화·대학가형의 주말 비율 중앙값은 로 1을 . 그래도 업무지형()보다는 확실히 높다. 그러니 “주말에 붐빈다”가 아니라 라고 적어야 한다.

확인 문제 3에 적어 제출 →
5

이름을 배반한 역을 찾고, 보고 카드를 쓴다

5분

업무지형 32역 가운데 주말에 가장 붐비는 역은 어디일까요? 서울에서 "평일엔 직장인, 주말엔 다른 사람들"이 오는 동네를 하나 떠올려 보세요.

기본 코드 ④는 채워져 있습니다. 볼무리 = 1 은 내가 '업무지형'이라 부른 무리 번호예요 — 다른 번호에 그 이름을 붙였다면 바꿔서 ▶ 실행하세요.

도전 맨 아래 겨루기에서 무리 == 3 자리를 0이나 2로 바꿔 보세요. 주거 대 업무 74% · 혼합 대 업무 72% · 혼합 대 주거 52% 가 나옵니다.

탐구 이름표만 믿고 결정하면 어떻게 될까요? 가상의 시청이 세 가지를 요청합니다 — "가장 업무지형다운 역 12곳을 골라 달라". 코드 ⑤는 그렇게 고른 12곳이 요청이 정말 원한 값을 얼마나 잘 맞혔는지 점수로 냅니다 (0% = 눈 감고 고른 것, 100% = 가장 잘 고른 것).

요청 목록 요청 의 (3, "주말비율") 을 (1, "주말비율") 로 바꿔 보세요. −23% 가 나옵니다 — 업무 이름표로 주말 붐빔을 고르면 눈 감고 고른 것보다 나쁩니다.

이제 실험실로 돌아가 4막과 5막을 합니다 — 두 이름을 맞대어 승률을 걸어 보고, 이름을 배반한 역 셋을 두 쓰임 · 경계 · 이름이 안 맞음 세 상자로 가릅니다. 판정은 7차시의 실루엣이 합니다. ↑ 실험실 「봉인된 주말」로 올라가기

그다음 실험실 결과판의 [성적표 복사]를 눌러 확인 문제 6의 보고 카드에 붙여 넣으세요. 확인 문제 6 보고 카드로 →

경복궁(주말 )은 업무지형 중앙값 에서 크게 벗어났지만 가 아니다. 이런 역을 보고서에서 대신 해야 한다.

확인 문제 4에 적어 제출 →
체크포인트 3

이름 넷을 근거와 함께 붙였고, 군집에 쓰지 않은 봉투로 채점받았고, 이름을 배반한 역을 세 갈래로 갈랐다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

  1. 찾은 것

    이름은 데이터가 주지 않는다. 배율이 튀는 칸에서 사람이 세우는 가설이고, 근거 칸과 배율을 함께 적어야 이름이 된다.

  2. 도구의 한계

    같은 자료로 이름을 짓고 같은 자료로 확인하면 언제나 맞는다고 나온다. 군집에 쓰지 않은 증거라야 채점이 된다 — 그마저도 업무와 번화는 갈랐지만 주거와 혼합은 못 갈랐다.

  3. 보고의 규칙

    이름 옆에 넷을 적는다 — 무리 크기 · 근거 칸 · 이름과 어긋나는 역 · 넣지 않은 속성. 어긋나는 역은 지우지 않는다.

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. 다른 도시의 지하철 역들을 오늘과 같은 방법으로 나누었더니, 어느 무리의 배율이 출근 하차 4.6 · 퇴근 승차 2.4 · 출근 승차 0.2 로 나왔다. ① 이 무리에 이름을 붙이고 근거를 쓰시오. ② 오늘 우리 자료의 무리 1(출근 하차 2.44 · 퇴근 승차 2.27 · 출근 승차 0.19)과 같은 이름을 붙여도 되는지, 두 배율의 크기(4.6과 2.44)를 직접 견줄 수 있는지와 함께 쓰시오.
📖 모범 답안

① 업무지형. 아침에 내리는 사람이 보통 역의 네 배 반이 넘고, 저녁에 타는 사람이 두 배가 넘는데 아침에 타는 사람은 다섯 분의 일밖에 안 된다. 사람이 아침에 들어왔다가 저녁에 빠져나가는 곳 — 일터가 몰린 동네의 하루 모양이다.

② 같은 이름을 붙여도 된다. 모양(아침 하차 ↑ · 퇴근 승차 ↑ · 아침 승차 ↓)이 같기 때문이다. 그러나 4.6과 2.44를 직접 견주어 "저쪽이 더 업무지형답다"고 말할 수는 없다. 배율의 분모가 그 도시의 보통 역이라서 도시마다 다르기 때문이다. 일터가 한곳에 몰린 도시일수록 보통 역의 출근 하차가 커져 오히려 배율이 작게 나올 수도 있다. 도시끼리 견주려면 분모를 맞추거나, 배율 대신 원래 몫(%)을 나란히 놓아야 한다.

2. 네 칸 배율이 모두 1 언저리(0.97 ~ 1.15)인 무리 0 에 대해 답하시오. ① 이 무리를 '평범한 역'이라 부르면 무엇이 문제인가, 더 나은 이름은 무엇인가? ② 봉투(주말 비율)는 이 무리와 주거지형을 갈랐는가? 숫자를 들어 답하고, 갈라지지 않았다는 것이 무슨 뜻인지 한 줄 덧붙이시오.
📖 모범 답안

① 배율이 고르다는 것은 한쪽으로 치우치지 않았다는 뜻이지 '평범하다'는 평가가 아니다. 게다가 우리는 구성비(몫)로 나누면서 규모를 이미 지웠으므로 '평범하다·한산하다' 같은 크기 이름은 이 자료가 근거를 댈 수 없는 이름이다. 주거와 일터가 섞인 동네이거나 사람이 계속 드나드는 큰 환승역일 수 있다 — '혼합형'처럼 모양을 말하는 이름이 근거에 맞는다.

② 갈라지지 않았다. 주말 비율 중앙값이 주거 0.64 · 혼합 0.66 으로 거의 같고, 두 무리에서 역을 하나씩 뽑아 겨룬 승률도 52% 로 동전 던지기와 다르지 않다. 이것은 두 무리가 같다는 뜻이 아니라 이 증거로는 가를 수 없다는 뜻이다. 가르려면 다른 증거가 필요하다 — 예를 들어 역 둘레의 건물 용도나, 그 역이 환승역인지 같은 정보다.

3. "이 군집 결과로 주말 문화 행사를 열 역을 고르자"는 제안이 나왔다. 봉투 결과와 코드 ⑤의 결재 성적을 근거로 이 제안을 판단하시오.
📖 모범 답안

군집은 평일 21일의 하루 모양으로 나눈 것이라 주말 붐빔을 아예 재지 않았다. 봉투를 열어 보면 주말 비율이 가장 높은 무리는 번화·대학가형(중앙값 0.80, 1을 넘는 역 8곳)이므로 후보로 삼을 수는 있다.

그러나 이름표로 고르면 성적이 나쁘다. 코드 ⑤에서 '가장 번화·대학가형다운 역 12곳'을 뽑아 주말 비율을 고른 결재 성적은 12% 였다(0% = 눈 감고 고른 것, 100% = 가장 잘 고른 것). 같은 방식으로 업무지형 12곳을 뽑아 군집에 넣은 속성인 출근 하차를 고르면 68% 다 — 이름표는 넣은 속성은 잘 고르고 넣지 않은 속성은 못 고른다.

그러니 행사가 목적이라면 주말 비율 자체를 기준으로 역을 고르는 편이 곧다. 군집은 "어디를 볼까"를 좁히는 데 쓰고, 고르는 자는 목적이 재는 값이어야 한다.

4. '업무지형'이라 이름 붙인 무리에서 주말 비율이 1 언저리인 역이 나왔다 — 경복궁 1.04 · 여의나루 1.03. ① 이 역들을 어떻게 다루겠는가? ② 실험실 5막은 이런 역을 두 쓰임 · 경계 · 이름이 안 맞음 셋으로 가른다. 무엇을 보고 가르는지, 세 갈래가 각각 무슨 뜻인지 쓰시오.
📖 모범 답안

① 오류로 지우지 않는다. 평일에는 직장인이, 주말에는 다른 사람들이 오는 곳일 수 있다 — 경복궁은 궁궐, 여의나루는 한강공원, 안국(0.88)은 북촌이다. 둘레에 두 쓰임이 겹친 역이라 한 이름이 다 담지 못하는 것이다. 이름은 다수의 성격이며 예외가 있다는 것을 보고서에 적고, 필요하면 k를 늘려 따로 볼지 판단한다.

② 가르는 기준은 7차시의 실루엣이다 — 그 역이 제 무리 안에 얼마나 깊이 들어와 있는지를 재는 값이다.

두 쓰임(실루엣 0.25 이상): 하루 모양으로는 제 무리 한가운데인데 봉투만 어긋난다. 여의나루가 그렇다(0.344) — 평일 모양은 완전히 업무지형인데 주말에 한강공원이 열린다.

경계(0 이상 0.25 미만): 무리 가장자리에 있어 옆 무리와 반반이다. 경복궁(0.109)과 안국(0.148)이 그렇다.

이름이 안 맞음(0 미만): 제 무리보다 다른 무리에 더 가깝다. 번화·대학가형에 들어간 월드컵경기장(−0.074)이 그렇고, 주말 비율이 2.54 로 239역 가운데 가장 높다. 이런 역은 예외로 적는 데 그치지 말고 나눔 자체를 다시 볼 신호로 읽는다.

5. 배율표를 중앙값이 아니라 평균으로 만들면 두 칸이 크게 갈린다 — 혼합형의 '출근 하차'는 1.15 → 0.96, 주거지형의 '출근 승차'는 1.37 → 1.50. ① 이 갈림에서 무엇을 의심해야 하는가? ② 무리의 얼굴을 읽을 때 어느 쪽을 쓰겠는가, 그 까닭은?
📖 모범 답안

① 몇몇 역이 평균을 끌고 있다고 의심해야 한다. 그런데 배율은 나눗셈이므로 끌림이 두 곳에서 생긴다 — 무리 안(분자)과 239역 전체(분모) 양쪽이다.

혼합형의 출근 하차가 1 아래로 내려간 것은 무리 안이 변해서가 아니라, 분모가 올라갔기 때문이다. 239역 전체의 출근 하차 평균이 업무지형 몇 곳(배율 2.44)에 끌려 중앙값보다 높아지면, 그 큰 분모로 나눈 다른 무리의 배율은 모두 작아진다. 주거지형의 출근 승차가 오른 것은 그 반대다 — 아침에 타는 사람이 거의 없는 역들(배율 0.19)이 분모의 평균을 끌어내리면 남은 무리의 배율이 커진다. 즉 어느 한 무리의 튀는 값이 모든 무리의 배율을 흔든다.

② 중앙값을 쓴다. 무리의 '대표 얼굴'은 가운데 있는 역의 모습이어야 하고, 중앙값은 몇 곳이 아무리 멀리 있어도 거의 움직이지 않는다. 평균표는 버리는 것이 아니라 함께 보고 두 표가 크게 갈리는 칸을 찾는 데 쓴다 — 갈리는 칸이 곧 따로 살펴야 할 역이 있는 칸이다.

6. 실험실 결과판의 [성적표 복사]로 받은 내용을 아래 보고 카드에 채우시오. 그리고 이 군집 결과를 보고서에 실을 때 이름 말고 무엇을 함께 적어야 하는지, 왜 그것이 필요한지 쓰시오.
무리내가 붙인 이름근거 칸 · 배율봉투 판정이름을 배반한 역
무리 0 67역
무리 1 32역
무리 2 92역
무리 3 48역
📖 모범 답안

보고 카드(예) — 무리 0 혼합형 / 튀는 칸 없음(0.97~1.15) / 못 가림(0.66, 주거 0.64와 겨루기 52%) / —. 무리 1 업무지형 / 출근 하차 2.44배 · 퇴근 승차 2.27배 / ○(0.54, 가장 낮음) / 경복궁 1.04 · 여의나루 1.03. 무리 2 주거지형 / 출근 승차 1.37배 / 못 가림(0.64) / —. 무리 3 번화·대학가형 / 밤 승차 1.82배 · 출근 하차 1.50배 / ○(0.80, 1 넘는 역 8곳) / 월드컵경기장 2.54(실루엣 −0.074).

이름 말고 함께 적을 것 넷

무리 크기 — 32역짜리 이름과 92역짜리 이름은 무게가 다르다. 크기를 모르면 읽는 사람이 "서울 지하철은 업무지형이다" 처럼 작은 무리를 전체로 읽는다.

이름의 근거 칸과 배율 — 칸을 못 대는 이름은 인상이다. 근거를 적어야 읽는 사람이 내 이름에 동의하지 않을 수 있고, 그게 있어야 검증이 된다.

이름과 어긋나는 역의 수 — 이름은 다수의 성격이지 전부가 아니다. 예외를 적지 않으면 나중에 그 역을 보는 사람이 데이터가 틀렸다고 여긴다.

넣지 않은 속성 — 우리는 규모(구성비로 나누며 지웠다)와 주말(봉투로 빼 두었다)을 넣지 않았다. 이것을 적지 않으면 이름표가 "그 역에 대해 다 말해 준다"고 읽힌다. 코드 ⑤가 보인 대로, 이름표에 없는 축으로 고르면 결재 성적이 12% 까지 떨어진다.

+
더 알아보기

이름 밖의 이야기 셋

① 개찰구를 지나면 — 표에 자국이 남는다길거리사람 100개찰구승차 인원 +100이 차시의 표에 들어간다② 역 안에서 갈아타면 — 자국이 없다2호선 승강장사람 100개찰구를 지나지 않는다표에 0환승은 모양을 남기지 않는다③ 그래서 큰 환승역이 한 무리로 서지 않는다혼합형으로사당신도림왕십리번화·대학가형으로교대종로3가서울역고속터미널
현장

환승역은 왜 한 무리로 서지 않았나

오늘 자료에서 이상한 일이 하나 있었습니다. 서울에서 가장 붐비는 환승역들이 한 무리로 모이지 않았어요. 사당·신도림·왕십리는 혼합형으로, 교대·종로3가·서울역·고속터미널은 번화·대학가형으로 흩어졌습니다. '환승형'이라는 이름은 어느 칸에서도 나오지 않았습니다.

까닭은 데이터가 만들어지는 자리에 있습니다. 교통카드 기록은 개찰구를 지난 사람만 셉니다. 2호선에서 내려 같은 역 안에서 4호선으로 갈아탄 사람은 개찰구를 다시 지나지 않으므로, 이 표에 아무 자국도 남기지 않습니다. 그 역의 하루 모양에는 '환승'이 보이지 않는 것이지요.

그래서 "환승형이 없다"는 결론은 서울에 환승역이 없다는 뜻이 아니라 이 자료가 환승을 재지 않는다는 뜻입니다. 군집이 못 찾은 것을 두고 "데이터에 그런 무리는 없다"고 말하기 전에, 그 성질이 애초에 기록되는 자리에 있었는지를 먼저 물어야 합니다.

도해: 개찰구를 지난 사람과 역 안에서 갈아탄 사람이 표에 남기는 자국을 세 칸으로 그렸다. 환승역 이름은 우리 자료에서 실제로 그 무리에 들어간 역이다(원장 실측).

아침 — 둘레에서 가운데로도심여의도강남저녁에는 화살표가 모두 반대로 — 같은 역에서 아침엔 내리고 저녁엔 탄다업무지형 32역의 큰 역: 선릉 · 삼성 · 시청 · 역삼 · 을지로입구 · 광화문 · 여의도● 둘레 = 집 · ◼ 가운데 = 일터
배경

직주분리 — 도시가 만든 거울 모양

무리 2와 무리 1의 하루가 거울처럼 뒤집혀 있던 것을 기억하나요? 이것은 우연이 아니라 도시가 생긴 모양이 만든 결과입니다. 서울의 일자리는 도심(시청·광화문) · 여의도 · 강남 세 곳에 크게 몰려 있고, 집은 그 둘레로 넓게 퍼져 있습니다. 사는 곳과 일하는 곳이 떨어져 있다는 뜻에서 직주분리라고 부릅니다.

그래서 아침에는 사람이 둘레에서 가운데로, 저녁에는 가운데에서 둘레로 흐릅니다. 같은 도시 안에서 어떤 역은 아침에 사람을 뱉고 어떤 역은 삼키는 것이지요. 우리가 찾은 업무지형 32역(선릉 · 삼성 · 시청 · 역삼 · 을지로입구 · 광화문 · 여의도 …)을 노선도 위에 짚어 보면 이 세 덩어리 안에 거의 다 들어갑니다.

여기서 한 걸음 더 나아갈 수 있습니다. 군집이 찾아 준 무리가 이미 알려진 도시 구조와 겹친다면, 그건 분석이 실패한 게 아니라 분석이 말이 된다는 증거입니다. 반대로 알려진 구조와 전혀 다른 무리가 나왔다면, 새 발견이거나 자료의 결함이거나 — 둘 중 하나를 가려야 합니다.

도해: 둘레의 집과 가운데 세 일자리 덩어리, 아침의 흐름을 모식도로 그렸다(지도가 아니라 구조 그림). 업무지형에 들어간 역 이름은 원장 실측이다.

① 우편번호로 동네를 묶고 유형 이름을 붙인다CABAABBABBBAACBBABCBABCBCCABABCBA · B · C 는 계산이 만든 번호일 뿐이다② 번호에 말이 붙는다여유로운 전원형성장하는 신혼형쇠퇴하는 노후형③ 말이 대우가 된다집값 평가상권 등급순찰 배치
윤리

동네를 묶는 분류, 사람에게 붙는 꼬리표

우리는 오늘 역에 이름을 붙였습니다. 같은 일을 동네와 사람에게 하는 산업이 있습니다. 우편번호 단위로 가구의 소득·나이·소비 기록을 묶어 '생활양식 유형'으로 나누는 지오데모그래픽 분류가 그것입니다. 광고를 어디에 뿌릴지, 매장을 어디에 낼지 정할 때 쓰입니다.

문제는 계산이 내놓은 것이 A·B·C 같은 번호뿐인데, 그 번호에 사람이 말을 붙인다는 데 있습니다. '여유로운 전원형' 같은 이름은 칭찬처럼 들리고, '쇠퇴하는 노후형' 같은 이름은 그 자체로 판정처럼 들립니다. 그리고 그 말이 한 번 붙으면 대우로 이어집니다 — 집값 평가, 상권 등급, 순찰 배치. 데이터가 동네를 설명하려고 만든 이름이 동네의 조건을 바꾸는 고리가 되는 것이지요.

오늘 배운 네 걸음이 여기서도 그대로 씁니다. 이름의 근거 칸을 대고, 분류에 넣지 않은 속성을 밝히고, 어긋나는 사례를 세어 적는 것. 그리고 하나 더 — 역과 달리 사람에게는 자기에게 붙은 이름을 알고 반박할 권리가 있습니다.

도해: 계산이 나눈 유형 번호(A·B·C)에 말이 붙고, 그 말이 대우로 이어지는 세 단계를 그렸다. 칸의 배치는 설명을 위한 예시다.