단원 홈

Ⅲ. 데이터 모델링과 평가7차시

몇 무리로
나누면 좋을까

안은 가깝게, 사이는 멀게

6차시에서 만든 지하철 239개 역의 하루 모양을 이번에는 무리로 묶습니다. 군집이 노리는 것은 둘 — 무리 안은 가깝게, 무리 사이는 멀게 — 이고, 이 둘을 한 숫자로 묶은 것이 실루엣입니다. 그 숫자를 손으로 계산해 보고, 점수가 가장 높은 나눔이 가장 쓸모없을 수도 있다는 것을 봅니다.

  • [12데과03-03]
  • 50분네 정거장
  • 새 도구KMeans · 실루엣
  • 자료서울 지하철 239역 × 시간대 40칸
Ⅲ 단원 지도7 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    군집이 노리는 두 가지를 무리 안 평균 거리 · 무리 사이 평균 거리 · 실루엣 세 숫자로 재어 말할 수 있다.

  2. 손으로

    k 를 2~6 으로 바꿔 세 숫자를 견주고, 한 역의 실루엣을 a · b 로 직접 계산해 도구 값과 맞댈 수 있다.

  3. 확인에서

    자기 k 를 고르고 그 근거를 숫자 둘 이상과 무리 크기로 적을 수 있다.

1
여는 장면 · 5분

점수가 더 높은 나눔 — 좋은 나눔인가

6차시에서 만든 표가 둘 있습니다. 하나는 역마다 시간대별 인원을 그대로 담은 표, 다른 하나는 그 인원을 하루 합으로 나눠 구성비로 바꾼 표입니다. 두 표를 각각 k-평균에 넣어 두 무리로 나누고, 나눔의 점수를 실루엣이라는 숫자로 재어 보았습니다.

점수는 인원 그대로 쪽이 높습니다 — 0.612 대 0.507. 숫자만 보면 이쪽이 더 잘 나눈 것입니다. 그런데 무리 크기를 보면 한쪽이 47역뿐이고, 그 47역은 잠실 · 강남 · 서울역 · 사당 · 홍대입구 · 고속터미널 … 가장 붐비는 역들입니다.

하루 승하차 중앙값이 87,112명과 26,710명으로 갈렸습니다. 이 나눔이 찾은 것은 '역의 유형'일까요, 아니면 그냥 큰 역과 작은 역일까요?

인원 그대로k = 2 · 실루엣 0.612
두 무리의 하루 승하차점 하나 = 역 하나 · 굵은 선 = 중앙값작은 무리 47역중앙값 87,112명큰 무리 192역중앙값 26,710명05만10만15만20만하루 승하차(명)
작은 무리 47역큰 무리 192역

자료: 코드 ②가 찍는 값과 같다(원장 실측).

표 1인원 그대로 나눴을 때 — k 를 2 · 3 · 4 로실루엣은 1 에 가까울수록 높다
k실루엣무리 크기(큰 순)가장 작은 무리
20.612192 · 4747역
30.552182 · 44 · 1313역
40.530165 · 33 · 26 · 1515역

셋 다 실루엣이 0.5 를 넘습니다. 그런데 k 가 커질수록 한쪽이 아주 작아집니다 — 점수는 높은데 '유형'이라고 부르기는 점점 어려워집니다. k=2 의 작은 무리 47역은 잠실 · 강남 · 서울역 · 사당 · 홍대입구 · 고속터미널 … 하루 승하차가 가장 많은 역들입니다. 자료: 서울교통공사, 역별 일별 시간대별 승하차인원 정보(2024), 공공데이터포털(15048032), 이용허락범위 제한 없음 — 2024년 11월 평일 하루 평균으로 가공 · 3정거장 코드 ②의 출력값

먼저 예측

구성비 표로 나누면 점수는 더 낮습니다(0.507). 그런데도 우리는 구성비 표를 씁니다. 왜 낮은 점수 쪽을 고를 수 있는지 한 문장으로 짐작해 적어 보세요. 2정거장의 실험실과 3정거장의 코드 ②가 그 짐작을 시험합니다.

체크포인트 1

점수가 높은 나눔(0.612)과 우리가 쓸 나눔(0.507)이 다르다는 것을 보았고, 그 까닭을 한 문장으로 적어 두었다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

안은 가깝게, 사이는 멀게 — 그리고 그것을 한 숫자로

2-1군집이 노리는 두 가지

군집이 하려는 일은 한 문장으로 적을 수 있습니다 — 같은 무리에 든 것끼리는 닮게, 다른 무리끼리는 다르게. 교육과정은 이것을 군집 내 유사성과 군집 간 상이성이라고 부릅니다. 닮음을 거리로 재기로 한 6차시 뒤라, 이 두 말은 그대로 두 숫자가 됩니다.

무리 안 평균 거리는 같은 무리에 든 역 쌍의 거리를 모두 평균한 것이고(작을수록 뭉쳤다), 무리 사이 평균 거리는 다른 무리에 든 역 쌍의 거리를 평균한 것입니다(클수록 갈렸다). 그러니 '안'은 작게, '사이'는 크게 — 그것이 좋은 나눔입니다.

그런데 '안'만 보고 k 를 고르면 늘 가장 큰 k 가 이깁니다. 무리를 잘게 쪼갤수록 한 무리에 남는 역은 서로 더 닮은 것들뿐이니까요. 239개 무리로 나누면 '안'은 0 이 됩니다 — 한 무리에 한 역뿐이라 잴 쌍이 없습니다.

Ⅲ-6 에서 가져옴여기 쓰는 구성비 표와 거리표는 6차시에서 만든 그대로입니다. 역마다 승차 20칸을 승차 합으로, 하차 20칸을 하차 합으로 나눠 하루의 모양만 남긴 표이고, 거리는 그 40칸 사이의 pairwise_distances 입니다.

2-2실루엣 — 두 거리의 견줌을 한 숫자로

'안'과 '사이'는 나눔 전체를 두 숫자로 말합니다. 그런데 우리가 정말 알고 싶은 것은 이 역이 제 무리에 잘 들어갔나입니다. 그래서 역 하나마다 두 거리를 잽니다.

a = 그 역에서 제 무리의 다른 역들까지 평균 거리(자기 자신은 뺍니다). b = 가장 가까운 남의 무리의 역들까지 평균 거리. 무리가 넷이면 남의 무리 셋 가운데 가장 가까운 하나를 고릅니다.

이 둘을 견준 것이 실루엣입니다.

식s = (b − a) ÷ (a 와 b 가운데 큰 것) — 1 에 가까우면 제 무리에 잘 붙었고, 0 이면 경계에 섰고, 음수면 남의 무리에 더 가깝다는 뜻입니다.

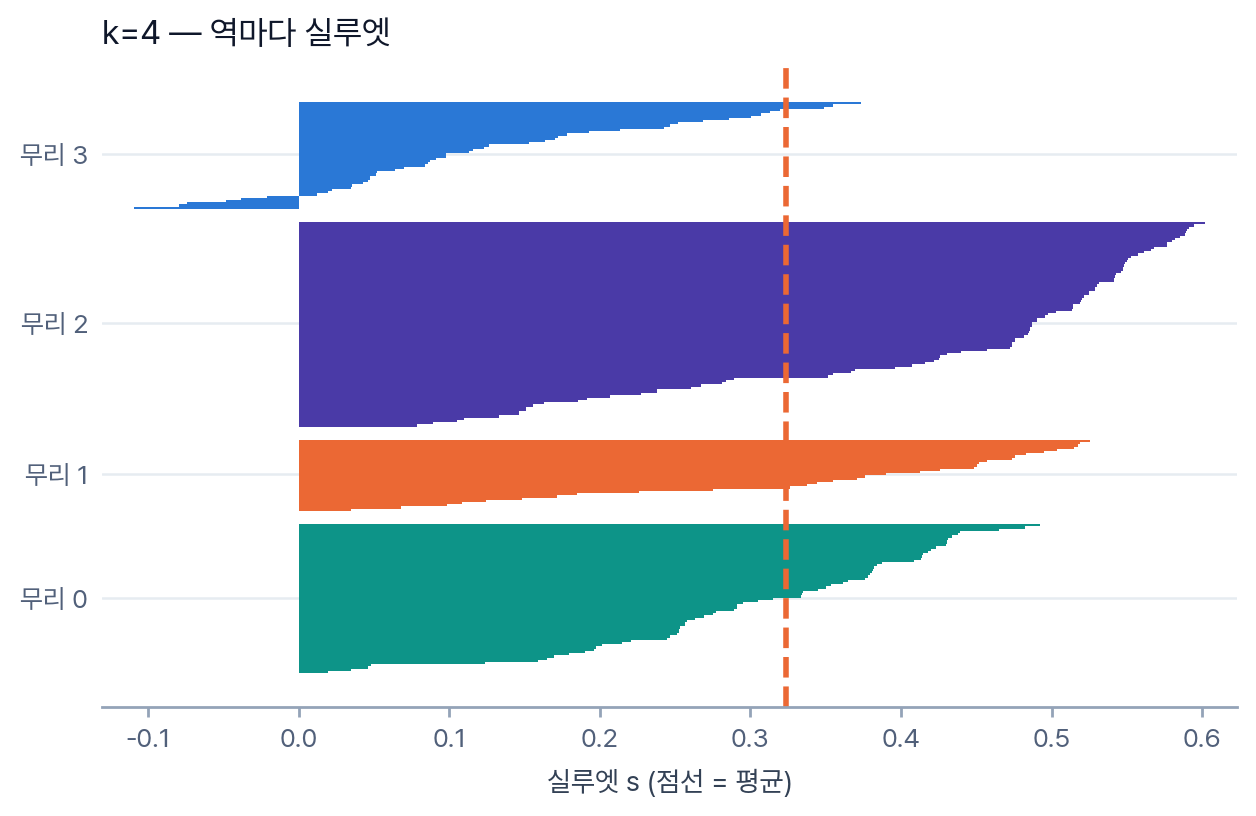
239개 s 를 모두 평균한 것이 그 나눔의 실루엣 점수입니다. 구성비 표를 네 무리로 나눈 지금 나눔의 점수는 0.324 입니다. 그런데 이 평균 한 숫자는 s 가 음수인 역이 6곳, 0.1 아래인 역이 34곳이라는 것을 말해 주지 않습니다.

그림 1실루엣 과녁 — 신림과 강남안쪽 청록 고리 a · 바깥 주황 점선 고리 b
신림 — 제 무리 2두 고리의 차이가 곧 실루엣a 0.090b 0.181신림a 제 무리까지 평균 거리b 가장 가까운 남의 무리까지s = (b − a) ÷ 둘 중 큰 것= (0.181 − 0.090) ÷ 0.1810.503제 무리에 잘 붙었다강남 — 제 무리 3두 고리의 차이가 곧 실루엣a 0.139b 0.154강남a 제 무리까지 평균 거리b 가장 가까운 남의 무리까지s = (b − a) ÷ 둘 중 큰 것= (0.154 − 0.139) ÷ 0.1540.098거의 경계에 서 있다신림 — 제 무리 2두 고리의 차이가 곧 실루엣a 0.090b 0.181신림a 제 무리까지 평균 거리b 가장 가까운 남의 무리까지s = (b − a) ÷ 둘 중 큰 것= (0.181 − 0.090) ÷ 0.1810.503제 무리에 잘 붙었다강남 — 제 무리 3두 고리의 차이가 곧 실루엣a 0.139b 0.154강남a 제 무리까지 평균 거리b 가장 가까운 남의 무리까지s = (b − a) ÷ 둘 중 큰 것= (0.154 − 0.139) ÷ 0.1540.098거의 경계에 서 있다

신림은 두 고리가 확연히 다릅니다(0.090 대 0.181) — 제 무리에 잘 붙었습니다. 강남은 두 고리가 거의 겹칩니다(0.139 대 0.154) — 조금만 밀려도 남의 무리로 넘어갈 자리입니다. 같은 나눔 안에 이렇게 다른 역들이 함께 있고, 평균 0.324 는 그 차이를 한 숫자로 뭉갭니다. 자료: 3정거장 코드 ③과 2-3 실험실이 찍는 값과 같다(원장 실측).

규칙실루엣 점수를 보고할 때는 평균 한 숫자 옆에 음수인 역의 수와 무리 크기를 함께 적는다.

2-3점수를 올리면 더 좋은 나눔이 되는가 — 실험실 10분

이제 손으로 확인합니다. 아래 실험실에서 역을 골라 다른 무리로 옮기면 239개 실루엣이 그 자리에서 다시 계산됩니다. 점수를 올려 보세요. 그리고 점수만 보고 움직이는 봇이 어디까지 가는지 끝까지 보세요.

시뮬레이터

실루엣 사냥

역을 옮겨 점수를 올려라 — 올라간 점수는 더 좋은 나눔인가

  1. 1붐비는 다섯 역의 s 를 먼저 찍어 예측을 잠근다
  2. 2지도나 실루엣 막대에서 역을 골라 '→ 무리 ○' 로 옮긴다
  3. 3점수만 보는 봇을 끝까지 돌려 비교표를 연다
몸풀기 — 가장 붐비는 다섯 역(잠실 · 강남 · 서울역 · 사당 · 홍대입구)의 실루엣은?
고른 역을 옮기기
되돌리기 · 내보내기
점수만 보는 봇
k-평균이 나눈 그대로 — 239역 · 네 무리먼저 몸풀기 예측을 잠그세요

실루엣 s = (b − a) ÷ 둘 중 큰 것 · a = 제 무리까지 평균 거리 · b = 가장 가까운 남의 무리까지 평균 거리 · 239개 s 의 평균이 실루엣 평균 · 거리는 6차시의 구성비 표에서 잰다

점수만 보는 봇 = 실루엣 평균을 가장 많이 올리는 이사를 한 번에 하나씩, 더 올릴 수 없을 때까지 둔다(동점이면 역 차례 · 무리 번호가 앞선 쪽). 무리를 통째로 비우는 이사만 하지 않는다 — 그 밖에는 아무것도 보지 않는다

[파이썬으로] 를 누르면 지금까지 옮긴 역이 코드 ④ 에 붙일 한 줄로 여기에 나옵니다.

실루엣 평균0.324
음수인 역6곳
가장 작은 무리32역
무리 안0.095
무리 사이0.239
옮긴 횟수0
도전 1

음수인 여섯 역을 모두 가장 가까운 남의 무리로 옮겨라(막대가 0 왼쪽으로 삐져나온 역이다). 고치고 나면 음수인 역은 몇 곳이 되나?

도전 2

열 번 안에 k-평균의 0.324 를 넘어 0.330 에 닿아라. 봇은 여섯 수에 닿는다.

도전 3

음수인 역을 0 곳으로 — 열아홉 수 안에. 힌트: 가장 낮은 역부터 하나씩, 옮길 때마다 다시 보면서.

자료: 서울교통공사, 역별 일별 시간대별 승하차인원 정보(2024), 공공데이터포털(15048032), 이용허락범위 제한 없음 — 2024년 11월 평일 하루 평균으로 가공. 239역 × 40칸 구성비 표와 k-평균 k=4 무리 번호를 쪽 안에 실었고, 거리 · 실루엣 · 주성분 두 축 · 봇의 수는 판이 그 자리에서 계산한다.

체크포인트 2

실루엣을 a 와 b 로 말할 수 있고, 점수를 올리는 이사가 무리를 어떻게 망가뜨릴 수 있는지 판에서 보았다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

k 를 바꿔 가며 세 숫자를 재고, 한 역의 실루엣을 손으로 구한다

오늘의 장비

KMeans 와 실루엣 — 나누는 도구, 재는 도구

k-평균은 무리의 중심 k 개를 두고 '가장 가까운 중심에 배정 → 중심을 배정된 것들의 평균으로 이동'을 되풀이합니다. 그 스무 줄을 직접 짜는 일은 「인공지능 기초」의 몫이고, 여기서는 도구로 부릅니다. 처음 실행은 몇 초 멈춥니다 — 고장이 아니라 scikit-learn 과 그림 도구를 처음 받는 중이에요(쪽마다 한 번).

부르는 모양

from sklearn.cluster import KMeans

km = KMeans(n_clusters=4, n_init=10,
            random_state=0)
라벨 = km.fit(X).labels_   # 역마다 무리 번호

오늘 쓰는 함수 넷

KMeans
k 개로 나눈다 — n_init 은 시작점을 몇 번 바꿔 볼지
pairwise_distances
역×역 거리표(6차시에서 쓴 그 도구)
silhouette_score
나눔 전체의 s 평균 하나
silhouette_samples
역마다의 s 239개

6차시 도구와 다른 셋

  1. 답이 없는 학습정답표가 없다 — 맞았는지 채점할 사람이 없다
  2. 시작점에 흔들린다n_init=10 은 열 번 시작해 가장 좋은 것을 고른다는 뜻
  3. 번호는 이름표일 뿐무리 0·1·2·3 의 순서에는 뜻이 없다

대가 — 도구가 나눠 주지만 몇 개로 나눌지, 잘 나눴는지는 도구가 말해 주지 않습니다. 그것이 오늘의 일입니다.

1

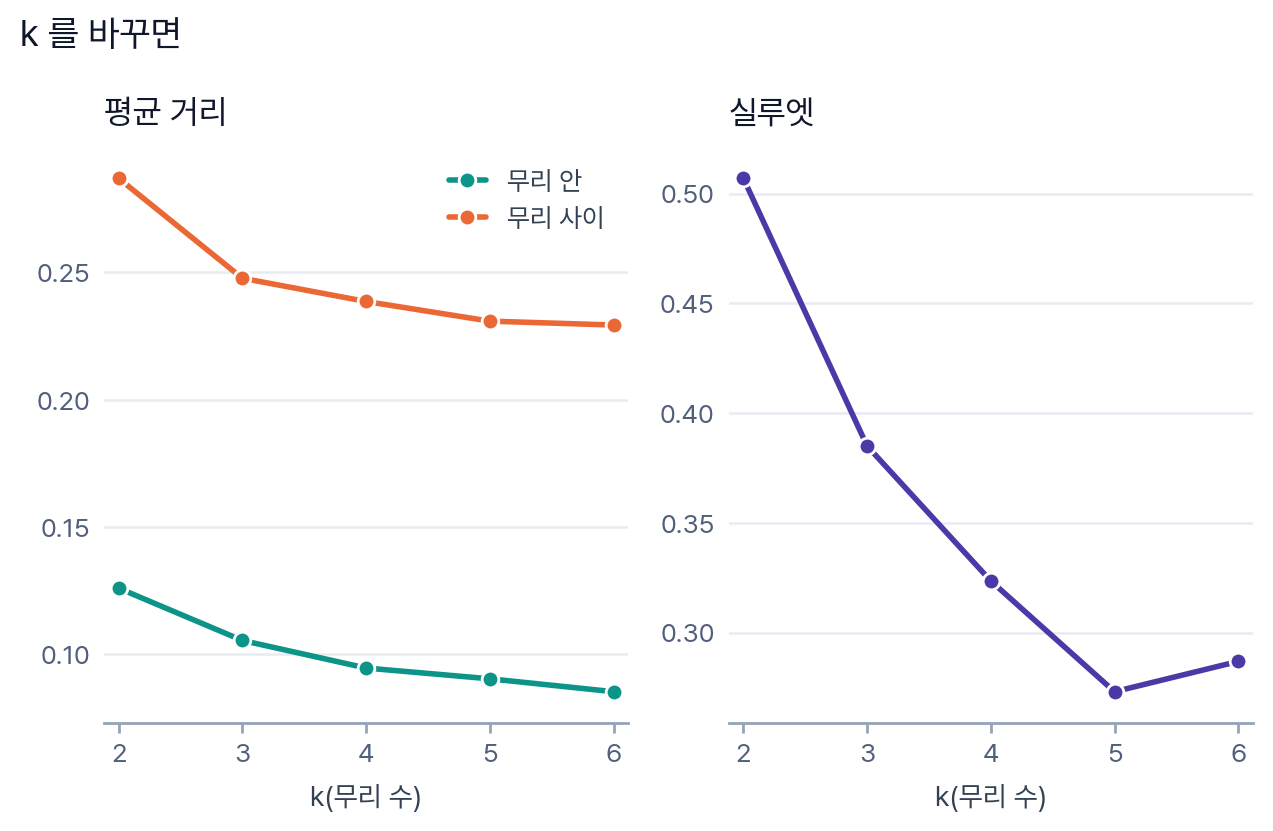
k 를 2 에서 6 까지 — 안 · 사이 · 실루엣을 나란히

9분

코드 ①은 6차시의 구성비 표와 거리표를 다시 만든 뒤, k 를 2부터 6까지 바꿔 가며 세 숫자를 찍습니다. k 를 늘리면 세 숫자는 각각 어느 쪽으로 갈까요? 셋 다 같은 방향일까요? 표가 나오기 전에 화살표 셋(↑ ↓ —)을 공책에 적어 두세요.

기본 빈칸 ①에 KMeans 가 몇 개로 나눌지를 채우고 ▶ 실행하세요. 반복문의 k 가 2 → 6 으로 바뀌는 그 값입니다. 처음 실행은 몇 초 걸립니다.

도전 n_init=10 을 n_init=1 로 바꿔 보세요 — 시작점을 열 번 바꿔 최선을 고르지 않고 한 번만 두면, k=4 의 실루엣은 0.324 → 0.325 로 거의 그대로인데 크기가 [92, 67, 48, 32] → [92, 67, 45, 35] 로 갈립니다. k=5 는 0.273 → 0.288 로 오릅니다. random_state 를 0~9 로 바꿔 가며 돌리면 k=4 가 0.309~0.328, k=6 이 0.213~0.287 로 흔들려요 — 같은 코드인데 답이 달라지는 자리입니다.

탐구 'k = 239'(역마다 한 무리)를 이 표의 마지막 줄로 적는다면 세 숫자는 각각 무엇이 될까요? 잴 쌍이라는 말을 써서 까닭을 적고, 표의 숫자만 보고 k 를 고르는 일이 왜 위험한지 한 줄 덧붙이세요.

'무리 안'만 보면 k = 를 고르게 되고, '무리 사이'만 보면 k = 를, 실루엣을 보면 k = 를 고르게 된다. 셋이 갈리는 까닭은 이다.

확인 문제 1에 적어 제출 →
2

반례 — 인원 그대로 나누면 점수가 더 높다?

3분

여는 장면의 그 나눔을 직접 돌려 봅니다. 구성비로 바꾸지 않고 인원 그대로 넣으면 실루엣이 0.507 → 0.612 로 오릅니다. 작은 무리 47역에는 어떤 역들이 들어갈까요?

기본 코드 ②는 채워져 있습니다. 그대로 ▶ 실행해 k=2·3·4 의 점수와 크기를 받고, 작은 무리에 든 역 이름과 하루 승하차 중앙값 두 개를 읽으세요.

탐구 이 나눔에 이름을 붙인다면 뭐라고 부르겠습니까? '아침에 사람이 몰리는 역 / 저녁에 몰리는 역'처럼 하루의 모양으로 부를 수 있나요, 아니면 '큰 역 / 작은 역'밖에 못 부르나요? 못 부른다면 그 까닭을 6차시의 낱말로 적어 보세요.

이 나눔의 높은 점수가 잰 것은 이고, 재지 않은 것은 이다. 그래서 점수가 더 낮은 표를 쓴다.

확인 문제 2에 적어 제출 →
3

한 역의 실루엣 — 손으로, 그리고 도구로

4분

기준 역은 6차시와 같은 신림입니다. 신림은 제 무리에 잘 붙었을까요? s 가 1 쪽일지 0 쪽일지 먼저 정하고, 그림 1의 두 고리를 떠올려 보세요.

기본 a 와 b 는 코드가 구해 줍니다. 빈칸 ②에 실루엣의 식을 채우세요 — 그림 1의 그 식입니다. 그다음 silhouette_samples 가 낸 값과 같은지(True) 확인합니다.

도전 b = min(…) 을 b = max(…) 로 바꿔 보세요 — '가장 가까운 남의 무리' 대신 '가장 먼 남의 무리'까지의 거리를 쓰면 신림은 0.503 → 0.799, 239역 평균은 0.324 → 0.695, 음수인 역은 6곳에서 0곳으로 사라집니다 (군자 0.020 → 0.721 · 아현 0.048 → 0.747). 점수는 올라가는데 경계에 선 역이 보이지 않게 됩니다 — b 가 왜 '가장 가까운'이어야 하는지를 이 한 줄이 말해 줍니다.

탐구 그림의 무리 넷 가운데 평균선 왼쪽으로 처진 무리는 어느 것인가요? 그 무리에 든 역 수와 함께 적고, 8차시에서 그 무리에 이름을 붙일 때 무엇을 조심해야 할지 한 줄 덧붙이세요.

평균 한 숫자(silhouette_score)가 숨긴 것은 이고, 그것을 드러내는 것은 이다.

확인 문제 5에 적어 제출 →
4

판이 준 이사 목록을 코드로 — 그리고 내 k 를 고른다

4분

2정거장 실험실의 [파이썬으로] 를 누르면 여러분이 옮긴 역이 한 줄로 나옵니다. 그 줄을 코드 ④ 의 이사 = […] 자리에 붙이면, 계기판이 보여 준 숫자가 소수 셋째 자리까지 같게 나올까요?

기본 코드 ④에는 도전 1 의 이사 목록(음수 여섯)이 미리 들어 있습니다. 그대로 ▶ 실행해 계기판과 맞대어 보고, 여러분의 목록으로 바꿔 한 번 더 돌리세요.

도전 마지막 줄의 km.inertia_ 는 k-평균이 실제로 줄이는 값입니다 (무리 중심에서 떨어진 거리의 제곱합). 이사 뒤에 실루엣은 0.324 → 0.328 로 올랐는데 제곱합은 1.411 → 1.417 로 늘었습니다. 두 잣대가 서로 반대로 움직인 셈이에요. 어느 쪽을 믿어야 할까요? 무엇을 재는 자인지부터 적어 보세요.

탐구 — 본 과제 여러분의 k 를 고르세요(2~6). 근거는 숫자 둘 이상 + 무리 크기로 적습니다. 8차시에서 이 k 로 무리에 이름을 붙입니다.

나는 k = 를 고른다. 근거는 와 이고, 이때 가장 작은 무리는 역이다.

확인 문제 6에 적어 제출 →
체크포인트 3

세 숫자를 k 마다 재었고, 한 역의 실루엣을 손으로 구해 도구와 맞댔고, 내 k 를 근거와 함께 골랐다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

  1. 찾은 것

    군집의 '잘'은 두 숫자다 — 무리 안은 가깝게(k 를 늘리면 0.126 → 0.085 로 늘 준다), 무리 사이는 멀게. 실루엣은 역마다 a 와 b 를 견줘 이 둘을 한 숫자로 묶는다.

  2. 도구의 한계

    실루엣은 떨어진 정도만 잰다. 쓸모 — 유형으로 쓸 수 있나, 이름을 붙일 수 있나 — 는 재지 않는다. 점수만 보는 봇이 0.393 까지 올린 나눔에는 두 역짜리 무리가 있었다.

  3. 보고의 규칙

    실루엣 점수를 평균 한 숫자로 보고하지 않는다 — 음수인 역의 수와 무리 크기를 함께 적는다. 숫자는 판단의 근거 중 하나일 뿐, 결정 그 자체가 아니다.

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. k 를 2 에서 6 으로 늘리는 동안 '무리 안 평균 거리'는 0.126 에서 0.085 로 계속 줄었다. 그러니 k = 6 이 가장 좋다는 주장을 반박하시오. 그리고 k 를 고를 때 무엇을 함께 보아야 하는지 쓰시오.
📖 모범 답안

무리를 늘리면 '안'은 언제나 준다. 한 무리에 남는 것이 점점 서로 닮은 것들뿐이기 때문이다. 끝까지 밀면 역마다 한 무리(k = 239)가 되고 그때 무리 안 평균 거리는 0 이다 — 잴 쌍이 없다. 그러니 '안'은 k 를 고르는 잣대가 될 수 없다. 한쪽 눈으로 고른 숫자는 늘 같은 답을 낸다.

함께 보아야 할 것 — ① 무리 사이 평균 거리(우리 표에서는 0.287 → 0.229 로 함께 줄었다), ② 실루엣(k=2 0.507 · 3 0.385 · 4 0.324 · 5 0.273 · 6 0.287 — 셋 가운데 유일하게 오르내린다), ③ 무리 크기(한쪽이 몇 역뿐인 나눔은 '유형'이라 부르기 어렵다), ④ 해석 가능성(무리마다 하루 모양에 이름을 붙일 수 있나 — 8차시).

2. 같은 239역을 두 가지로 나눴다. ① 인원 그대로 나눈 k=2 의 실루엣은 0.612 로, 구성비로 나눈 k=2 의 0.507 보다 높다. 그래도 우리가 구성비 표를 쓰는 까닭을 쓰시오. ② 실루엣 사냥판의 '점수만 보는 봇'은 82수 만에 0.393 을 냈다 — k-평균의 0.324 보다 높다. 그런데 무리 크기가 [75, 43, 119, 2] 이고 가장 작은 무리는 안암 · 장암 두 역뿐이며, 그 둘의 s 는 −0.581 · −0.514 다. 이 결과를 "네 종류의 역을 찾았다"고 보고하면 무엇이 잘못인지 쓰시오.
📖 모범 답안

① 인원 그대로 나누면 인원이 큰 칸이 거리를 독차지한다(6차시). 그래서 갈라지는 것은 '하루의 모양'이 아니라 큰 역과 작은 역이다 — 작은 무리 47역은 잠실 · 강남 · 서울역 · 사당 · 홍대입구 · 고속터미널 …이고, 하루 승하차 중앙값이 87,112명 대 26,710명으로 갈린다. 우리가 묻는 것은 '어느 역이 큰가'가 아니라 '어떤 하루를 보내는가'이므로 점수가 낮아도 구성비 표를 쓴다. 실루엣은 떨어진 정도만 재고 그것이 우리 물음에 맞는지는 재지 않는다.

② 한 무리가 두 곳뿐인데, 그 둘조차 서로 닮지 않았다 — 안암과 장암 사이 거리는 0.398 로 239역 쌍의 거리 중앙값 0.173 의 두 배가 넘는다. 두 역의 s 가 크게 음수인데도 평균이 0.324 → 0.393 으로 올랐다는 것은 나머지 237역의 s 가 그만큼 높아졌다는 뜻이고, 평균 한 숫자가 그 사이에서 '두 역짜리 무리'를 숨긴다. 점수는 떨어진 정도만 재고 쓸모(유형으로 쓸 수 있나 · 이름을 붙일 수 있나)는 재지 않는다. 보고할 때는 무리 크기와 음수인 역 수를 함께 적는다.

3. 어느 역의 a = 0.08, b = 0.19 였다. s 를 구하고 그 뜻을 쓰시오. 같은 역의 b 가 0.07 이었다면 s 는 얼마이고 무슨 뜻인가?
📖 모범 답안

s = (b − a) ÷ (a 와 b 가운데 큰 것) = (0.19 − 0.08) ÷ 0.19 ≈ 0.58. 제 무리까지의 거리가 남의 무리까지의 거리보다 훨씬 가깝다 — 제 무리에 꽤 잘 붙어 있다.

b = 0.07 이면 큰 쪽이 a 이므로 s = (0.07 − 0.08) ÷ 0.08 ≈ −0.13. 남의 무리에 더 가깝다는 뜻이다 — 잘못 배정되었거나, 두 유형이 섞인 역일 수 있다. (실제로 우리 나눔에서 s 가 음수인 역은 6곳이고, 가장 낮은 곳은 몽촌토성 −0.109 이다.)

4. 우리 표에서 실루엣이 가장 높은 것은 k = 2(0.507)였고, k = 4 는 0.324 로 그보다 낮았다. 그래도 8차시에서 k = 4 로 무리에 이름을 붙이려 한다. 그렇게 고를 수 있는 근거를 쓰시오. 그리고 이 물음이 '숫자로 답이 정해지는 물음'인지 아닌지 함께 쓰시오.
📖 모범 답안

k = 2 는 점수가 가장 높지만 무리가 159역과 80역 둘뿐이라 '주거지 쪽과 나머지' 정도로만 갈린다. k = 4 는 실루엣이 0.324 로 낮아도 크기가 [92, 67, 48, 32] 로 고르고, 무리마다 하루 모양이 달라 이름을 붙일 수 있다(8차시의 일). 목적이 '배차와 역 관리에 쓸 유형 만들기'라면 쓸모가 더 크다.

숫자로 답이 정해지는 물음이 아니다. 실루엣 · 무리 크기 · 안과 사이는 근거이고, 마지막에 고르는 것은 무엇에 쓸 것인가이다. 그래서 보고서에는 고른 k 와 고른 까닭을 함께 적는다. (k = 5 를 골라도 된다 — 다만 그때 가장 작은 무리가 18역이라는 것까지 적어야 한다.)

5. 우리 나눔(k = 4)의 실루엣 점수는 0.324 다. 그런데 실루엣 그림에서는 한 무리의 막대 끝이 0 왼쪽으로 여럿 내려가 있었다. 보고서에 평균 한 숫자 말고 무엇을 더 적어야 하는지, 그리고 그것을 적지 않으면 무엇이 사라지는지 쓰시오.
📖 모범 답안

평균은 0.324 여도 그 무리의 몇 역은 남의 무리에 더 가깝다(s < 0). 잘못 붙었거나 두 유형이 섞인 역이다. 그러니 음수인 역의 수(6곳)와 이름, 그리고 0.1 아래인 역의 수(34곳)와 무리 크기를 함께 적는다. 8차시에서 그 역들을 반례 후보로 다시 본다.

적지 않으면 평균 한 숫자(silhouette_score)만 남고 그 안의 흩어짐이 통째로 사라진다. 실제로 음수인 여섯 역을 옮겨 고치면 평균은 0.324 → 0.328 로 거의 그대로인데 음수인 역은 6 → 8 곳으로 늘어난다 — 평균만 보고 있었다면 '좋아졌다'고 보고했을 자리다. 역마다의 s 를 무리별로 눕혀 쌓은 실루엣 그림이 이것을 드러낸다.

6. ① 여러분의 k 를 하나 고르고, 그 근거를 숫자 둘 이상 + 무리 크기로 쓰시오 (8차시에서 이 k 로 무리에 이름을 붙입니다). ② 같은 k 로 두 번 돌렸더니 무리 번호(0 · 1 · 2)가 서로 바뀌어 나왔다. 결과가 달라진 것인가? 어떻게 확인하는지 쓰시오.
📖 모범 답안

① (예) k = 4 를 고른다. 근거 — 실루엣 0.324 로 k=5 의 0.273 보다 높고, 무리 크기가 [92, 67, 48, 32] 로 한쪽으로 크게 치우치지 않았다(k=5 는 가장 작은 무리가 18역이다). 무리 안 0.095 · 무리 사이 0.239 로 둘의 차이도 충분하다. k = 2 를 골랐다면 점수가 가장 높다(0.507)는 것과 크기가 [159, 80] 이라는 것을 함께 적고, '두 무리로는 이름이 둘뿐'이라는 한계를 밝힌다. 근거 숫자와 크기를 함께 적었으면 어느 k 든 답이 된다.

② 번호는 이름표일 뿐이고 순서에 뜻이 없다. 결과가 달라졌는지는 각 무리에 든 역이 같은지로 확인한다 — 두 결과를 엇갈려 센 표(어느 무리의 역이 다른 결과의 어느 무리로 갔는지)를 만들어 보면 된다. 무리 자체가 흔들리는지(같은 자료를 조금 바꿔도 같은 나눔이 나오는지)는 13차시의 안정성 검사에서 다룬다.

+
더 알아보기

무리 이야기 셋

밝기와 색 두 칸으로 찍었더니가로 = 표면 온도(오른쪽이 낮다) · 세로 = 밝기주계열성거성백색왜성밝다어둡다뜨겁다차갑다무리 셋은 누가 나눈 것이 아니라두 칸으로 찍었더니 스스로 갈라져 보인 것이다
역사

별을 두 칸으로 찍었더니 무리가 나타났다

1910년대 초, 덴마크의 아이나르 헤르츠스프룽과 미국의 헨리 노리스 러셀은 서로 따로, 별들을 밝기와 색(표면 온도) 두 칸으로만 찍어 보았습니다. 그 전까지 별은 밝기로 줄 세우거나 별자리로 묶던 대상이었어요. 두 칸짜리 표를 그림 한 장으로 옮기자 점들이 제멋대로 흩어지지 않고 몇 덩어리로 모였습니다.

왼쪽 위에서 오른쪽 아래로 길게 뻗은 띠가 주계열성, 오른쪽 위에 따로 앉은 덩어리가 거성, 왼쪽 아래 구석이 백색왜성입니다. 아무도 이 이름을 미리 정해 놓고 나눈 것이 아니라, 두 칸으로 찍었더니 갈라져 보인 것에 뒤늦게 이름을 붙인 것이지요. 오늘 우리가 한 일도 이것과 같습니다 — 239역을 40칸으로 찍고, 무리가 보이는지 보고, 8차시에서 이름을 붙입니다. 다만 별은 두 칸이라 사람 눈으로 무리가 보였고, 우리 역은 마흔 칸이라 눈으로는 안 보인다는 것이 다릅니다. 그래서 거리와 실루엣이라는 자가 필요했습니다.

도해: 가로는 표면 온도(오른쪽이 낮다), 세로는 밝기. 점의 자리는 세 무리가 어디에 서는지를 보인 모식도이고 실제 관측값이 아니다. · 헤르츠스프룽(1911) · 러셀(1913)

같은 평균, 다른 속가로 = 역마다의 s · 세로 = 무리별로 눕혀 쌓은 239역① k-평균이 나눈 그대로무리 0무리 1무리 2무리 3평균 0.3240 아래 6곳② 음수인 여섯 역을 옮긴 뒤무리 0무리 1무리 2무리 3평균 0.3280 아래 8곳평균은 0.324 → 0.328 로 거의 그대로인데0 왼쪽으로 삐져나온 막대는 6 → 8 개
방법 더 깊이

실루엣을 만든 사람은 왜 그림을 그렸나

피터 루소가 1987년에 실루엣을 내놓았을 때, 그가 함께 제안한 것은 숫자가 아니라 그림이었습니다. 무리마다 그 무리에 든 점들을 s 가 큰 순서로 눕혀 쌓고, 전체 평균에 세로 점선 하나를 긋는 그림 — 코드 ③이 그린 바로 그 모양입니다.

왜 평균 한 숫자로 끝내지 않았을까요? 평균은 속이 다른 여러 모양에서 같은 값으로 나오기 때문입니다. 왼쪽 그림 ①은 k-평균이 나눈 그대로(평균 0.324 · 0 아래 6곳)이고, ②는 그 여섯 역을 가장 가까운 남의 무리로 옮긴 뒤입니다 (평균 0.328 · 0 아래 8곳). 평균은 거의 그대로인데 0 왼쪽으로 삐져나온 막대는 오히려 늘었습니다. 한 역을 옮기면 그 역이 떠난 무리와 들어간 무리의 a · b 가 모두 다시 계산되기 때문이에요. 평균만 보고 있었다면 '0.004 만큼 좋아졌다'고 보고했을 자리입니다. 그림은 이렇게 평균이 삼킨 흩어짐을 한눈에 되돌려 줍니다.

도해: 239역의 s 를 무리별로 눕혀 쌓고 평균에 점선을 그었다. 가로는 −0.25~0.85. 두 그림 모두 이 차시의 실측값이다(원장 계산 · 코드 ③·④와 같은 값).

마흔 칸을 두 축에 펼친다는 것높이를 버리고 바닥에 드리운 그림자만 본다가나그림자에서는 한자리실제로는 이만큼 떨어져 있다두 축이 만든 평면 — 설명 89.7%지도에서 가까워 보여도 40칸 거리는 멀 수 있다
보는 법

마흔 칸을 두 축에 펼친다는 것

실험실의 무리 지도는 역 하나를 점 하나로 찍습니다. 그런데 역 하나는 원래 마흔 개의 숫자예요 — 마흔 칸짜리 자리를 평면에 그릴 수는 없습니다. 그래서 주성분을 씁니다. 점구름이 가장 길게 늘어난 방향을 첫째 축, 그 축과 직각인 방향 가운데 다시 가장 길게 늘어난 방향을 둘째 축으로 잡고, 두 축이 만든 평면에 점들을 납작하게 눌러 찍는 것이지요. 조명을 비춰 바닥에 그림자를 드리우는 것과 같습니다.

우리 239역은 두 축만으로 흩어짐의 89.7%(첫째 축 81.2% + 둘째 축 8.5%)를 담습니다. 꽤 많이 담는 편이지만, 남은 10.3% 안에서 지도에서는 붙어 보이는 두 역이 실제로는 멀 수 있습니다. 그림자에서 겹쳐 보이는 두 점이 사실은 높이가 다른 것처럼요. 그래서 실험실은 지도를 보여 주기만 하고, a · b · s 는 늘 원래 마흔 칸 표에서 잽니다. 지도는 눈이 쓰는 도구이고, 거리는 자가 쓰는 도구입니다.

도해: 높이를 버리고 바닥에 드리운 그림자만 보는 모식도. 점의 자리는 예시이고, 89.7%(81.2 + 8.5)는 이 차시 239역 구성비 표의 실측값이다(원장 계산 · 실험실이 그 자리에서 다시 잰다).