단원 홈

Ⅲ. 데이터 모델링과 평가5차시

통계 모델과 기계학습 모델에게
같은 것을 물으면

31°C 평일에 몇 대? — 두 답이 3,600대 갈렸다

같은 353일, 같은 훈련 282일, 같은 코드 두 줄로 세운 모델 둘이 서로 다른 답을 내놓습니다. 한쪽이 틀린 걸까요, 아니면 둘이 서로 다른 말을 하고 있는 걸까요. 오늘은 두 모델을 이름을 가린 채 캐물어 말버릇을 밝혀내고, 같은 도구로 직접 세워 봅니다.

  • [12데과03-02]
  • 50분네 정거장
  • 새 도구train_test_split · DecisionTreeRegressor
  • 자료서울 따릉이 하루 대여 353일(UCI)
Ⅲ 단원 지도5 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    두 모델이 무엇으로 말하는지(계수의 문장 · 규칙과 시험 오차)를 가르고, 도구 이름이 그것을 가르지 않는 까닭을 말할 수 있다.

  2. 손으로

    같은 훈련·시험으로 두 모델을 세워 계수 · 규칙 · 시험 RMSE · 기온별 예측표를 받아 나란히 읽을 수 있다.

  3. 확인에서

    '31°C 평일'에 어느 모델의 말을 쓸지 목적과 근거를 들어 한 문장으로 보고할 수 있다.

1
여는 장면 · 5분

같은 파일을 받은 두 분석가, 3,600대가 갈렸다

Ⅲ-3 · Ⅲ-4 에서 가져옴3차시에서 세운 직선은 '기온이 1°C 높은 날은 몇 대 더 나가나'를 한 숫자로 말해 주었습니다. 4차시는 그 직선이 더운 끝에서 빗나간다는 것을 잔차로 보였지요. 오늘은 그 자리에 형태를 미리 정하지 않는 모델을 하나 더 세웁니다.

따릉이 운영팀이 내일 내놓을 자전거 대수를 정하려고 분석가 둘에게 같은 파일을 보냈습니다. 353일치 하루 대여와 그날의 기온·강수, 그리고 쉬는날인지 아닌지. 둘은 파일을 똑같이 훈련 282일과 시험 71일로 나누고(씨앗 42 고정), 훈련 282일로만 모델을 세웠습니다.

물음도 하나였습니다. "31°C, 비 안 옴, 평일 — 몇 대?"

돌아온 답은 31,344대와 27,744대. 3,600대가 갈렸습니다. 같은 자료, 같은 나누기, 같은 세 가지 정보를 썼는데도요.

도시 · 가상 기사

내일 낮 31도 — 따릉이 몇 대를 내놓나, 두 예측이 3,600대 갈렸다

운영팀 내부 보고 · 이 기사는 수업을 위해 지어낸 것입니다
그림 1같은 353일, 같은 훈련 282일 — 그런데 답이 갈렸다왼쪽 나누기 · 오른쪽 두 답
① 353일을 둘로 나눈다씨앗 42 고정훈련 282일 · 80%시험 71일운영한 날 353일 (2017-12-01 ~ 2018-11-30)㉠상자형태를 먼저 가정한다㉡상자형태를 가정하지 않는다같은 훈련 282일 · 같은 세 가지(기온 · 강수 · 쉬는날)시험 71일은 배울 때 한 번도 보지 않았다나중에 채점할 때만 꺼낸다 ② 같은 물음 하나31°C · 비 안 옴 · 평일 — 따릉이 몇 대가 나갈까01만2만3만31,344㉠ 의 답27,744㉡ 의 답3,600대차이?실제가려 둠세로: 하루 대여(대) ① 353일을 둘로 나눈다씨앗 42 고정훈련 282일 · 80%시험 71일운영한 날 353일 (2017-12-01 ~ 2018-11-30)㉠상자형태를 먼저 가정한다㉡상자형태를 가정하지 않는다같은 훈련 282일 · 같은 세 가지(기온 · 강수 · 쉬는날)시험 71일은 배울 때 한 번도 보지 않았다나중에 채점할 때만 꺼낸다 ② 같은 물음 하나31°C · 비 안 옴 · 평일 — 따릉이 몇 대가 나갈까01만2만3만31,344㉠ 의 답27,744㉡ 의 답3,600대차이?실제가려 둠세로: 하루 대여(대)

두 상자가 배운 날도, 채점받을 날도 같습니다. 남은 차이는 무엇을 미리 가정했는가 하나뿐이에요. 실제 값은 아직 가려 두었습니다 — 3정거장 미션 ④가 엽니다. 자료: UCI Seoul Bike Sharing Demand(CC BY 4.0, DOI 10.24432/C5F62R)를 하루 단위로 묶은 seoul_bike_daily.csv · 운영일 353일 — 숫자는 코드 ①·④ 가 찍는 값과 같다

먼저 예측

둘 가운데 하나가 맞을까요? 31°C 맑은 평일에 실제로 나간 대수는 두 답 사이일까요, 아니면 둘보다 적거나 많을까요? 한 문장으로 적어 두세요 — 까닭도 함께. 2정거장 시뮬레이터의 현장 기록과 3정거장 미션 ④가 답을 엽니다.

체크포인트 1

두 모델이 같은 자료·같은 나누기 위에 섰다는 것을 확인했고, 실제 값에 대한 내 예측을 적어 두었다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

이름을 가린 채 캐물어 본다

2-1두 모델을 같은 자리에 세운다

두 모델은 같은 도구(scikit-learn)로 세웁니다. 코드로 보면 모델을 세우는 줄이 글자까지 같은 꼴이에요.

모델 = 만들기(...)
모델.fit(X훈, y훈)     # 배우기
모델.predict(물음)     # 답하기

다른 것은 만들기 자리에 무엇이 들어가느냐뿐입니다. 한쪽은 형태를 먼저 정하고 그 형태의 숫자(계수)만 데이터에서 추정합니다 — 직선이지요. 다른 한쪽은 형태를 정하지 않고 데이터를 잘라 가며 규칙을 배웁니다.

훈련과 시험을 나누는 일도 오늘이 처음입니다. train_test_split 은 353일을 뒤섞어 80%인 282일을 훈련으로, 20%인 71일을 시험으로 갈라 둡니다. 씨앗 42를 고정한 것은 두 모델에게 똑같은 282일을 주기 위해서예요. 시험 71일은 배우는 동안 한 번도 쓰지 않고, 채점할 때만 꺼냅니다.

2-2이름 가린 두 상자 — 10분

지금부터 두 모델은 ㉠ 상자와 ㉡ 상자입니다. 어느 쪽이 직선이고 어느 쪽이 나무인지는 적어 두지 않았어요. 여러분이 할 일은 질문 카드를 만들어 보내고, 돌아온 답에서 두 상자의 말버릇을 캐내는 것입니다.

처음 나오는 말 셋을 먼저 정해 둡니다. 질문 카드는 기온 · 강수 · 평일/쉬는날 세 칸을 채운 하루 한 장이고, 보내면 두 상자가 동시에 답합니다(30장까지). 증거 짝은 기록장의 두 카드가 꼭 하나만 다를 때 판정관이 받아 주는 한 쌍입니다 — 둘 이상 다르면 거절돼요(무엇이 답을 바꿨는지 가릴 수 없으니까). 검사 넷은 말버릇 · 가장 큰 계단 · 귀 검사 · 범위 밖이고, 넷이 다 끝나면 현장 기록(그런 날 실제로 몇 대가 나갔는지)과 정체(어느 상자가 어느 모델인지)가 열립니다.

시뮬레이터

이름 가린 두 상자

질문 카드 30장으로 말버릇을 캔다 — 검사 넷을 마치면 상자가 열린다

  1. 131°C 맑은 평일의 실제를 먼저 찍어 예측을 잠근다
  2. 2카드를 만들어 보내고, 기록장에서 두 줄을 골라 증거 짝을 낸다
  3. 3검사 넷이 끝나면 현장 기록과 정체가 열린다
여는 잠금 — 31°C 맑은 평일의 실제는?
질문 카드 · 기온
질문 카드 · 강수
질문 카드 · 날
보내기
아직 카드를 보내지 않았다먼저 예측을 잠근다

증거 짝 = 기록장의 두 카드가 꼭 하나만 다를 때만 판정관이 받는다 · 계단 = 기온만 0.1°C 다른 짝에서 한 상자의 답이 1,000대 넘게 뛴 자리 · 상자의 답은 1대 단위로 반올림해 적으므로, 기록장의 두 답을 직접 빼면 판정관이 적은 몫과 1대까지 다를 수 있다

검사 넷 — 말버릇(기온만 다른 짝을 5°C 넘게 떨어진 두 곳에서) · 가장 큰 계단(0.1°C 짝에서 1,000대 넘는 뜀) · 귀 검사(쉬는날만 다른 짝을 두 기온에서) · 범위 밖(−14.1°C 아래와 33.4°C 위를 한 장씩)

보낸 카드0/ 30장
㉠ 의 답—
㉡ 의 답—
두 답 차이—
증거 짝0
검사0/4
도전 1

가장 큰 계단을 0.1°C 안에 가두어라. 기온만 0.1°C 다른 증거 짝에서 한 상자가 가장 크게 뛰는 자리를 찾아라 — 카드 10장 이하로 찾으면 ★★★.

도전 2

귀가 없는 상자를 찾아라. 평일 → 쉬는날만 바꾼 증거 짝을 5°C 넘게 떨어진 두 기온에서 내어, 어느 쪽이 1대도 움직이지 않는지 보여라.

도전 3

문법 카드 네 칸. 상자가 열리면 무대 아래에 문법 네 줄이 나타난다. 줄마다 ㉠ 인지 ㉡ 인지를 골라 네 칸을 모두 맞혀라.

자료: 두 모델의 계수·문턱·칸 값은 원장이 브라우저(Pyodide 0.26.4)에서 잰 값을 쪽 안에 실은 것이다 — 코드 ①·②·④ 가 찍는 값과 1대까지 같다. 현장 기록의 실제 대여는 같은 seoul_bike_daily.csv 에서 센 값이다.

㉡ 이 쉬는날을 1대도 반영하지 않았다고 해서 '쉬는날은 대여와 관계없다'고 읽으면 안 됩니다 — 판이 연 현장 기록을 보면 실제 쉬는날의 몫은 기온대마다 −587대에서 −4,846대까지 달랐어요.

확인 문제 4에 그 까닭을 적어 제출 →

2-3판이 캐낸 것 — 두 문법

검사 넷이 끝나면 상자가 열립니다. ㉠ 은 통계적 회귀(직선), ㉡ 은 결정 트리(깊이 3)였어요. 결정적이던 증거 짝 넷을 나란히 놓으면 두 문법이 보입니다.

기온만 0.1°C — 9.6 → 9.7°C
+66㉠ 통계적 회귀(대)
vs
+7,959㉡ 결정 트리(대)

㉡ 은 칸을 넘는 자리에서 한 번에 뛴다 — 9.65°C.

25°C · 비만 0.1mm — 1.7 → 1.8mm
−28㉠ 통계적 회귀(대)
vs
−9,827㉡ 결정 트리(대)

비에도 칸이 있다 — 1.75mm 를 넘는 순간 다른 칸으로 떨어진다.

평일 → 쉬는날 — 네 기온 모두에서
−2,229㉠ 통계적 회귀(대)
vs
0㉡ 결정 트리(대)
−5°5°25°31°

㉡ 의 규칙에는 '쉬는날'이 한 번도 나오지 않는다.

배운 적 없는 −20°C
−2,361㉠ 통계적 회귀(대)
vs
5,427㉡ 결정 트리(대)

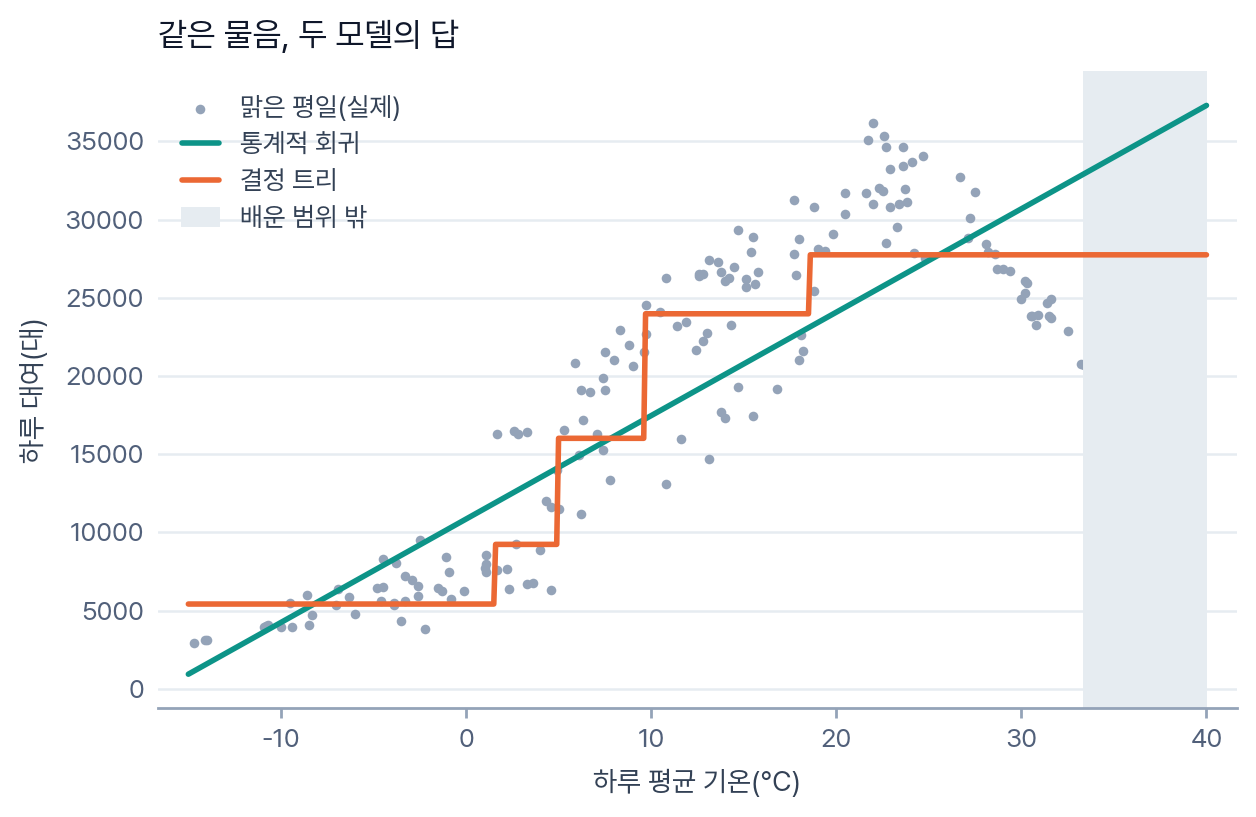
㉠ 은 음수까지 내려가고, ㉡ 은 마지막 칸 값에서 평평하다.

자료: 네 쌍의 숫자는 모두 원장이 브라우저에서 잰 값이다 — 회색 띠는 훈련에서 본 기온 범위(−14.1 ~ 33.4°C) 밖.

㉠ 의 문법은 한 문장입니다. "기온이 1°C 높은 날은 평균 661대 더 나갔다 · 강수가 1mm 많은 날은 280대 덜 나갔다 · 쉬는날은 2,229대 덜 나갔다." 이 몫은 −20°C 에서도 31°C 에서도 똑같이 적용됩니다. 그래서 0.1°C 를 올리면 어디서든 66대만 움직여요.

㉡ 의 문법은 자리마다 다른 칸입니다. 나무는 '어느 변수를 어디서 자르면 양쪽이 가장 고르게 되나'를 세 번 되풀이해 훈련 282일을 여덟 칸으로 나누고, 칸마다 그 칸에 들어온 날들의 평균 대여를 답으로 내놓습니다. 칸 안에서는 기울기가 없으니 기온이 조금 달라져도 답이 그대로이고, 칸을 넘는 순간 한 번에 뜁니다.

그림 2㉡ 의 정체 — 깊이 3 결정 트리가 찾은 여덟 칸왼쪽 갈림길 · 오른쪽 칸 값
① 나무가 고른 갈림길 일곱훈련 282일을 세 번 잘라 칸 여덟으로기온 ≤ 9.65°C ?예아니오기온 ≤ 4.95°C ?강수 ≤ 1.75mm ?기온 ≤ 1.55강수 ≤ 1.35기온 ≤ 18.5강수 ≤ 26.755,4279,23916,0176,22223,97727,74417,9176,882왼쪽 가지가 '예' · 오른쪽 가지가 '아니오' — 칸 값은 그 칸에 들어온 훈련 날들의 평균 대여주황 칸이 31°C 맑은 평일이 떨어지는 칸이다(기온 > 18.5 · 비 ≤ 1.75) ② 여덟 칸이 내놓는 값칸 하나는 한 값만 내놓는다 — 칸 안에서는 기울기가 없다기온 ≤ 1.555,427기온 4.95~9.65 · 비 > 1.356,222기온 > 9.65 · 비 > 26.756,882기온 1.55~4.959,239기온 4.95~9.65 · 비 ≤ 1.3516,017기온 > 9.65 · 비 1.75~26.7517,917기온 9.65~18.5 · 비 ≤ 1.7523,977기온 > 18.5 · 비 ≤ 1.7527,744주황 칸이 31°C 맑은 평일이 떨어지는 칸이다코드 ② 의 export_text 는 문턱을 소수 한 자리로 반올림해 찍는다(9.7 · 5.0 · 1.6 · 1.4 · 1.8 · 26.8) — 정확한 값은 위와 같다 ① 나무가 고른 갈림길 일곱훈련 282일을 세 번 잘라 칸 여덟으로기온 ≤ 9.65°C ?예아니오기온 ≤ 4.95°C ?강수 ≤ 1.75mm ?기온 ≤ 1.55강수 ≤ 1.35기온 ≤ 18.5강수 ≤ 26.755,4279,23916,0176,22223,97727,74417,9176,882왼쪽 가지가 '예' · 오른쪽 가지가 '아니오' — 칸 값은 그 칸에 들어온 훈련 날들의 평균 대여주황 칸이 31°C 맑은 평일이 떨어지는 칸이다(기온 > 18.5 · 비 ≤ 1.75) ② 여덟 칸이 내놓는 값칸 하나는 한 값만 내놓는다 — 칸 안에서는 기울기가 없다기온 ≤ 1.555,427기온 4.95~9.65 · 비 > 1.356,222기온 > 9.65 · 비 > 26.756,882기온 1.55~4.959,239기온 4.95~9.65 · 비 ≤ 1.3516,017기온 > 9.65 · 비 1.75~26.7517,917기온 9.65~18.5 · 비 ≤ 1.7523,977기온 > 18.5 · 비 ≤ 1.7527,744주황 칸이 31°C 맑은 평일이 떨어지는 칸이다코드 ② 의 export_text 는 문턱을 소수 한 자리로 반올림해 찍는다(9.7 · 5.0 · 1.6 · 1.4 · 1.8 · 26.8) — 정확한 값은 위와 같다

문턱은 일곱, 칸은 여덟입니다. 31°C 맑은 평일은 '기온 > 18.5 · 비 ≤ 1.75' 칸에 떨어져 27,744대 하나를 받습니다 — 그 칸 안에서는 20°C 도 33°C 도 같은 답이에요. 자료: 코드 ②의 export_text 규칙과 tree_.threshold — 원장 브라우저 실측

2-4시험이 판정관인가

이제 채점해 봅시다. 시험 71일은 둘 다 배울 때 쓰지 않은 날입니다. 자는 RMSE(√평균제곱오차 — 5차시 식 그대로), 작을수록 덜 빗나갑니다.

표 1훈련에서와 시험에서RMSE · 대 · 훈련 282일 / 시험 71일
모델훈련 RMSE시험 RMSE시험 − 훈련
㉠ 통계적 회귀5,4615,324−137
㉡ 결정 트리 깊이 33,9344,944+1,010

나무는 훈련에서 1,527대(5,461 − 3,934) 앞섰는데 시험에서는 380대(5,324 − 4,944)로 줄었습니다. 줄어든 몫이 배운 날에만 잘 맞히던 부분이에요. 직선은 훈련과 시험이 거의 같습니다. 자료: 코드 ③이 찍는 값

표 2나무를 더 깊게 하면같은 훈련 282일 · 같은 시험 71일
깊이훈련 RMSE시험 RMSE규칙이 쓴 '쉬는날' 가지
16,3307,2650
24,7215,6370
3 (오늘 쓴 나무)3,9344,9440
43,2534,8571
52,8714,8425
62,5134,9829
72,0604,97010
81,7025,20314

훈련 오차는 6,330 → 1,702 로 끝까지 줍니다. 그런데 시험 오차는 깊이 5(4,842)에서 가장 작고 그 뒤로 다시 늘어 깊이 8에서 5,203 이 됩니다 — 훈련에서만 줄어드는 몫이 외우기예요. 오른쪽 열도 보세요. 깊이 3 규칙에는 '쉬는날'이 한 번도 없고, 깊이 4에서 처음 한 가지가 생깁니다. 자료: 코드 ③의 깊이별 시험 RMSE · 원장 판 점검의 훈련 RMSE와 가지 수

규칙시험 오차를 보고할 때는 훈련 오차를 함께 적고, 그 숫자가 답하지 못하는 물음(예: 비 1mm 의 몫)이 무엇인지 함께 밝힌다.

체크포인트 2

두 상자의 말버릇을 캐내 정체를 밝혔고, 시험 오차가 무엇을 판정하고 무엇을 판정하지 못하는지 말할 수 있다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

같은 두 줄로 두 모델을 세우고, 답을 나란히 놓는다

오늘의 장비

scikit-learn 의 나누기와 나무

3차시에서 LinearRegression 을 썼던 그 도구 상자에서 둘을 더 꺼냅니다 — 자료를 훈련과 시험으로 가르는 train_test_split, 그리고 형태를 정하지 않는 모델 DecisionTreeRegressor. 처음 실행은 몇 초 멈춥니다 — 고장이 아니라 scikit-learn 을 처음 준비하는 중이에요(쪽마다 한 번).

부르는 모양

from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeRegressor

X훈, X시, y훈, y시 = train_test_split(
    X, y, test_size=0.2, random_state=42)
나무 = DecisionTreeRegressor(max_depth=3,
                            random_state=0)
나무.fit(X훈, y훈)   # 회귀와 같은 줄

오늘 쓰는 함수 넷

train_test_split
자료를 훈련과 시험으로 — test_size·random_state
DecisionTreeRegressor
회귀 나무 — max_depth 로 깊이
export_text
나무가 찾은 규칙을 글로 찍는다
mean_squared_error
평균제곱오차 — 제곱근이 RMSE

LinearRegression 과 다른 셋

  1. 형태를 안 정한다직선도 곡선도 아닌 계단이 결과로 나온다
  2. 규칙으로 말한다계수가 없다 — export_text 가 찍는 갈림길이 답이다
  3. 깊이를 내가 정한다max_depth 한 숫자가 칸 수를 바꾼다

대가 — 깊이를 내가 정할 수 있다는 것은 깊이로 속일 수도 있다는 뜻입니다(표 2).

1

계수 셋을 문장 셋으로 옮긴다

3분

쉬는날(주말·공휴일) 계수는 + 일까요 − 일까요, 크기는 얼마쯤일까요? 판에서 본 ㉠ 의 말버릇을 떠올려 보세요.

기본 코드 ①은 채워져 있습니다. 그대로 ▶ 실행해 절편과 계수 셋을 받으세요. 같은 파일을 train_test_split 이 훈련 282일 · 시험 71일로 가르는 것도 출력에서 확인합니다.

도전 마지막 줄이 말하는 대로 random_state=42 를 7 로 바꿔 보세요. 나누는 날이 달라지면 계수가 기온 +688 · 비 −282 · 쉬는날 −2,804(절편 10,706)로 바뀝니다 — 나누기 한 번이 문장을 흔듭니다.

탐구 계수 셋을 각각 '기온이 1°C 높은 날은 …' 꼴의 문장으로 옮겨 보세요. 세 문장 가운데 인과로 읽으면 위험한 것은 어느 것이고, 왜 그런가요?

㉠ 의 답이 0.1°C 마다 대씩만 움직이는 까닭은, 계수가 이기 때문이다. 그래서 이 문장은 에서도 같은 몫을 말한다.

확인 문제 2에 적어 제출 →
2

나무의 규칙을 읽는다

5분

나무가 맨 처음 자르는 변수는 무엇일까요? 몇 °C 쯤에서 자를까요? 판의 '가장 큰 계단'에서 본 자리를 떠올려 보세요.

기본 빈칸 ①에 형태를 미리 정하지 않는 모델의 이름을 채우고 ▶ 실행합니다. 바로 아랫줄의 나무.fit(X훈, y훈) 이 코드 ①의 통계.fit 과 같은 꼴인 것을 눈여겨보세요.

도전 마지막 줄이 말하는 대로 max_depth=3 을 4 로 바꿔 보세요. 규칙에 '쉬는날'이 처음 나타납니다(가지 1개 · 시험 RMSE 4,857 — 표 2).

탐구 export_text 가 찍는 첫 문턱은 9.7 인데 마지막 줄의 tree_.threshold[0] 은 9.65 입니다. decimals=1 이 반올림한 것이지요. 규칙을 보고서에 옮겨 적을 때 써야 할 값은 어느 쪽이고, 왜 그런가요?

나무가 처음 자른 자리는 이고, 이것이 알려 주는 것은 이다. 알려 주지 않는 것은 이다.

확인 문제 1에 적어 제출 →
3

시험 71일로 두 모델을 채점한다

3분

시험 오차는 누가 작을까요? 차이는 얼마쯤 날까요 — 수백 대일까요, 수천 대일까요?

기본 코드 ③은 채워져 있습니다. ▶ 로 두 모델의 훈련·시험 RMSE와 나무 깊이 1~8 의 시험 RMSE를 받아 표 1 · 표 2와 맞대어 보세요.

도전 훈련 RMSE 차(5,461 − 3,934 = 1,527대)와 시험 RMSE 차(5,324 − 4,944 = 380대)를 견줘 보세요. 어느 쪽이 얼마나 줄었나요? 줄어든 몫에 이름을 붙인다면 무엇이라 하겠습니까?

탐구 깊이 5의 시험 RMSE(4,842)가 깊이 3(4,944)보다 작습니다. 그런데도 이 차시가 깊이 3을 쓴 까닭을 규칙의 길이로 설명해 보세요 (깊이 3 은 칸이 여덟, 깊이 5 는 최대 서른둘입니다 — 사람이 읽어 옮길 수 있는 규칙인가요?).

훈련에서 나무가 대 앞섰는데 시험에서는 대로 줄었다. 줄어든 몫은 이다. 그러므로 시험 오차만으로 를 판정할 수는 없다.

확인 문제 3에 적어 제출 →
4

기온만 바꿔 물으면 — 그리고 실제

4분

여는 장면에 적어 둔 내 예측입니다. 이 칸이 실제 값을 엽니다 — 예측이 맞았을까요?

기본 코드 ④는 채워져 있습니다. ▶ 로 기온별 예측표와 그림 한 장을 받으세요. 판에서 결정적이던 카드 셋(9.6 · 9.7 · -20)과 40이 표에 들어 있습니다 — 판의 답과 1대까지 같은지 맞대어 보세요.

도전 물음 표의 temp 목록에 판에서 쓴 기온을 더해 보세요. 4.9 와 5.0 을 넣으면 결정 트리가 또 한 번 6,778대를 뜁니다.

탐구 그림의 회색 띠는 훈련에서 본 가장 더운 날(33.4°C) 바깥입니다. 띠 안에서 두 모델은 각각 어떻게 답하나요? 둘 다 믿을 수 없다면, 못 믿는 까닭이 서로 다른가요?

31°C 평일에 의 답이 실제에 더 가까웠지만, 그 답도 대 넘쳤다. 범위 밖에서 직선은 이고 나무는 이다.

확인 문제 5에 적어 제출 →
5

비교표를 채우고, 직선에 관절 하나

5분

관절이란 정한 기온을 넘은 만큼만 담는 열을 하나 더해, 그 자리부터 직선의 기울기가 달라지게 하는 것입니다. 관절을 하나만 더한 직선이 나무를 이길 수 있을까요? 먼저 짐작해 두세요.

기본 오늘의 본 과제는 확인 문제 6의 비교표입니다. 네 칸(예측의 모양 · 시험 RMSE · 기온의 영향을 말하는 문장 · 틀리는 곳)을 먼저 채우세요 — 미션 ①~④의 출력이 모두 근거입니다.

그다음 코드 ⑤를 ▶ 로 돌려 짐작을 확인합니다.

도전 주석이 말하는 대로 관절 = 18.5 을 9.65 나 4.95 로 바꿔 보세요. 나무가 찾은 문턱 셋 가운데 어느 자리가 가장 크게 줄이나요?

탐구 관절을 하나 더 넣어 둘(4.95 와 18.5)로 만들면 시험 RMSE가 4,173까지 내려갑니다. 그래도 이 모델이 여전히 '형태를 먼저 가정한 모델'인 까닭은 무엇일까요?

관절 하나로 직선이 나무를 이긴 것은, 두 답을 갈랐던 것이 '통계 대 기계학습'이 아니라 였기 때문이다. 그러므로 보고할 때 적어야 할 것은 이다.

확인 문제 6에 표와 함께 제출 →
체크포인트 3

같은 두 줄로 두 모델을 세워 계수 · 규칙 · 시험 오차 · 기온별 답을 모두 받아 보았고, 실제 값과 맞대었다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

  1. 찾은 것

    같은 353일·같은 훈련 282일로 배운 두 모델이 다른 문법으로 말한다 — 직선은 어디서나 같은 몫(+661대/°C), 나무는 자리마다 다른 칸(여덟 칸).

  2. 도구의 한계

    시험 RMSE는 누가 덜 빗나가는지만 말한다(380대 차이). '비 1mm 의 몫'을 한 문장으로 주는 것은 직선뿐이고, 그 문장도 직선 가정이 틀린 기온대에서는 틀린 문장이 된다.

  3. 보고의 규칙

    두 모델의 답을 함께 적고, 어느 자리에서 갈렸는지와 관측 범위(−14.1 ~ 33.4°C)를 함께 밝힌다. 훈련 오차와 시험 오차도 나란히 적는다.

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. 결정 트리가 맨 처음 '기온 ≤ 9.65°C' 에서 잘랐다. 이 사실이 알려 주는 것 하나와 알려 주지 않는 것 하나를 쓰시오.
📖 모범 답안

알려 주는 것 — 훈련 282일에서 대여를 가장 크게 가르는 것은 기온이고, 그 경계가 9.65°C 근처라는 것이다. 나무는 '어디서 자르면 양쪽이 가장 고르게 되나'를 따져 이 자리를 첫 갈림길로 골랐다.

알려 주지 않는 것 — 경계 너머에서 기온 1°C 가 몇 대의 몫인지는 말하지 않는다. 칸 안에서는 기울기가 없어서, 9.65°C 를 넘은 맑은 날은 18.5°C 까지 전부 23,977대 하나로 답한다. 인과도 알려 주지 않는다 — '9.65°C 를 넘기면 대여가 는다'는 뜻이 아니라, 이 자료에서 그 자리를 기준으로 갈랐을 때 양쪽이 가장 고르더라는 뜻이다. 덧붙여 이 자리는 이 훈련 282일에서 고른 자리라서, 나누기를 바꾸면 달라질 수 있다.

2. 시험 RMSE가 가령 통계적 회귀 6,800대, 결정 트리 5,000대였다고 하자. 시청 보고서에 '비가 1mm 많은 날은 대여가 몇 대 달라지는가'를 써야 한다면 어느 모델을 쓰겠는가? 그리고 그 답의 한계를 함께 쓰시오.
📖 모범 답안

통계적 회귀를 쓴다. 오차가 더 크더라도, '비 1mm 당 −280대'라는 단위 있는 숫자 한 개를 주는 것은 계수뿐이다. 결정 트리는 '비 ≤ 1.35mm 면 16,017대' 처럼 칸으로 답하므로 1mm 의 몫을 하나의 숫자로 주지 못한다.

한계 셋을 함께 밝힌다. ① 시험 오차가 더 큰 모델이라는 것을 적는다 — '설명을 위해 이 모델을 골랐고, 예측 정확도는 다른 모델이 더 낫다'고 써야 읽는 사람이 속지 않는다. ② 이 숫자는 '비의 몫이 어디서나 같다'는 가정 위에 있다. 실제로는 그렇지 않다 — 25°C 에서 비가 1.7 → 1.8mm 로 0.1mm 늘 때 직선은 28대만 줄지만 나무는 9,827대를 떨어뜨린다. 비의 효과가 자리마다 다르다는 신호다. ③ 인과가 아니다. 비가 온 날은 기온·요일도 함께 다를 수 있다.

3. 친구가 말한다. "LinearRegression 도 scikit-learn(기계학습 라이브러리)에 있고, 둘 다 같은 mean_squared_error 로 채점했으니 오늘 우리는 기계학습 모델 둘을 견준 것이다." 동의하는가? 근거를 들어 쓰시오.
📖 모범 답안

동의하지 않는다. 가르는 것은 도구 이름도, 채점하는 자가 같다는 것도 아니다. 두 가지가 가른다.

① 형태를 먼저 가정하느냐 — 통계적 회귀는 '대여 = 절편 + 기온×계수 + 강수×계수 + 쉬는날×계수' 라는 형태를 먼저 정하고 그 안의 숫자만 데이터에서 추정한다. 결정 트리는 형태를 정하지 않고 자를 변수와 자리를 데이터가 고르게 한다. 그래서 한쪽은 직선, 다른 쪽은 계단이 나온다.

② 무엇으로 말하느냐 — 한쪽은 '기온 1°C 당 +661대' 같은 계수의 문장으로, 다른 쪽은 규칙과 시험 오차로 말한다. 오히려 같은 도구·같은 두 줄(fit·predict)로 세웠기 때문에 '같은 데이터·같은 나누기, 다른 말투'라는 비교가 또렷해졌다.

덧붙여 mean_squared_error 는 누가 덜 빗나가는지만 재는 자다. 같은 자로 쟀다고 두 모델이 같은 종류가 되지는 않는다.

4. 깊이 3 결정 트리 규칙에 '쉬는날' 이 한 번도 나오지 않았다. "쉬는날은 대여와 관계없다"고 결론 내리면 무엇이 문제인가? 시뮬레이터의 귀 검사와 현장 기록, 그리고 표 2를 근거로 쓰시오.
📖 모범 답안

규칙에 없다는 것은 '쓰이지 않았다'는 뜻이지 '영향이 없다'는 뜻이 아니다. 깊이 3 에서는 갈림길이 일곱뿐인데, 더 크게 가르는 변수(기온·강수)가 그 일곱을 먼저 차지했다. 표 2를 보면 깊이를 4로 올리자 '쉬는날'이 처음 한 가지 나타나고, 깊이 8에서는 14가지가 된다.

판이 보여 준 것 — 귀 검사에서 ㉡(나무)은 −5°C 든 31°C 든 평일을 쉬는날로 바꿔도 1대도 움직이지 않았다. 그런데 현장 기록의 실제 차이(쉬는날 − 평일, 비 안 온 날)는 기온대마다 −1,738 · −4,605 · −587 · −2,898 · −4,846대였다. 영향이 없는 것이 아니라 나무가 듣지 못한 것이다.

직선도 다 맞은 것은 아니다. ㉠은 어디서나 −2,229대라고 답했는데, 실제 몫은 기온대마다 −587에서 −4,846까지 달랐다. 한쪽은 아예 못 듣고, 다른 쪽은 평균 한 숫자로 뭉갰다. 두 모델의 말을 맞대어 보아야 이것이 드러난다.

5. 관측한 가장 더운 날(33.4°C)보다 더 더운 날을 물으면 직선과 나무는 각각 어떻게 답하나? 둘 다 믿을 수 없는 이유를 서로 다르게 쓰시오.
📖 모범 답안

40°C 를 물으면 직선은 37,292대, 나무는 27,744대라고 답한다.

직선은 기울기(+661대/°C)를 끝없이 이어 붙인다. 4차시에서 본 '더운 끝의 꺾임'을 무시한 값이고, 반대쪽 끝에서는 −20°C 에 −2,361대라는 음수까지 낸다(−16.4°C 아래는 전부 음수다). 대여 수가 음수일 수는 없으니, 직선의 가정이 그 자리에서 깨진 것이 눈에 보인다.

나무는 마지막 칸 값을 그대로 낸다. 33.4°C 든 40°C 든 50°C 든 27,744대 하나다. 음수처럼 티 나는 값이 아니라서 오히려 틀린 줄 모르고 쓰기 쉽다.

둘 다 데이터가 없는 영역을 서로 다른 가정(계속 늘어난다 / 그대로다)으로 메운 것이고, 어느 가정도 데이터가 뒷받침하지 않는다. 그래서 보고할 때는 관측 범위(−14.1 ~ 33.4°C)를 함께 적고, 범위 밖 예측에는 표시를 단다.

6. 오늘의 본 과제입니다. 아래 비교표를 채우고, '31°C 맑은 평일에 몇 대를 준비할까'에 어느 모델의 말을 쓸지 근거와 함께 한 문장으로 쓰시오.
모델예측의 모양시험 RMSE기온의 영향을 말하는 문장틀리는 곳
통계적 회귀
결정 트리 깊이 3
📖 모범 답안

통계적 회귀 — 예측의 모양: 직선 한 줄(어디서나 같은 기울기). 시험 RMSE: 5,324. 기온의 문장: '기온이 1°C 높은 날은 평균 661대 더 나갔다'. 틀리는 곳: 더운 끝에서 계속 올라가 크게 넘치고 (31°C 31,344대 대 실제 24,507대), 추운 끝에서는 −16.4°C 아래가 음수가 된다.

결정 트리 깊이 3 — 예측의 모양: 계단(칸마다 한 값, 여덟 칸). 시험 RMSE: 4,944. 기온의 문장: 1°C 당 몫이 없다 — 기온별 예측표로만 답한다('18.5°C 를 넘은 맑은 날은 27,744대'). 틀리는 곳: 칸을 넘는 자리에서 0.1°C 에 7,959대가 뛰고, 배운 범위 밖은 평평하다(40°C 도 27,744대). 또 쉬는날을 규칙에 한 번도 쓰지 않았다.

한 문장 보고(예) — "두 모델 모두 31°C 맑은 평일의 실제(12일 평균 24,507대)를 넘겼으므로 어느 한쪽을 그대로 쓰지 않는다. 대수를 정해야 한다면 더 가까운 결정 트리의 27,744대에서 출발하되 (그래도 3,237대 넘친다), 그 값이 18.5°C 를 넘는 맑은 날 85일을 한 칸에 묶은 평균임을 함께 적는다. 설명이 목적이라면 직선의 계수를 쓰고, 예측이 목적이라면 나무의 표를 쓴다 — 목적이 판정을 정한다."

어느 쪽을 골랐든 둘의 답을 함께 적고 관측 범위(−14.1 ~ 33.4°C)를 밝혔다면 맞는 보고다. 모델 고르기는 14차시에서 다시 다룬다.

+
더 알아보기

상자 밖의 이야기 셋

두 문화 — 같은 자연, 다른 상자① 가정한 모형y = 절편 + 기온×계수 + …자연직선을 먼저 정하고계수를 추정한다데이터353일② 블랙박스속을 열지 않고 잘 맞히기만자연?데이터353일우리 실험 — 시험 71일 RMSE(작을수록 잘 맞힌다)직선만5,324나무 깊이 34,944직선 + 관절 하나4,741관절 하나(18.5°C)를 더한 직선이 나무를 이겼다 — 문화가 아니라 형태의 문제다
역사

두 문화 — 그리고 관절 하나

2001년, 랜덤 포레스트를 만든 통계학자 레오 브라이먼은 「Statistical Modeling: The Two Cultures」에서 데이터를 다루는 두 문화를 갈랐습니다. 하나는 데이터가 어떤 모형에서 나왔다고 가정하고 그 모형의 숫자를 추정하는 문화(오늘의 직선), 다른 하나는 속을 열지 않더라도 잘 맞히는 알고리즘을 찾는 문화(오늘의 나무)입니다. 그는 통계학계가 앞의 문화에만 머물러 있다고 비판했고, 논문 뒤에는 반론과 재반론이 함께 실렸어요.

그런데 오늘 우리가 한 실험은 그 경계가 생각보다 무르다는 것을 보여 줍니다. 직선에 관절 하나(18.5°C 를 넘은 만큼만 담는 열)를 더했더니 시험 RMSE가 5,324 → 4,741 로 내려가 나무(4,944)를 이겼습니다. 관절을 둘(4.95 와 18.5)로 하면 4,173 입니다. 직선이 졌던 까닭은 '통계 모델이라서'가 아니라 가정한 형태가 이 자료에 맞지 않아서였던 거예요. 문화의 차이라기보다 형태의 차이였고, 형태는 고칠 수 있습니다 — 고치려면 먼저 어디서 틀렸는지 알아야 하고, 그것을 보여 준 것이 나무였습니다.

도해: 두 문화를 상자 둘로 그렸다. 아래 세 막대는 시험 71일 RMSE — 직선 5,324 · 나무 4,944 · 관절 하나를 더한 직선 4,741(코드 ⑤). · 출처: L. Breiman, "Statistical Modeling: The Two Cultures", Statistical Science 16(3), 2001

칸 하나가 삼키는 것기온 18.5°C 넘는 맑은 날 칸 — 훈련 85일(18.8~33.4°C)22천25천28천31천20°C24°C28°C32°C칸이 내놓는 한 값 27,74430,37220~26°C 43일23,40228°C 이상 27일남은 15일은 18.8~20°C 와 26~28°C 사이에 있다한 칸 안에서 대여는 올랐다가 다시 내려간다.그런데 칸은 27,744대 하나만 말한다 —31°C 를 물어도 20~26°C 의 30,372대가 섞인 값이 나온다.
방법 더 깊이

칸 하나가 삼키는 것

나무가 31°C 맑은 평일에 27,744대라고 답한 것은, 그 날이 '기온 > 18.5 · 비 ≤ 1.75' 칸에 떨어졌기 때문입니다. 그 칸에 들어온 훈련 날은 85일, 기온으로는 18.8°C 부터 33.4°C 까지예요. 칸 값 27,744대는 그 85일의 평균입니다.

그런데 85일을 들여다보면 한 덩어리가 아닙니다. 20~26°C 인 43일은 평균 30,372대, 28°C 이상인 27일은 평균 23,402대였어요(남은 15일은 18.8~20°C 와 26~28°C 사이). 칸 안에서 대여는 올랐다가 다시 내려갑니다. 너무 더우면 자전거를 덜 타는 것이지요 — 4차시에서 잔차로 본 그 꺾임입니다.

나무는 이 오르내림을 칸 하나로 삼켜 버립니다. 그래서 31°C 를 물어도 20~26°C 의 시원한 날들이 섞인 27,744대가 나와 실제(24,507대)보다 넘치는 거예요. 칸이 클수록 한 값이 삼키는 것도 큽니다 — 깊이를 4로 올리면 이 칸이 다시 쪼개져 31°C 답이 23,021대로 바뀝니다(표 2).

도해: 기온 18.5°C 를 넘는 맑은 날 칸 85일. 주황 선이 칸이 내놓는 한 값 27,744대이고, 청록 띠 둘은 그 안의 두 무리다. 숫자는 원장이 브라우저에서 센 값.

깊이를 한 칸 올렸을 뿐인데같은 훈련 282일 · 같은 물음(31°C 맑은 평일)23천25천27천실제 12일 평균 24,5071·2·3·41556971081427,74423,021깊이쉬는날아래 줄 = 규칙이 '쉬는날' 을 쓴 가지 수깊이 3 에서 4 로 한 칸 올리면 31°C 답이27,744대에서 23,021대로 4,723대 움직인다.
다음 차시로

나무는 흔들린다 — 그래서 숲

깊이를 한 칸 바꿨을 뿐인데 같은 물음의 답이 크게 움직입니다. 31°C 맑은 평일에 대해 깊이 1은 23,957대, 깊이 2는 26,385대, 깊이 3은 27,744대, 그런데 깊이 4는 23,021대예요. 한 칸 사이에 4,723대가 움직였습니다. 직선이었다면 계수 하나가 조금 바뀔 뿐인데, 나무는 갈림길이 하나 더 생기면 칸의 경계 자체가 달라집니다.

깊이만 그런 것이 아닙니다. 훈련에 쓰는 날을 조금만 바꿔도 첫 가지가 다른 변수로 넘어갈 수 있어요. 코드 ①의 도전에서 씨앗을 42에서 7로 바꾸자 직선의 계수도 기온 +661 → +688, 쉬는날 −2,229 → −2,804 로 흔들렸지요. 하나의 모델이 내놓은 하나의 답을 그대로 믿기 어려운 까닭입니다.

흔들림을 줄이는 한 가지 방법은 나무를 여러 그루 기르는 것입니다. 표본을 조금씩 바꿔 가며 나무 수백 그루를 기르고 그 답의 평균을 쓰는 방법을 랜덤 포레스트라 하고, 브라이먼이 만들었어요. 14차시에서 세 번째 방법으로 씁니다. 성적표가 여러 장일 때 어느 것을 믿을지는 12차시에서 다룹니다.

도해: 나무 깊이 1~8 이 31°C 맑은 평일에 내놓는 답(꺾은선)과 실제 12일 평균 24,507대(점선). 아래 줄은 그 깊이의 규칙이 '쉬는날'을 쓴 가지 수. 숫자는 코드 ③과 원장 판 점검의 값.