단원 홈

Ⅲ. 데이터 모델링과 평가2차시

같은 물음을
네 가지 도구로

오류 없이 틀리는 자리는 어디인가

"공휴일에는 따릉이를 더 탈까, 덜 탈까?" 한 물음을 순수 파이썬 · SQL · pandas · 표 계산 네 도구에게 그대로 묻습니다. 세 도구는 소수 첫째 자리까지 같은 답을 냈습니다. 그런데 표를 한 번 잘못 만들자 SQL 은 오류를 한 줄도 내지 않고 빈 답을 내놓았습니다.

  • [12데과03-01]
  • 50분네 정거장
  • 오늘의 도구순수 파이썬 · SQL · pandas · 미니 시트 (+ 그림 도구 둘)
  • 자료서울 따릉이 하루 365일(UCI)
Ⅲ 단원 지도2 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    분석 도구의 다섯 갈래와 고르는 기준 넷(정확성 · 효율 · 재현성 · 접근성)을 말할 수 있다.

  2. 손으로

    한 물음을 네 도구로 물어 답을 맞대고, 오류 없이 틀리는 자리를 찾아낼 수 있다.

  3. 확인에서

    도구 여섯을 견준 비교표를 채우고, 어떤 조건에서 어느 도구가 나은지 까닭과 함께 적을 수 있다.

1
여는 장면 · 5분

네 개의 화면, 한 개의 물음 — "어느 것이 가장 좋은 도구인가?"

서울 따릉이의 하루 기록 365일이 표 하나로 있습니다. 여기에 물음 하나를 던집니다 — "공휴일에는 따릉이를 더 탈까, 덜 탈까?" 답을 내는 길은 여러 가지입니다. 아래 네 화면은 모두 같은 물음을 던진 것입니다.

반복문 열 줄, SQL 세 줄, pandas 한 줄, 스프레드시트 수식 한 칸. 길이가 이렇게 다른데 답은 같을까요? 그리고 어느 것이 가장 좋은 도구일까요? 먼저 손을 들어 하나를 골라 보세요.

고른 까닭을 옆 사람과 한 문장으로 나눈 뒤, 오른쪽 기사를 읽습니다.

시정 · 가상 기사

"공휴일에는 따릉이를 거의 타지 않는다" — 시 분석팀, 빈 답을 근거로 보고

담당자는 SQL 을 돌렸고 오류는 한 줄도 없었다 · 이 기사는 수업을 위해 지어낸 것입니다
그림 1같은 물음을 던진 네 화면세로 막대 = 그 도구가 적어야 하는 줄 수
순수 파이썬범용 언어합 = {"0": 0, "1": 0}수 = {"0": 0, "1": 0}for 행 in csv.DictReader(글): if 행["functioning"] != "1": continue 합[행["holiday"]] += int(행["rentals"]) 수[행["holiday"]] += 1공휴일 = 합["1"] / 수["1"]아닌 날 = 합["0"] / 수["0"]9줄SQL질의 언어SELECT holiday, AVG(rentals) FROM bike WHERE functioning = 1 GROUP BY holiday3줄pandas분석 라이브러리df[df.functioning == 1] .groupby("holiday")["rentals"].mean()1줄미니 시트표 계산H2 =AVERAGEIFS(G2:G366, F2:F366, 1, E2:E366, 1)1칸순수 파이썬범용 언어합 = {"0": 0, "1": 0}수 = {"0": 0, "1": 0}for 행 in csv.DictReader(글): if 행["functioning"] != "1": continue 합[행["holiday"]] += int(행["rentals"]) 수[행["holiday"]] += 1공휴일 = 합["1"] / 수["1"]아닌 날 = 합["0"] / 수["0"]9줄SQL질의 언어SELECT holiday, AVG(rentals) FROM bike WHERE functioning = 1 GROUP BY holiday3줄pandas분석 라이브러리df[df.functioning == 1] .groupby("holiday")["rentals"].mean()1줄미니 시트표 계산H2 =AVERAGEIFS(G2:G366, F2:F366, 1, E2:E366, 1)1칸

네 화면은 모두 "운영한 날만 골라 · 공휴일 여부로 묶어 · 대여 수의 평균"을 구합니다. 줄 수는 9 → 3 → 1 → 1칸으로 줄어듭니다. 줄이 줄어든 만큼 도구가 대신해 준 일이 늘었다는 뜻입니다. 자료: 서울 따릉이 하루 365일(UCI Seoul Bike Sharing Demand, CC BY 4.0) — 3정거장 코드 ①의 실제 코드

그림 2그런데 이 화면은 무엇일까같은 SQL · 같은 표 · 오류 0줄
화면 ① 표를 만든다CREATE TABLE bike ( date, temp, rain_mm, humidity, holiday, functioning, rentals)열 이름만 적었다 — 자료형은 비었다화면 ② 같은 물음을 던진다SELECT holiday, AVG(rentals) FROM bike WHERE functioning = 1 GROUP BY holiday[]오류 0줄 · 경고 0줄화면 ① 표를 만든다CREATE TABLE bike ( date, temp, rain_mm, humidity, holiday, functioning, rentals)열 이름만 적었다 — 자료형은 비었다화면 ② 같은 물음을 던진다SELECT holiday, AVG(rentals) FROM bike WHERE functioning = 1 GROUP BY holiday[]오류 0줄 · 경고 0줄

표를 만들 때 열마다 자료형을 적지 않았을 뿐인데, 같은 SQL 이 빈 답 [] 를 내놓았습니다. 빨간 글씨도, 트레이스백도 없습니다. 담당자는 이 화면을 보고 "공휴일에 탄 기록이 없다"고 읽었습니다. 자료: 3정거장 코드 ④의 실제 출력(원장 실측 — Pyodide 0.26.4 · SQLite 3.39.0)

먼저 예측

아직 아무것도 돌리지 않았습니다. 네 도구가 낸 답이 어떨지 한 문장으로 적어 보세요 — "넷 다 같을 것이다" · "하나만 다를 것이다" · "틀린 것은 오류로 알려 줄 것이다"처럼. 그리고 아래 빈 자리에 내가 고른 '가장 좋은 도구'와 그 까닭을 공책에 적어 둡니다. 3정거장 미션 ①에서 여러분의 예측과 도구의 실제 반응을 맞대어 봅니다.

순수 파이썬
내 예측9줄✓답이 나온다!다른 답✕오류로 멈춤하나에 동그라미
SQL
내 예측3줄✓답이 나온다!다른 답✕오류로 멈춤하나에 동그라미
pandas
내 예측1줄✓답이 나온다!다른 답✕오류로 멈춤하나에 동그라미
미니 시트
내 예측1칸✓답이 나온다!다른 답✕오류로 멈춤하나에 동그라미
체크포인트 1

같은 물음을 던진 네 화면을 보았고, 오류 없이 빈 답이 나온 화면을 하나 만났다 — 아직 무엇이 맞는지는 모른다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

도구는 다섯 갈래, 고르는 기준은 넷

2-1다섯 갈래 — 무엇을 대신해 주는가로 갈린다

데이터를 다루는 도구는 수십 가지지만, 무엇을 대신해 주느냐로 묶으면 다섯 갈래입니다. 같은 물음에 같은 답을 내더라도 갈래가 다르면 내가 적어야 하는 줄과 도구가 몰래 정해 버리는 것이 다릅니다.

표 1분석 도구의 다섯 갈래이 교과서가 실제로 돌려 보는 것은 앞의 네 갈래
갈래보기도구가 대신해 주는 것이 교과서에서
범용 언어 파이썬 표준 라이브러리(csv) 거의 없다 — 모든 것을 내가 적는다 Ⅰ-1부터 · 오늘 9줄
질의 언어 SQL(sqlite3) 거르기 · 묶기 · 더하고 나누기(AVG 한 낱말) Ⅰ-6에서 배움 · 오늘 3줄
분석 라이브러리 pandas · scikit-learn · 통계 언어 R 묶기 · 평균 · 모델 · 자료형 판단까지 Ⅰ-5부터 · 오늘 1줄
표 계산 스프레드시트 — 오늘은 교과서 안 미니 시트 표를 화면에 띄우는 일 · 조건 붙은 평균(AVERAGEIFS) 오늘 처음 · 1칸
시각화·대시보드(BI) 여러 회사의 BI 도구 그림 고르기 · 판 짜기 — 끌어 놓으면 된다 돌려 보지 않는다 — 까닭은 확인 문제 6

Ⅰ-6 에서 가져옴SQL 은 CREATE TABLE 로 표를 만들고 WHERE 로 거르고 GROUP BY 로 묶습니다. 오늘은 새 문법 없이 이 셋만 다시 씁니다 — 표 이름도 그때와 같은 bike 입니다.

Ⅲ-1 에서 가져옴따릉이를 운영하지 않은 날(functioning = 0)은 대여가 0대로 적혀 있습니다. 그 날을 함께 세면 평균이 끌려 내려가므로 운영한 날만 셉니다.

도구를 고르는 나침반 — 네 방향을 차례로

  1. 정확성답이 맞는가 — 다른 도구의 답과 맞대어 보았나
  2. 효율데이터가 커져도 되나 — 첫 준비(내려받기)까지 더해서
  3. 재현성남이 다시 돌려 볼 수 있나 — 무엇을 어떻게 셌는지가 남는가
  4. 접근성모두가 쓸 수 있나 — 설치·계정·기기·운영체제에 매이지 않는가

이 넷은 서로 바꿔 먹는 관계입니다. 가장 빠른 도구가 늘 답은 아니에요 — 계산이 47.2밀리초인데 첫 준비에 몇 초가 걸린다면, 한 번만 쓰는 자리에서는 느린 도구가 더 빠릅니다.

2-2도구가 조용히 틀리는 자리

프로그램이 틀리면 대개 오류가 납니다. 빨간 글씨가 뜨고 멈추지요. 그런데 데이터 도구에는 틀렸는데 아무 말도 하지 않는 자리가 있습니다.

SQL 에서 표를 만들 때 열마다 자료형(숫자인지 글자인지)을 적지 않으면, 숫자가 전부 글자로 저장됩니다. 그 표에 functioning = 1 이라고 물으면, 글자 "1" 과 숫자 1 은 결코 같지 않으므로 어느 날도 걸리지 않습니다 — 답은 빈 목록 [] 입니다. 오류는 한 줄도 없습니다.

반대 방향도 있습니다. temp > 30 이라고 물으면 365일 모두가 걸립니다. SQLite 는 글자를 언제나 숫자보다 크다고 보기 때문입니다. 바른 표에서는 24일이지요.

더 무서운 것은 두 실수가 서로를 지울 때입니다. 자료형 없는 표에 파이썬 코드에 있던 따옴표를 그대로 옮겨 functioning = '1' 이라고 물으면, 12,699.7 이라는 맞는 답이 멀쩡히 나옵니다. 표도 틀렸고 조건도 옮겨 적기만 한 것인데 답은 맞습니다.

규칙도구가 둘 이상이면 서로의 답을 맞춰 보는 것이 곧 검증이다. 보고서에는 답만 적지 말고 어느 도구로 무엇을 어떻게 셌는지를 함께 적는다.

2-3도구보다 먼저 정할 것 — 대표값과 견줌의 공정함

어느 도구도 대신 정해 주지 않는 것이 둘 있습니다. 무엇을 셀지와 무엇으로 대표할지입니다. 아래 네 쌍은 같아야 할 것 같은 두 숫자가 다른 자리입니다 — 그 차이가 곧 사람이 정한 몫입니다.

표 2같은 자료, 세 가지 셈운영한 날만 · 단위 대
어떻게 셌나공휴일아닌 날차이날 수(공휴일·아닌 날)
평균12,699.717,727.4−5,027.717 · 336
중앙값7,184.019,104.5−11,920.517 · 336
같은 달끼리 견준 평균달마다 다르다달마다 다르다−2,653.517 · 336

셋 다 같은 365일을 센 값입니다. 바뀐 것은 대표값(평균이냐 중앙값이냐)과 견주는 방식(전체끼리냐 같은 달끼리냐)뿐인데, 차이가 −2,653.5에서 −11,920.5까지 네 배 넘게 흔들립니다. 이 둘은 도구가 정해 주지 않습니다. 자료: 서울 따릉이 하루 365일 — 3정거장 코드 ①·⑥과 실험실이 찍는 값

평균을 낸 날 수
17공휴일(일)
vs
336아닌 날(일)
공휴일17아닌 날336

열일곱 날의 평균이다 — 몇 날이 평균을 흔든다.

자료가 표시한 공휴일과 평균에 쓴 공휴일
18표시된 공휴일(일)
인데
17평균에 쓴 날(일)
표시18쓴 날17

하루는 운영하지 않은 날이라 뺐다 — 그 결정은 사람이 했다.

공휴일과 아닌 날의 하루 평균 기온
9.7공휴일(℃)
vs
12.9아닌 날(℃)
공휴일9.7아닌 날12.9

공휴일이 더 추운 날에 몰려 있었다.

운영한 공휴일 가운데 12~3월에 든 날
912~3월(일)
/
17공휴일 전부(일)
12~3월9전부17

절반이 넘는다 — '겨울이라 적다'와 가를 수 없다.

자료: 서울 따릉이 하루 365일 — 위 네 쌍은 모두 3정거장 코드 ①·⑥과 실험실이 찍는 값이다. 평균과 중앙값의 차이(−5,027.7 · −11,920.5)와 같은 달끼리 견준 차이(−2,653.5)는 표 2에 있다.

2-4두 달 뒤에도 같은 답이 나오는가 — 재현성

정확성과 효율은 오늘 한 번의 이야기입니다. 재현성은 다릅니다 — 두 달 뒤의 나, 또는 옆 반의 친구가 같은 자료로 같은 답을 얻을 수 있는가를 묻습니다.

9월 26일에 만든 시트가 있다고 해 봅시다. 그때 파일에는 299일이 들어 있었고, 공휴일 평균 칸에 AVERAGEIFS(G2:G300, …) 이라고 적었습니다. 파일 끝과 범위가 딱 맞았으니 아무 문제가 없었지요.

두 달 뒤 66일이 파일에 붙습니다. 코드로 쓴 분석은 다시 돌리면 12,699.7 로 바뀌는데, 시트의 그 칸은 11,596.6 그대로입니다. 범위가 300행에서 멈춰 있기 때문입니다. 빠진 66일 안에는 개천절 하루에만 30,349대가 있었습니다.

더 고약한 일은 동료가 표를 대여 내림차순으로 정렬했을 때 일어납니다. 같은 칸이 위에서 299줄을 세므로 이제는 공휴일 20,875.0 대 아닌 날 19,933.4 — "공휴일에 더 탄다"로 결론이 뒤집힙니다.

코드는 무엇을 어떻게 셌는지가 글자로 남습니다. 시트의 칸은 결과만 보입니다 — 어느 범위를 잡았는지는 그 칸을 눌러 보기 전에는 아무도 모릅니다. 이것이 재현성의 차이입니다.

미니 시트 H2같은 칸, 두 시점
G열 · 366행2~30066일칠한 곳만 센다H2=AVERAGEIFS(G2:G300, F2:F300, 1, E2:E300, 1)범위는 만들 때 그대로다→ 칸은 66일을 세지 않는다
두 달 뒤 시트 칸
11,596.6
두 달 뒤 코드
12,699.7

자료: 실험실 장면 ④(교사)가 단추 둘로 재현하는 값과 같다

그림 3두 달 뒤의 같은 시트왼쪽 = 만들 때 · 오른쪽 = 두 달 뒤
① 9월 26일에 만든 시트파일이 담은 날299일공휴일 16일 평균11,596.6아닌 날 279일 평균17,133.1수식이 잡은 범위G2:G300이때는 범위가 파일 끝과 딱 맞았다② 두 달 뒤 — 66일이 붙었다코드가 다시 낸 답12,699.7같은 시트 칸11,596.6빠진 10월 3일 대여30,349동료가 정렬한 뒤 같은 칸20,875.0정렬 뒤에는 공휴일이 아닌 날(19,933.4)보다 높다① 9월 26일에 만든 시트파일이 담은 날299일공휴일 16일 평균11,596.6아닌 날 279일 평균17,133.1수식이 잡은 범위G2:G300이때는 범위가 파일 끝과 딱 맞았다② 두 달 뒤 — 66일이 붙었다코드가 다시 낸 답12,699.7같은 시트 칸11,596.6빠진 10월 3일 대여30,349동료가 정렬한 뒤 같은 칸20,875.0정렬 뒤에는 공휴일이 아닌 날(19,933.4)보다 높다

시트의 칸은 아무것도 바뀌지 않았는데 답이 틀려집니다 — 자료가 바뀌었기 때문입니다. 정렬까지 하면 같은 칸이 반대 결론을 냅니다. 자료: 서울 따릉이 365일 가운데 앞 299일(2017-12-01 ~ 2018-09-25)과 전체 — 원장 실측

체크포인트 2

도구의 다섯 갈래와 고르는 기준 넷을 말할 수 있고, 오류 없이 틀리는 자리가 어디인지 안다. 이제 직접 도구에게 건네 본다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

같은 물음을 네 도구에게 건네고, 답을 맞대어 본다

1

통역 탁자 — 파이썬 아홉 줄을 세 도구에게 건넨다

10분

여는 장면에 적어 둔 내 예측입니다. 도구가 틀리면 정말 오류로 알려 줄까요?

실험실 아래 「통역 탁자」는 파이썬 아홉 줄을 일곱 장의 띠로 뜯어 둔 탁자입니다. 띠 한 장이 곧 파이썬 코드 한 토막이에요. 띠를 도구 칸의 자리에 건네면 그 도구의 말로 옮겨 적힙니다. 자리가 없는 띠는 도구의 입 — 도구가 스스로 알아서 해 버리는 곳 — 에 넣습니다. 심판은 순수 파이썬이 낸 답(12,699.7 / 17,727.4)이고, 램프는 그 도구의 진짜 반응입니다.

차례는 이렇습니다 — SQL 칸 3분 → pandas 칸 2분 → 미니 시트 칸 1분 → 중앙값 2분. 칸마다 예측을 먼저 고른 뒤 [돌리기]를 누르세요. 도전 셋을 풀면 카드가 스스로 닫힙니다.

시뮬레이터

통역 탁자

아홉 줄이 한 줄로 옮겨질 때 사라지는 것은 무엇인가

  1. 1띠를 골라 도구 칸의 자리에 건넨다(자리가 없으면 '입')
  2. 2내 예측을 골라 잠근다
  3. 3[돌리기]를 눌러 도구의 진짜 반응을 본다
장면
도구 칸
대표값 — 사람이 정한다
손질 — 띠를 그대로 옮길까, 고칠까
미니 시트 수식 범위
장면 ③ — 두 달 뒤
내 예측 — 고르면 잠기고 [돌리기]가 켜진다
① 통역 탁자 · SQL 칸띠를 골라 자리에 건네세요

램프 — ✓ 초록: 답이 나왔다 · ! 호박: 오류 없이 다른 답 · ✕ 빨강: 오류로 멈췄다. 초록은 '맞다'는 뜻이 아니다 — 심판(12,699.7 / 17,727.4)과 같아야 맞다.

노란 테두리 = 두 실수가 서로를 지운 자리 — 틀린 표에 틀린 조건을 주었는데 답이 맞는다. 띠 4(판단)는 어느 도구도 받지 않는다 — 무엇을 셀지는 사람이 정한다.

공휴일 하루 평균—대
아닌 날—
차이—
심판과—
램프—
건넨 띠0/4
도전 1

SQL 칸이 오류 한 줄 없이 '결과 0행'을 내게 해 보라. 어떤 띠를 어디에 두었을 때 그렇게 되는가?

도전 2

자료형이 없는 표인데 심판과 똑같은 답이 나오는 자리를 찾아라 — 두 실수가 서로를 지운 자리다.

도전 3

장면 ②에서 파이썬과 SQL 이 나란히 80을 내게 하라. 정답은 24다 — 같다는 것이 맞다는 뜻이 아님을 보여라.

자료: 서울 따릉이 하루 365일(UCI Seoul Bike Sharing Demand, CC BY 4.0 · DOI 10.24432/C5F62R)을 쪽 안에 실었다 — 코드 ①~⑥이 읽는 ../data/seoul_bike_daily.csv 와 같은 값이다. 램프의 반응과 숫자는 브라우저에서 실제로 돌려 재어 둔 값이다(Pyodide 0.26.4 · SQLite 3.39.0 · pandas 2.2.0).

기본 탁자에서 초록이 된 줄을 코드 ①의 빈칸에 그대로 옮겨 치세요. 빈칸 ①은 SQL 의 WHERE 와 GROUP BY 두 곳, 빈칸 ②는 pandas 의 groupby 한 줄입니다. 세 도구의 답이 소수 첫째 자리까지 같은지 확인합니다.

도전 SQL 함수 안의 f"{c} REAL" 을 f"{c}" 로 바꿔 보세요 — 자료형을 안 적은 표가 됩니다. 탁자의 램프가 보여 준 것과 같은 일이 실제 코드에서 일어납니다.

탐구 순수 파이썬 함수는 행["holiday"] 를 글자 "1"·"0" 으로 쓰는데 pandas 는 숫자 1·0 으로 씁니다. 왜 그런지, 그 차이가 어디서 생겼는지 적어 보세요.

세 도구가 같은 답을 냈다. 그런데 램프가 초록이어도 일 수 있으므로, '어느 도구를 써도 된다'고 말하려면 말고도 와 를 함께 따져야 한다.

확인 문제 1에 적어 제출 →

미니 시트에서 겪은 것은 확인 문제 3에 따로 적습니다.

2

그림 도구도 둘이다 — 같은 막대 두 개를 두 도구로

3분

이제 같은 막대 두 개를 그립니다. 하나는 이 교과서의 chart, 다른 하나는 데이터 과학자가 쓰는 matplotlib 입니다. 몇 줄씩 들까요? 그리고 어느 칸이 더 오래 걸릴까요? 까닭까지 짐작해 두세요.

이 차시는 이 책에서 두 그림 도구가 한 쪽에 함께 나오는 유일한 자리입니다 — 새 문법은 없습니다(matplotlib 은 Ⅱ-6 에서 배웠습니다).

기본 코드 ②와 코드 ③은 채워져 있습니다. 차례로 ▶ 실행하고, 그림 아래 세 줄(줄 수 · 새로 내려받은 것 · 쓸 수 있는 곳)을 비교표에 옮겨 적으세요.

코드 ③은 처음 실행에 몇 초 걸립니다 — 고장이 아니라 matplotlib 과 한글 글꼴을 처음 받는 중입니다(쪽마다 한 번). 그 몇 초가 곧 비교표의 '첫 준비' 칸입니다.

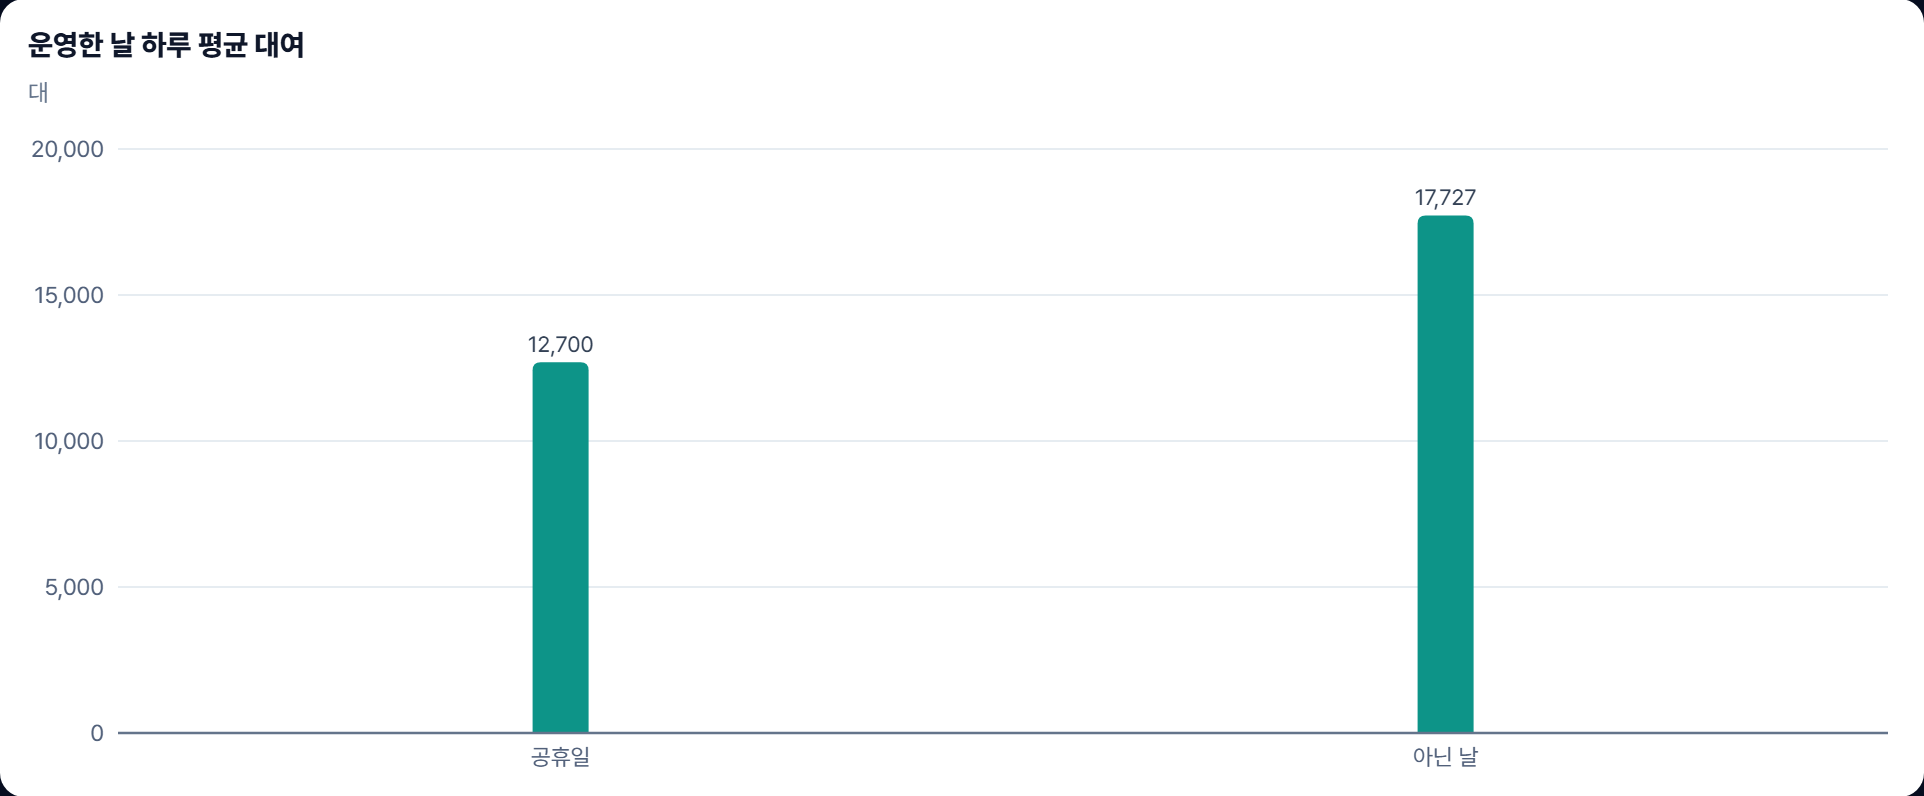
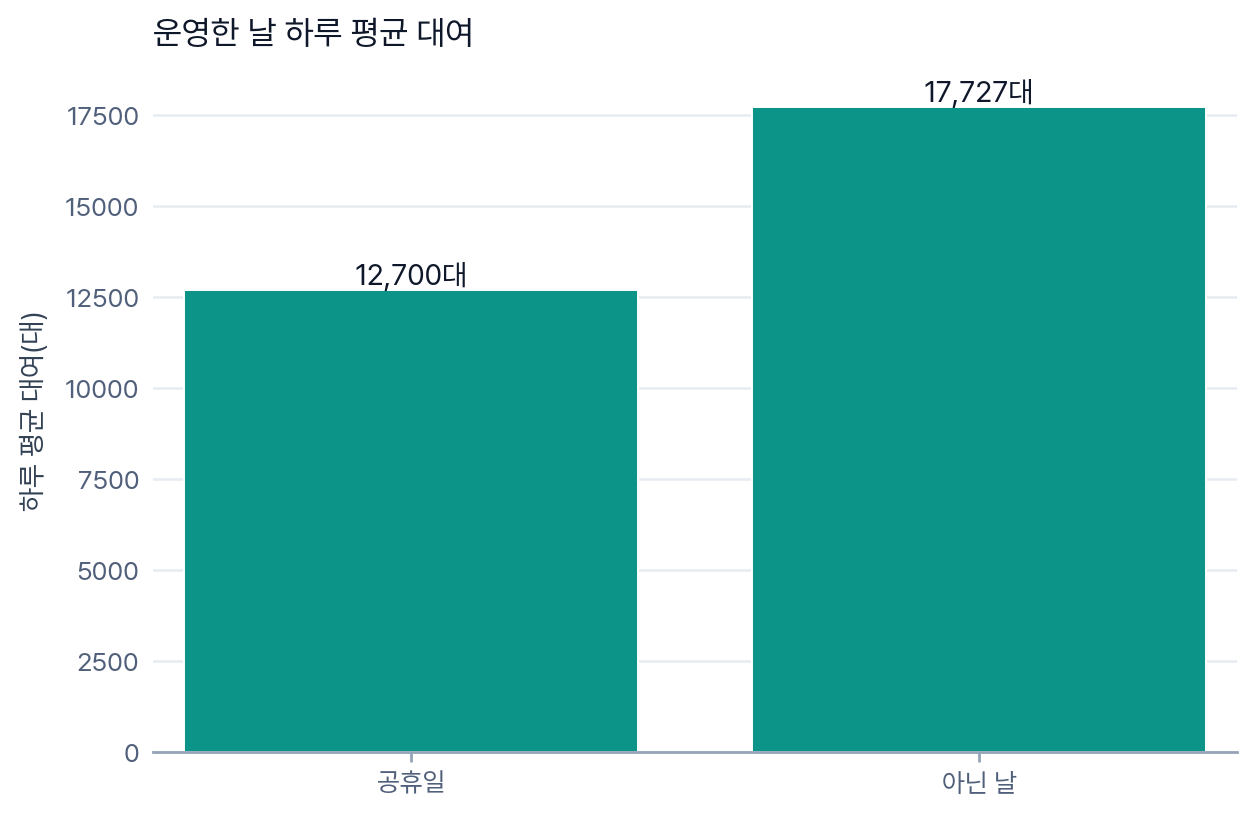
도전 코드 ③의 ax.bar 줄 뒤에 ax.set_ylim(10000, 18000) 한 줄을 넣어 보세요. 막대가 2,700 대 7,727 로 보여 약 2.9배 차이처럼 읽힙니다 — 실제 비는 1.4배입니다. 축을 내가 정한다는 것은 이렇게 속일 수도 있다는 뜻입니다(Ⅱ-7).

탐구 chart 가 그린 막대 둘은 폭이 유난히 좁습니다. 왜 그럴까요? 막대가 둘뿐일 때 폭을 어떻게 정해야 좋을지, 무엇을 기준으로 삼을지 생각해 보세요.

학교 무선망에서 반 전체가 동시에 처음 실행한다면 가 낫고, 내 분석을 친구가 주피터·코랩에서 다시 돌려 본다면 가 낫다. '좋은 도구'라는 말에는 를 반드시 붙여야 한다.

확인 문제 4의 비교표에 적어 제출 →
3

오류 없이 틀리는 자리, 100배가 되면 갈리는 자리

2분

코드 ④는 같은 SQL 을 표 두 개에 보냅니다. 하나는 자료형을 적은 표, 하나는 적지 않은 표입니다. 오류가 날까요, 다른 답이 나올까요, 그대로일까요?

코드 ⑤는 같은 표를 100번 이어 붙인 36,500행에서 시간을 잽니다. 가장 빠른 도구와 가장 느린 도구를 먼저 적어 두세요.

기본 코드 ④를 그대로 ▶ 실행합니다. 이 칸은 일부러 틀린 길을 한 번 겪어 보는 칸이에요 — 나오는 [] 와 365 는 고장이 아니라 오늘 배울 결과입니다.

도전 q1 의 functioning = 1 을 functioning = '1' 로 바꿔 보세요. 틀린 표가 [('0', 17727.4), ('1', 12699.7)] — 맞는 답을 냅니다. 두 실수가 서로를 지운 자리입니다.

기본 이어서 코드 ⑤를 ▶ 실행해 내 화면에서 잰 값을 비교표에 적습니다. 같은 도구를 세 번 재어도 값이 흩어지는 것을 눈여겨보세요.

도전 몸 * 100 을 몸 * 300 으로 바꾸면 어느 도구의 시간이 세 배가 되고 어느 도구가 덜 늘어나는지 보세요.

탐구 세 번 잰 값이 흩어지는 폭을 근거로, '한 번 잰 값'을 믿지 않는 까닭을 한 줄로 적어 보세요. 기계와 그날의 형편에 따라 순서까지 바뀔 수 있습니다.

오류가 없는데도 틀린 것을 알아챌 단서는 와 둘이다. 원인은 이다.

확인 문제 2에 적어 제출 →
4

비교표를 채운다 — 도구 여섯을 한 장에

5분

마지막으로 대표값을 바꿔 봅니다. 평균 대신 중앙값으로 물으면 차이는 커질까요, 작아질까요? 그리고 도구마다 몇 줄이 들까요?

도전 칸 코드 ⑥은 mean 을 median 으로 바꾼 것이 전부입니다. pandas 는 낱말 하나로 끝나지만 SQL 은 어떻게 되는지 보세요.

기본 이제 아래 확인 문제 4의 비교표를 채웁니다 — 계산 도구 넷(순수 파이썬 · SQL · pandas · 미니 시트)과 그림 도구 둘(chart · matplotlib), 모두 여섯 줄입니다. 줄 수 · 36,500행 시간 · 첫 준비 · 남이 다시 돌리기 · 틀리기 쉬운 자리 다섯 칸을 오늘 본 것으로 채우세요.

탐구 표를 다 채운 뒤, R 과 BI 도구는 왜 이 표에 없는지 한 줄로 적습니다 — 교육과정이 말하는 도구 선정 기준(인지 부담이 적고 기기·운영체제에 비교적 독립적인 도구)으로 답하세요.

'공휴일에는 따릉이를 덜 탄다'고 쓰기 전에 와 를 확인해야 한다. 시청 보고서에는 을 쓰고 를 함께 적겠다.

확인 문제 5에 적어 제출 →
체크포인트 3

한 물음을 네 도구로 물어 답을 맞대었고, 오류 없이 틀리는 자리를 직접 만들어 보았고, 도구 여섯을 견준 표를 손에 넣었다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

  1. 찾은 것

    세 도구가 소수 첫째 자리까지 같은 답을 냈다 — 그러나 같은 답이 맞는 답이라는 뜻은 아니었다. 자료형 없는 표는 오류 한 줄 없이 빈 답과 365일을 냈고, 파이썬과 SQL 은 나란히 80이라고 틀렸다.

  2. 도구의 한계

    도구는 대신해 주는 것이 저마다 다르다 — SQL 은 AVG 한 낱말에 더하기·세기·나누기를 담고, pandas 는 자료형까지 스스로 정하며, 시트는 쓴 범위를 기록으로 남기지 않는다. 무엇을 셀지와 대표값은 어느 도구도 정해 주지 않는다.

  3. 보고의 규칙

    도구가 둘 이상이면 서로의 답을 맞춰 보는 것이 곧 검증이다. 보고서에는 답과 함께 어느 도구로 · 무엇을 · 어떤 대표값으로 · 몇 날을 셌는지를 적는다.

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. 세 도구의 답이 소수 첫째 자리까지 같았다. 그렇다면 "어느 도구를 써도 된다"고 결론 내려도 되는가? 도구를 고르는 기준 넷(정확성 · 효율 · 재현성 · 접근성) 가운데 둘을 들어 답하시오.
📖 모범 답안

아니다. 정확성은 같아도 나머지 기준이 다르다.

효율 — 36,500행에서 재면 pandas 47.2ms · SQL 176.4ms · 순수 파이썬 225.6ms 로 갈린다. 다만 '첫 준비'까지 더해야 한다. chart 는 내려받기가 0이라 곧바로 그리는데 matplotlib 은 첫 실행에 몇 초가 걸린다 — 한 번만 쓰는 자리에서는 계산이 빠른 도구가 오히려 늦다.

재현성 — 코드는 무엇을 어떻게 셌는지가 글자로 남아 두 달 뒤에도 다시 돌릴 수 있지만, 시트의 칸은 결과만 보인다. 9월 26일에 잡은 범위(G2:G300)가 두 달 뒤에도 그대로여서 코드는 12,699.7 로 바뀌는데 시트는 11,596.6 에 멈춰 있었다.

(접근성·배우는 부담도 답이 된다 — 설치와 계정이 필요한 도구는 모두가 쓸 수 없다.) 목적과 데이터 크기, 그리고 누가 다시 볼 것인지로 고른다.

2. 자료형 없이 만든 SQL 표에서 '30도 넘는 날'이 365일로 나왔다. 오류가 한 줄도 없었는데도 틀린 것을 알아챌 수 있는 단서 둘과 그렇게 된 원인을 쓰시오.
📖 모범 답안

단서 ① 결과가 상식과 어긋난다 — 서울에서 1년 내내 30도를 넘었다는 말이 된다. 단서 ② 다른 도구가 센 값과 다르다 — 자료형을 적은 표에서는 24일이다. (같은 물음을 두 도구에 던져 맞춰 보는 것이 곧 검증이다.)

원인 — 표를 만들 때 열마다 자료형을 적지 않아 숫자가 전부 글자로 저장되었다. SQLite 는 글자와 숫자를 견줄 때 글자를 언제나 숫자보다 크다고 보므로 temp > 30 이 365일 모두 참이 된다. 같은 까닭으로 functioning = 1 은 어느 날도 참이 아니어서 답이 [] 가 되었다 (typeof(temp) 가 text 로 나오는 것이 증거다).

3. 미니 시트에서 수식 범위를 G2:G300 으로 두었더니 공휴일 평균이 11,596.6 으로 나왔다(끝까지 잡으면 12,699.7). 스프레드시트로 같은 계산을 할 때 코드보다 나은 점 하나와 위험한 점 하나를 이 경험으로 쓰시오.
📖 모범 답안

나은 점 — 설치도 내려받기도 없이 표를 눈으로 보면서 바로 계산한다. 수식을 치면 쓴 범위가 표에 곧바로 칠해지므로 지금 무엇을 세고 있는지가 화면에 보인다.

위험한 점 — 어느 칸에 어떤 범위를 썼는지가 기록으로 남지 않는다. 범위가 300행에서 끊긴 것 같은 실수가 조용히 결과를 바꾸고(66일이 빠졌고 그 안에는 30,349대가 나간 개천절이 있었다), 남이 다시 확인하려면 칸을 하나하나 눌러 보아야 한다. 자료가 늘거나 누가 정렬만 해도 같은 칸이 다른 답을 낸다.

4. 오늘 만난 도구 여섯을 아래 표에 정리하시오(모르는 칸은 —). 그리고 표 아래에, 같은 막대 두 개를 chart 는 한 줄·내려받기 0으로, matplotlib 은 여섯 줄·약 7MB + 글꼴로 그렸다는 사실을 근거로 ① 반 전체가 학교 무선망에서 동시에 처음 실행할 때 ② 내 분석을 친구가 주피터·코랩에서 다시 돌려 볼 때 각각 어느 쪽이 나은지 까닭과 함께 쓰시오.
도구코드 줄 수36,500행 시간첫 준비(내려받기)남이 다시 돌리기틀리기 쉬운 자리
순수 파이썬
SQL
pandas
미니 시트
chart(그림)
matplotlib(그림)
📖 모범 답안

표(보기) — 순수 파이썬: 9줄 / 225.6ms / 없음 / 코드가 남아 쉽다 / 글자와 숫자를 헷갈린다(int() 를 빠뜨리면). SQL: 3줄 / 176.4ms / 없음(꾸러미는 받는다) / 질의문이 남아 쉽다 / 표를 만들 때 자료형을 안 적으면 조용히 틀린다. pandas: 1줄 / 47.2ms / 없음(꾸러미는 받는다) / 코드가 남아 쉽다 / 자료형을 도구가 정하므로 누가 정했는지 모른 채 지나간다. 미니 시트: 1칸 / — / 없음 / 어렵다 — 쓴 범위가 기록에 없다 / 범위가 끊기거나 정렬하면 답이 바뀐다. chart: 한 줄 / — / 0 / 이 교과서 밖에서는 안 된다 / 축을 내가 정할 수 없다. matplotlib: 여섯 줄 / — / 약 7MB + 한글 글꼴(첫 실행 몇 초) / 어디서나 된다 / 축을 내가 정할 수 있어 속일 수도 있다.

① chart. 추가로 내려받는 것이 없어 망이 붐벼도 곧바로 그린다(matplotlib 은 첫 준비에 몇 초, 반 전체가 동시에 받으면 더 오래 걸린다).

② matplotlib. chart 는 이 교과서 안에만 있는 도구라 주피터·코랩에서는 import chart 부터 실패한다 — 재현성이 갈린다.

그래서 '좋은 도구'는 조건을 붙여야 말할 수 있다. 계산 도구(순수 파이썬 ↔ pandas)도 마찬가지다.

5. 공휴일 평균(12,699.7대)이 아닌 날(17,727.4대)보다 낮았다. "공휴일에는 따릉이를 덜 탄다"고 쓰기 전에 확인해야 할 것 둘을 숫자를 들어 쓰시오.
📖 모범 답안

① 대표값과 날 수 — 평균을 낸 공휴일은 17일뿐(아닌 날은 336일)이라 몇 날이 평균을 크게 흔든다. 중앙값으로 재면 7,184.0 대 19,104.5 로 차이가 −5,027.7 에서 −11,920.5 로 두 배 넘게 벌어진다. 평균만 쓰지 말고 중앙값과 날 수를 함께 적는다.

② 견줌의 공정함 — 운영한 공휴일 17일 가운데 9일이 12~3월이다. '공휴일이라 적다'와 '겨울이라 적다'가 섞여 있다. 같은 달끼리 견주면 차이가 −2,653.5 로 절반쯤 줄어든다. 기온을 함께 넣은 비교가 필요하다(3차시 회귀).

(덧붙여, 자료가 공휴일로 표시한 날은 18일인데 그 가운데 하루는 운영하지 않은 날이어서 평균에서 뺐다 — 무엇을 셀지는 도구가 아니라 사람이 정한 것이므로 보고서에 밝혀 적는다.)

6. 이 교과서는 통계 언어 R 과 BI 도구를 표로만 소개하고 실습하지 않았다. 그 까닭을 교육과정의 도구 선정 기준으로 설명하고, 그래도 그 도구를 쓰면 좋은 상황을 하나 들으시오.
📖 모범 답안

까닭 — 교육과정 해설은 인지 부담이 적고 기기·운영체제에 비교적 독립적인 도구를 쓰라고 말한다. R 과 BI 도구는 대체로 설치나 계정이 필요하고 기기·운영체제에 따라 되기도 안 되기도 해서 교실의 모든 학생에게 같은 조건을 보장하기 어렵다. 이 교과서의 파이썬·SQL·시트는 모두 브라우저 안에서 돌아 설치 없이 누구나 같은 화면을 본다 — 접근성 기준을 먼저 둔 선택이다.

쓰면 좋은 상황 — R 은 통계 분석을 논문처럼 그대로 다시 재현해야 할 때(전문 통계 꾸러미가 넓다), BI 는 같은 판을 여러 사람이 날마다 보아야 할 때(자료가 바뀌면 판이 저절로 갱신된다)가 그런 자리다.

+
더 알아보기

탁자 밖의 이야기 셋

한 칸을 고치면 딸린 칸이 다시 계산된다이 두 칸이 바뀌면 오른쪽 칸이 스스로 다시 계산된다ABCD21월12035=B2+C232월9840=B3+C343월14028=B4+C45합=SUM(B2:B4)=SUM(C2:C4)=SUM(D2:D4)비지칼크 1979 — 애플 Ⅱ· 수식을 적는 사람 = 표를 쓰는 사람· 바뀐 칸만 다시 계산 — 지우고 다시 쓰지 않는다· 설치할 문법이 거의 없다
역사

비지칼크 — 표 계산이 모두의 도구가 된 날

1979년, 하버드 경영대학원 학생 댄 브릭클린은 칠판 가득한 표에서 숫자 하나가 바뀔 때마다 교수가 줄줄이 지우고 다시 쓰는 것을 보고 있었습니다. 그는 "한 칸을 고치면 딸린 칸이 저절로 다시 계산되는 칠판"을 떠올렸고, 밥 프랭크스턴과 함께 애플 Ⅱ용 프로그램 비지칼크(VisiCalc)를 만들었습니다.

비지칼크가 바꾼 것은 계산 속도가 아니라 계산하는 사람이었습니다. 그전까지 계산을 바꾸려면 프로그래머에게 부탁해야 했지만, 이제는 표를 쓰는 사람이 칸에 수식을 적어 "이 값이 이만큼 달라지면?"을 스스로 물을 수 있게 되었지요. 회계 담당자가 컴퓨터를 사기 시작했고, 사람들은 애플 Ⅱ 를 "비지칼크를 돌리는 기계"라고 불렀습니다. 지금도 데이터 분석의 첫걸음이 스프레드시트인 까닭이 여기에 있습니다 — 설치할 것도, 배울 문법도 거의 없이 표가 바로 보인다. 오늘 미니 시트에서 수식 한 칸으로 12,699.7 을 얻은 그 손맛이 1979년에 처음 생긴 것입니다.

도해: 칸 하나에 수식을 적으면 딸린 칸이 저절로 다시 계산되는 짜임을 그렸다 — 오늘의 미니 시트와 같은 구조다. 표 안의 숫자는 짜임을 보이려고 지어낸 예시다.

옛 .xls 한 시트가 담는 줄담긴 줄65,536행여기서 잘린다넘친 줄 — 경고도 오류도 없이 사라진다2020년 10월 영국 · 약 16,000건도구에게 먼저 물을 것· 몇 줄까지 담나 (행 한도)· 숫자를 숫자로 읽나 (자료형)· 내 수식이 잡은 범위는 어디까지인가
현장

행 한도가 지운 확진자 — 2020년 영국

2020년 10월, 영국의 코로나19 일일 확진자 집계에서 약 1만 6천 건이 며칠 동안 통째로 빠졌습니다. 해킹도 정전도 아니었습니다. 검사 기관이 보낸 자료를 모으면서 옛 엑셀 형식(.xls)을 썼는데, 그 형식의 한 시트는 65,536행까지만 담을 수 있었기 때문입니다.

넘친 줄은 경고도 없이 잘려 나갔습니다. 오늘 우리가 본 것과 같은 일이지요 — 도구는 "당신의 자료가 넘쳤습니다"라고 말해 주지 않습니다. 빠진 확진자들과 접촉한 사람들에게 며칠 늦게 연락이 갔고, 그 사이에 전파가 이어졌습니다. 도구의 한계(행 수, 자료형, 수식 범위)를 모른 채 쓰면 데이터는 조용히 사라지거나 조용히 바뀝니다. 그래서 새 도구를 쓸 때 가장 먼저 물을 것은 "무엇을 잘하나"가 아니라 "어디서 말없이 멈추나"입니다.

도해: 시트의 행 한도에서 자료가 잘려 나가는 짜임을 그렸다. 숫자 65,536 은 옛 .xls 형식의 한 시트 최대 행 수다.

직접 짜는 정도 × 설치 부담직접 짜는 것이 많다 →설치·계정 부담 →BI 도구R표 계산(미니 시트)SQLpandas순수 파이썬교실에서는 여기가 벽가로줄 밑 = 브라우저에서 바로 돈다· 이 교과서: 순수 파이썬 · SQL · pandas · 미니 시트· 밖에 둔 것: R · BI — 설치나 계정이 필요하다· 지도는 고정이 아니다 — R 도 브라우저 판이 있다
도구의 지도

R 과 BI 는 어디에 있나 — 그리고 왜 교실에는 없나

R 은 1993년 뉴질랜드 오클랜드 대학교의 로스 이하카와 로버트 젠틀먼이 시작한 통계 전용 언어입니다. 이름의 R 은 두 사람 이름의 첫 글자에서 왔지요. 통계학자들이 만든 꾸러미가 넓어서 논문의 분석을 그대로 다시 돌려 보기에 좋습니다. BI 도구는 반대쪽 끝입니다 — 코드를 거의 쓰지 않고 자료를 끌어 놓아 그림과 판을 만들고, 자료가 바뀌면 판이 저절로 갱신됩니다.

두 도구를 오른쪽 지도의 두 축에 놓아 보면 자리가 보입니다. 가로축은 내가 직접 짜는 정도, 세로축은 설치·계정의 부담입니다. 교실이 도구를 고를 때 걸리는 것은 언제나 세로축이에요 — 설치가 필요하면 어떤 학생은 못 한다. 이 교과서의 파이썬·SQL·시트가 모두 브라우저 안에서 도는 까닭입니다. 다만 지도는 고정된 것이 아닙니다. 요즘은 R 을 브라우저에서 돌리는 판도 있고, 이 교과서의 파이썬도 불과 몇 해 전이라면 설치가 필요한 도구였습니다.

도해: 다섯 갈래를 '직접 짜는 정도(가로)'와 '설치·계정 부담(세로)' 두 축에 놓았다. 자리는 견주기 위한 것이고 눈금은 없다.