단원 홈

Ⅱ. 데이터 준비와 분석6차시

평균도 표준편차도
같은 네 학교

그려 보기 전에는 모른다

네 학교의 통학 시간은 평균 30분, 표준편차 10분으로 똑같습니다. 그렇다면 네 학교 학생들의 아침도 같을까요? 요약 숫자가 말해 주는 것과 말해 주지 않는 것을 그림으로 확인하고, 이 책의 두 번째 그림 도구 matplotlib을 처음 손에 쥡니다.

  • [12데과02-02]
  • 50분네 정거장
  • 새 도구matplotlib
  • 자료가상 네 학교 1,200명 · 다시 뽑기 20번 24,000명
Ⅱ 단원 지도6 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    평균·표준편차가 말하지 않는 것 — 봉우리 수 · 치우침 · 튀는 값 — 을 그림에서 찾아 말할 수 있다.

  2. 손으로

    matplotlib 으로 네 학교의 히스토그램과 상자그림을 같은 눈금 위에 나란히 그릴 수 있다.

  3. 확인에서

    구간을 바꿔 그려 본 뒤 보고할 구간과 그 까닭을 한 줄로 적을 수 있다.

1
여는 장면 · 5분

기사 한 줄 — "네 학교의 통학 여건은 비슷하다"

교육 소식 한 면에 이런 기사가 실렸다고 해 봅시다. 기자는 네 학교에서 학생 300명씩의 통학 시간을 받아 평균과 표준편차를 냈고, 네 줄의 숫자가 소수 첫째 자리까지 똑같이 나오자 결론을 적었습니다.

평균이 같으니 가운데가 같고, 표준편차가 같으니 퍼진 정도도 같다 — 여기까지는 숫자가 한 말입니다. 그런데 "통학 여건이 비슷하다"는 문장도 숫자가 한 말일까요?

교육 · 가상 기사

네 학교 학생들의 통학 시간은 평균 30분, 표준편차 10분으로 똑같다 — 통학 여건이 비슷하다

학생 300명씩 설문 · 이 기사는 수업을 위해 지어낸 것입니다
표 1기자가 본 요약표통학 시간(분) · 학생 300명씩
학교평균표준편차가장 짧게가장 길게모양
가 학교30.010.0655가려 둠
나 학교30.010.0850가려 둠
다 학교30.010.01772가려 둠
라 학교30.010.01296가려 둠

평균과 표준편차는 네 줄이 모두 같습니다. 다른 것은 가장 짧게 · 가장 길게 두 칸뿐 — 라 학교의 96분이 눈에 걸리지만, 한 사람의 값인지 여럿의 값인지는 표가 말해 주지 않습니다. 자료: 가상 네 학교 1,200명 — 3정거장 코드 ①이 만드는 값과 같다(집필 단계에서 실제로 돌려 확인한 값)

먼저 예측

그림은 아직 가려 둡니다. 네 학교의 아침 등굣길을 한 문장으로 적어 보세요 — "대부분 30분쯤 걸려 도착한다"처럼. 그리고 아래 빈 축 넷에 네 학교의 모양을 공책에 한 장씩 스케치해 둡니다. 3정거장 「손으로」 미션 ②에서 여러분의 예측과 실제 그림을 맞대어 봅니다.

가 학교
0분3060분평균
나 학교
0분3060분평균
다 학교
0분3060분평균
라 학교
0분3060분평균
체크포인트 1

네 학교의 등굣길을 한 문장으로 적고, 공책에 모양 넷을 스케치해 두었다 — 아직 그림은 보지 않았다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

요약 숫자가 말하는 것, 그림이 말하는 것

2-1요약 숫자는 두 가지만 말한다

평균은 자료의 가운데가 어디쯤인지를, 표준편차는 평균에서 얼마나 흩어져 있는지를 한 숫자로 줄인 것입니다. 줄였다는 것은 버렸다는 뜻이기도 합니다. 300명의 값을 숫자 두 개로 줄이는 동안 모양 — 봉우리가 몇 개인지, 한쪽으로 꼬리가 길게 늘어졌는지, 몇 사람만 멀리 떨어져 있는지 — 은 빠져나갑니다.

네 학교의 자료는 이 점을 보이려고 모양을 일부러 설계한 가상 자료입니다. 봉우리 하나 · 봉우리 둘 · 오른쪽 꼬리 · 튀는 값 몇 개로 서로 다르게 만든 뒤, 평균 30분 · 표준편차 10분이 되도록 옮겨 놓았어요. 요약표가 네 줄 모두 같은 까닭입니다.

2-2분포를 그리는 세 도구 — 각자 숨기는 것이 있다

같은 자료를 세 가지로 그려 봅니다. 아래 그림은 가 학교와 나 학교의 통학 시간 300개를 같은 가로축 위에 히스토그램 · 상자그림 · 점그림으로 겹쳐 놓은 것입니다. 세 줄을 위에서 아래로 읽으며 어느 줄에서 두 학교가 갈리고 어느 줄에서 같아지는지 찾아보세요.

그림 1같은 자료, 세 가지 그림 — 가 학교와 나 학교주황 띠 25~35분 · 점선 평균 30분
가 학교평균 30.0분 · 표준편차 10.0분25~35분 41%히스토그램 · 2분 구간상자그림점그림 · 한 사람 한 점봉우리 하나Q1 23중앙 30Q3 38상자: 나 학교와 거의 같다가운데가 가장 높다1020304050통학 시간(분)나 학교평균 30.0분 · 표준편차 10.0분25~35분 11%히스토그램 · 2분 구간상자그림점그림 · 한 사람 한 점봉우리 둘Q1 20중앙 30.5Q3 39상자: 가 학교와 거의 같다가운데가 비었다1020304050통학 시간(분) 가 학교평균 30.0 · 표준편차 10.025~35분 41%히스토그램 · 2분 구간상자그림점그림 · 한 사람 한 점봉우리 하나Q1 23중앙 30Q3 38상자: 나 학교와 거의 같다가운데가 가장 높다1020304050통학 시간(분)나 학교평균 30.0 · 표준편차 10.025~35분 11%히스토그램 · 2분 구간상자그림점그림 · 한 사람 한 점봉우리 둘Q1 20중앙 30.5Q3 39상자: 가 학교와 거의 같다가운데가 비었다1020304050통학 시간(분)

히스토그램과 점그림에서는 두 학교가 확연히 다른데, 상자그림 줄에서는 거의 같은 상자가 된다 (가: Q1 23 · 중앙 30 · Q3 38, 나: Q1 20 · 중앙 30.5 · Q3 39). 자료: 가상 네 학교(원장 계산, 코드 ①과 같은 씨앗)

표 2세 도구가 드러내는 것과 숨기는 것
도구무엇을 그리나드러내는 것숨기는 것
히스토그램 구간마다 몇 명인지봉우리 수 · 치우침 · 빈 자리구간을 어떻게 나누느냐에 따라 모양이 바뀐다
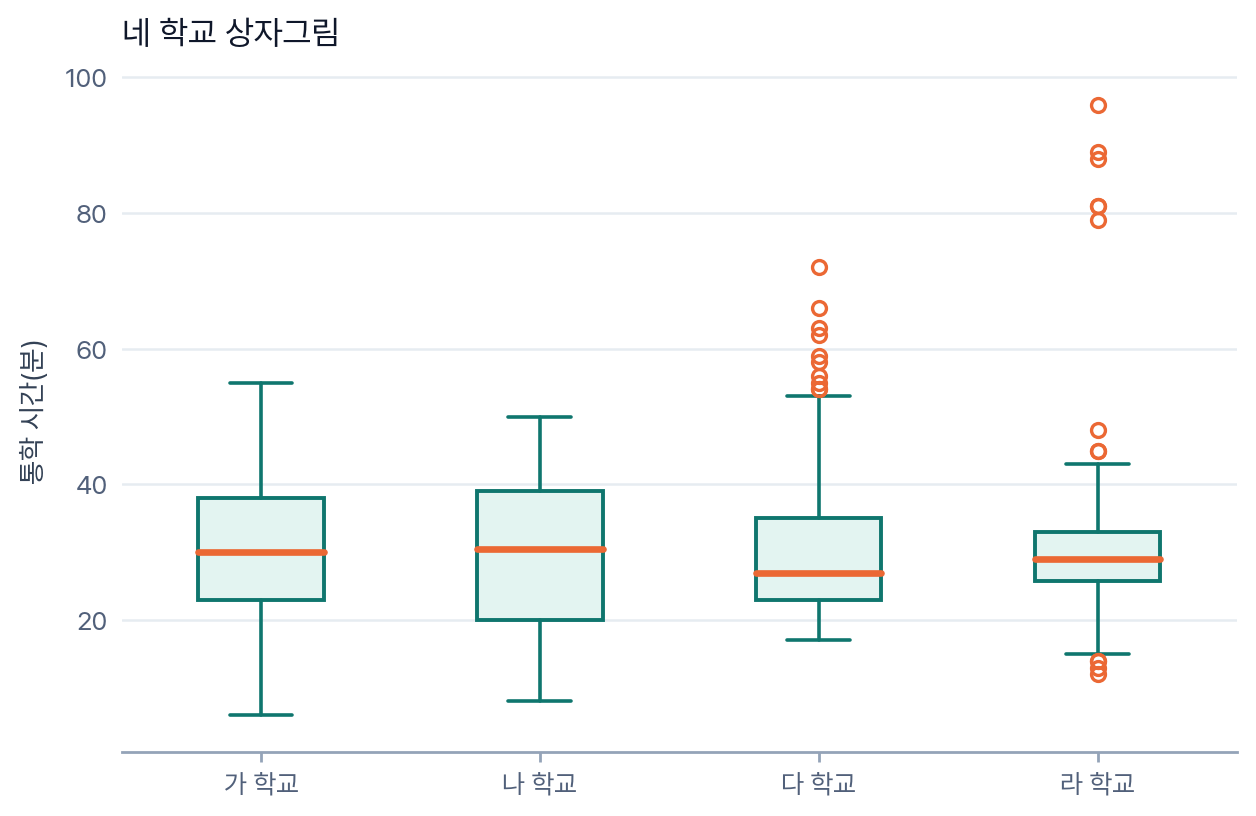
상자그림 Q1 · 중앙값 · Q3 · 수염 · 튀는 점여러 무리를 한 장에서 견주기 · 튀는 점봉우리 수 — 가·나 학교처럼 다른 모양도 같은 상자가 된다
점그림 한 사람에 점 하나값 하나하나 · 빈 자리 · 몇 명만 떨어진 모습값이 많으면 점이 겹쳐 쌓인 높이를 읽기 어렵다

Ⅱ-5 에서 가져옴상자그림의 수염은 5차시의 1.5 IQR 울타리입니다. Q1 − 1.5×IQR 과 Q3 + 1.5×IQR 안쪽의 끝값까지 수염을 긋고, 그 밖의 값은 점으로 따로 찍습니다.

2-3구간이 모양을 만든다

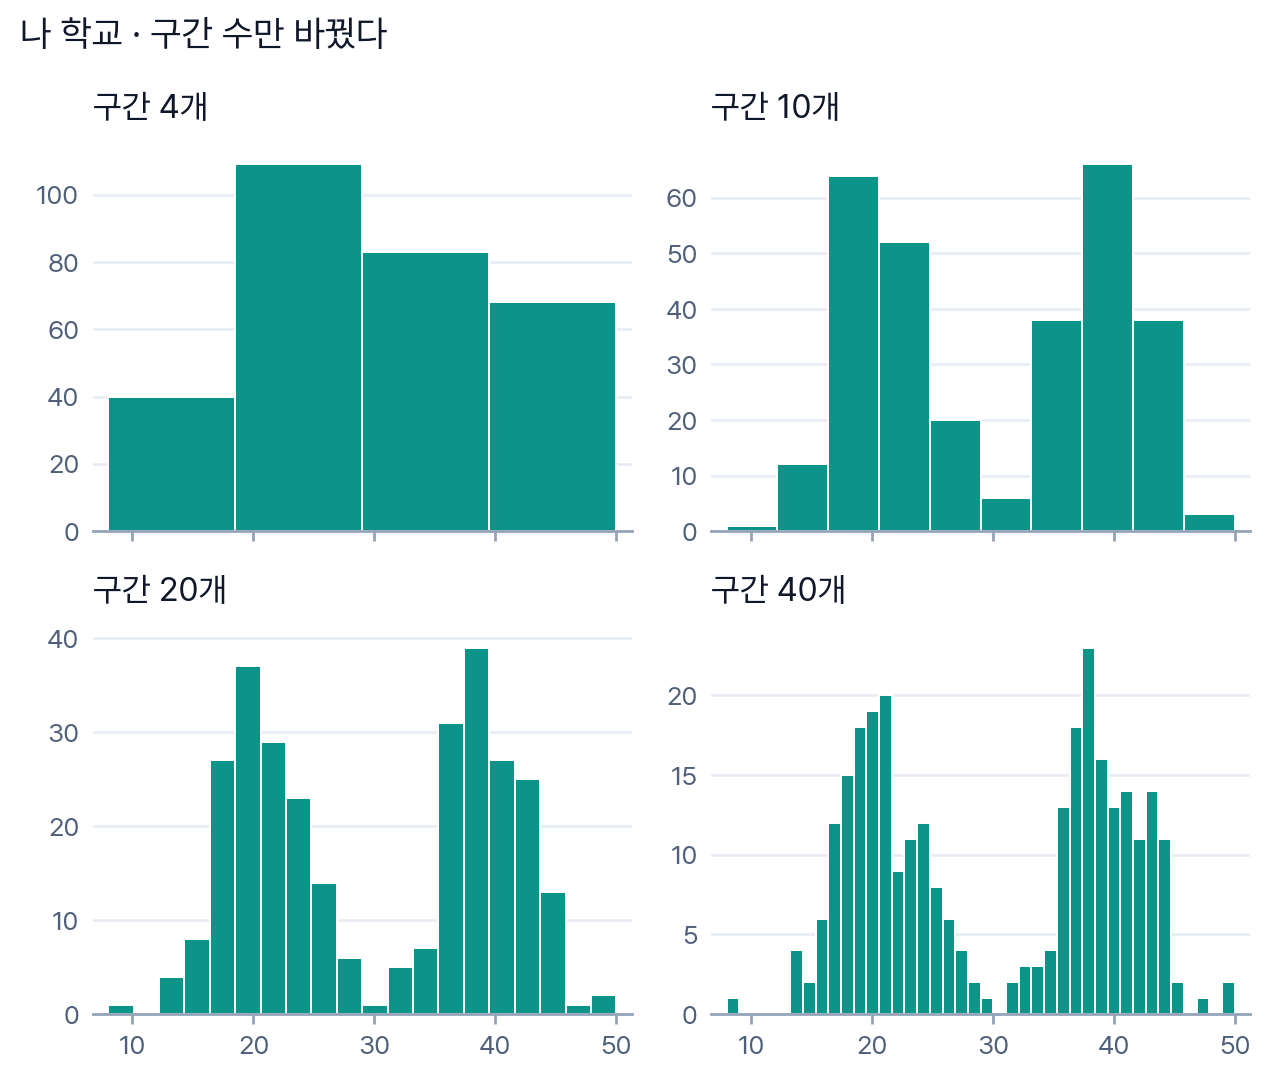
히스토그램은 그리는 사람이 구간을 정해야 그려집니다. 같은 나 학교도 구간을 4개로 나누면 봉우리가 하나로 보이고(막대 40 · 109 · 83 · 68명), 10개로 나누면 둘로 갈라집니다(1 · 12 · 64 · 52 · 20 · 6 · 38 · 66 · 38 · 3명). 40개로 나누면 막대가 들쭉날쭉해져, 우연히 몰린 몇 명이 작은 뾰족탑을 세웁니다.

구간이 너무 넓으면 모양을 뭉개고, 너무 좁으면 우연까지 모양처럼 보입니다. 구간 수가 같아도 구간이 시작하는 자리만 옮기면 막대 높이가 바뀝니다.

다만 "구간 4개면 봉우리 하나"는 이 300명에게만 맞는 말입니다. 그래서 한 가지를 더 합니다 — 다시 뽑기, 곧 같은 학교에서 같은 방식으로 300명을 새로 뽑는 일을 20번 되풀이해 히스토그램을 20장 나란히 두는 것입니다. 20장은 모두 같은 학교에서 나왔으니, 20장이 한목소리로 말하는 것만 모양이고 장마다 달라지는 것은 우연입니다.

나 학교를 구간 4개로 그려 봉우리가 하나로 보이는 것은 20번 가운데 2번뿐이에요 (3정거장 시뮬레이터가 그 20장을 한꺼번에 펼쳐 보입니다). 그래서 규칙을 하나 둡니다.

규칙구간을 여러 번 바꿔 그려 본 뒤, 고른 구간과 그 까닭을 그림 옆에 함께 적는다.

나 학교같은 300명
구간 4개 → 봉우리 1구간 10개 → 봉우리 2

자료: 가상 나 학교 300명 — 막대 높이는 코드 ④의 출력값

2-4숫자로 찾는 모양의 단서

그림이 없을 때도 모양을 의심할 단서가 숫자 안에 있습니다. 두 숫자를 나란히 놓으면 보입니다 — 같아야 할 두 숫자가 다르면, 그 차이가 곧 모양의 흔적입니다.

나 학교 · 평균 근처(25~35분)에 있는 학생
30.0평균(분)
인데
11%25~35분 학생

평균 자리가 비어 있다 — 봉우리 둘.

다 학교 · 중앙값과 평균
27.0중앙값(분)
vs
30.0평균(분)

중앙값 평균 — 오른쪽 꼬리가 평균을 끌어올린다.

라 학교 · 가장 긴 6명을 빼면
10.0표준편차(분)
→
6.06명 뺀 표준편차

표준편차가 6명에게 끌려 부풀었다 — 79 · 81 · 81 · 88 · 89 · 96분.

나 학교 · 구간 수만 바꾸면
1구간 4개 · 봉우리
vs
2구간 10개 · 봉우리

같은 자료도 구간이 모양을 바꾼다.

자료: 가상 네 학교 1,200명 — 위 네 쌍의 숫자는 모두 코드 ① · ③ · ④가 찍는 값이다.

그림을 읽는 나침반 — 네 방향을 차례로

  1. 중심가운데는 어디인가 — 평균과 중앙값이 같은 자리를 가리키나
  2. 퍼짐얼마나 넓게 흩어졌나 — 표준편차가 몇 사람에게 끌리지 않았나
  3. 모양봉우리는 몇 개, 꼬리는 어느 쪽 — 구간을 바꿔도 남는 모양인가
  4. 튀는 점멀리 떨어진 값이 있나 — 틀린 값인지 다른 이야기인지(Ⅱ-5)

그래서 '표준편차가 같다 = 퍼짐이 같다'도 틀릴 수 있습니다. 같은 10.0분이 '고르게 퍼짐'(가 학교)과 '대부분 좁게 + 몇 명이 아주 멀리'(라 학교)를 가리지 못합니다.

체크포인트 2

요약 숫자가 숨긴 넷(봉우리 · 치우침 · 튀는 값 · 구간)을 말할 수 있다. 이제 직접 그려서 확인한다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

matplotlib 으로 네 학교를 한 장에 그린다

오늘의 장비

matplotlib — 데이터 과학자가 실제로 쓰는 그림 도구

Ⅰ 단원의 chart 는 한 줄에 그림 하나를 정해진 모양으로 그렸습니다. 오늘부터 Ⅱ 단원의 그림은 matplotlib 으로 그립니다. 처음 실행은 몇 초 멈춥니다 — 고장이 아니라 matplotlib 과 한글 글꼴을 처음 받는 중이에요(쪽마다 한 번).

부르는 모양

import matplotlib.pyplot as plt

fig, axes = plt.subplots(2, 2)
axes[0][0].hist(값, bins=10)
plt.show()   # 출력 칸에 그림이 들어간다

오늘 쓰는 함수 넷

hist
히스토그램 — bins 로 구간 수 또는 경계
boxplot
상자그림 — 목록 여럿을 한 장에
subplots
한 장을 여러 칸으로 — sharex·sharey
xticks
가로 눈금 자리에 이름을 단다

chart 와 다른 셋

  1. 한 장에 여러 칸plt.subplots(2, 2) — 네 학교를 한 장에
  2. 축을 내가 정한다네 칸이 같은 눈금을 쓰게, 구간 경계도 bins 로
  3. 칸마다 글자제목·눈금 이름을 칸마다 단다

대가 — 줄이 길어지고, 축을 내가 정할 수 있다는 것은 축으로 속일 수도 있다는 뜻입니다(7차시).

1

요약표를 찍고, 그림을 보기 전에 한 줄 적는다

2분

코드 ①은 네 학교 자료를 만들고 요약표를 찍습니다. 여는 장면의 표와 같은 숫자가 나올까요? school() 이 하는 일을 먼저 읽어 두세요 — 모양을 만든 뒤 평균 30 · 표준편차 10 으로 옮깁니다.

기본 코드 ①은 채워져 있습니다. 그대로 ▶ 실행해 네 줄의 요약 숫자를 확인하세요.

도전 school() 안의 10 을 5 로 바꾸면 네 줄이 모두 30.0 · 5.0 이 됩니다 — 모양은 그대로 두고 숫자만 옮기는 식이에요(Ⅱ-8 의 z 점수가 이 식에 이름을 붙입니다).

탐구 '평균 30분 · 표준편차 10분'인 학교를 여러분이 하나 더 설계한다면 어떤 모양으로 만들겠습니까? 그런 모양이 생길 통학 사정과 함께 생각해 보세요.

이 요약표만 받은 교육청이 "네 학교의 통학 사정이 같다"고 적어도 . 표가 말한 것은 뿐이고, 말하지 않은 것은 이기 때문이다.

확인 문제 6에 그림을 보기 전 한 줄을 적어 두기 →

미션 ②에서 그림을 본 뒤 그 한 줄을 고쳐 씁니다 — 고친 자리가 오늘 배운 것입니다.
2

matplotlib 첫 그림 — 네 학교 히스토그램을 한 장에

5분

여는 장면에 적어 둔 내 예측입니다. 이 문장이 네 학교 모두에게 맞을까요?

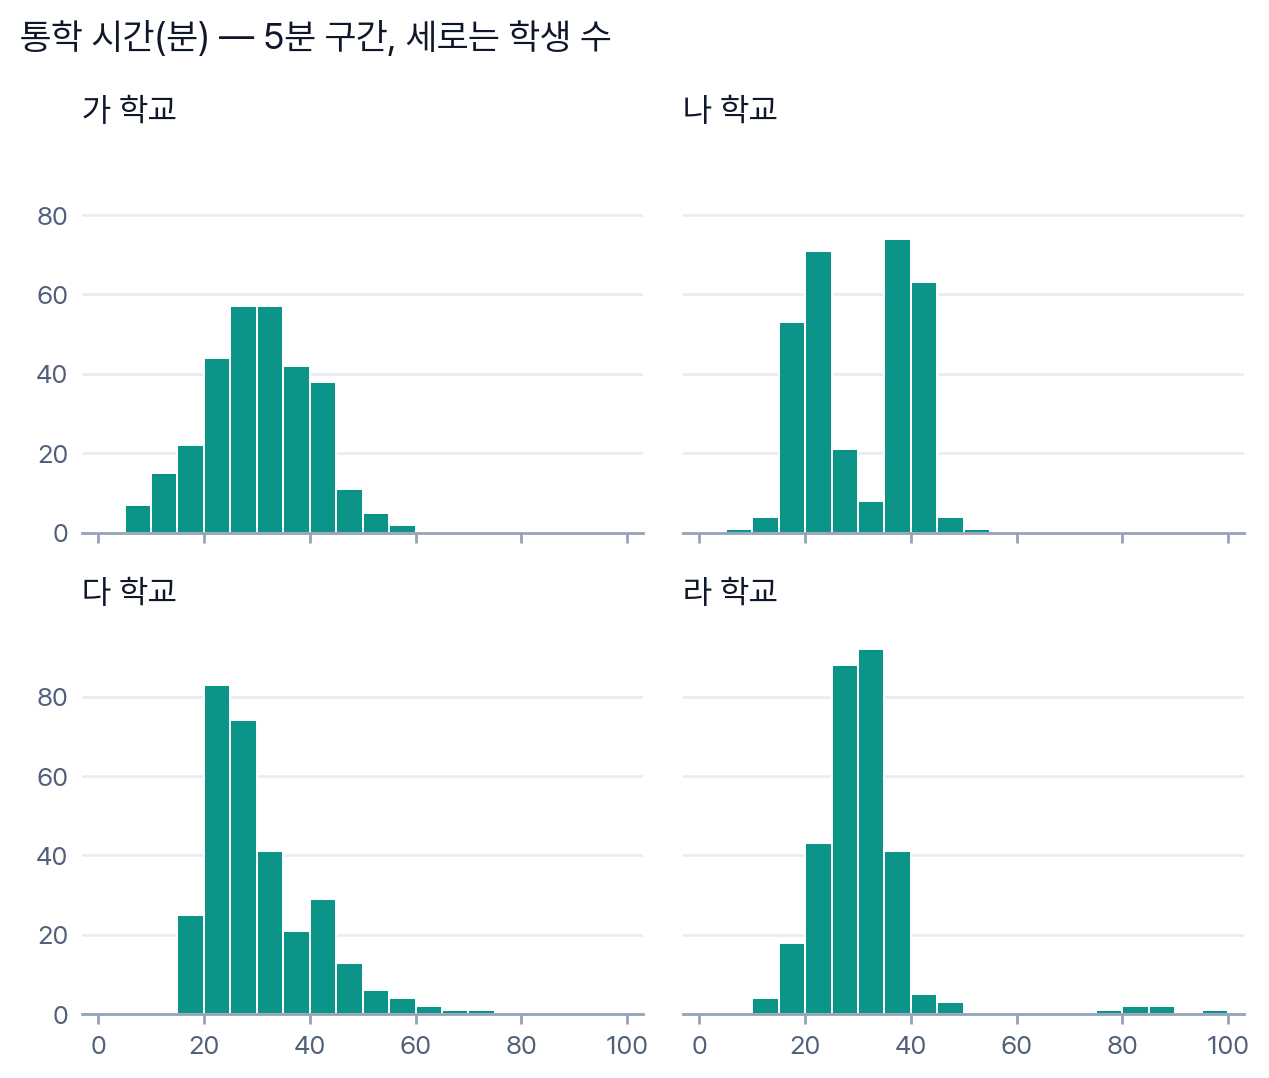
기본 빈칸 ①에 칸(ax)마다 히스토그램을 그리는 함수 이름을 채우고 ▶ 실행합니다. 네 학교 1,200명은 코드 ①이 만든 값과 같은 값을 담은 파일(four_schools.csv)에서 읽어, 칸마다 따로 돌아갑니다. 네 칸이 bins=range(0, 101, 5) 로 같은 5분 경계를 쓰는 것에 눈여겨보세요.

도전 bins=range(0, 101, 5) 를 bins=10 으로 바꿔 보세요. 같은 '10개'인데 막대 폭이 학교마다 4.2 ~ 8.4분으로 달라집니다(가 4.9 · 나 4.2 · 다 5.5 · 라 8.4분). 같은 구간 수가 같은 그림은 아닙니다.

탐구 다 학교의 오른쪽 꼬리와 라 학교의 튀는 값을 히스토그램만 보고 가를 수 있나요? 가를 수 없다면 무엇이 더 필요한지 적어 보세요(미션 ③이 그 도구를 꺼냅니다).

sharey=True 를 지우면 학교의 낮은 봉우리가 학교의 높은 봉우리와 보인다. 그래서 모양을 견줄 때는 .

확인 문제 5에 적어 제출 →
3

상자그림 — 네 상자를 한 장에 나란히

3분

가 학교(봉우리 하나)와 나 학교(봉우리 둘)의 상자는 얼마나 다를까요? 그림 1을 떠올리며 먼저 짐작해 두세요.

기본 빈칸 ②에 상자그림 함수를 채워 네 상자를 그리고, 그림 아래 세 줄의 숫자로 그림에서 본 것을 확인합니다.

도전 plt.boxplot(…) 에 whis=3 을 더해 보세요. 울타리가 1.5 IQR 에서 3 IQR 로 넓어져 라 학교의 주황 빈 점이 13 → 6개(멀리 온 여섯만), 다 학교는 10 → 1개가 됩니다. 울타리의 배수도 그림을 바꿉니다(Ⅱ-5).

탐구 '그림 × 드러낸 것 / 숨긴 것' 여덟 칸(히스토그램 · 상자그림 × 네 학교)을 채우고, 두 그림을 함께 보여 줘야 하는 학교를 하나 고르세요. 확인 문제 2의 표가 그 자리입니다.

상자그림만 보면 가 학교와 나 학교는 보인다. 상자그림은 를 숨기므로, 그것을 보려면 을 함께 그린다.

확인 문제 2의 표에 학교마다 적어 제출 →
4

구간 실험 — 네 장을 보고, 다시 뽑기 20번에 물어본다

7분

나 학교를 구간 4 · 10 · 20 · 40개로 그리면 봉우리는 각각 몇 개로 보일까요? 네 칸을 보기 전에 숫자 넷을 짐작해 두세요.

기본 코드 ④는 채워져 있습니다. 그대로 ▶ 실행해 네 장을 견주고, 출력의 막대 높이(구간 4개 · 10개)를 시뮬레이터의 숫자와 맞대어 보세요.

도전 (4, 10, 20, 40) 을 (5, 7, 9, 11) 로 바꿔, 봉우리가 하나에서 둘로 넘어가는 자리를 찾아보세요(아래 실험실의 도전 1과 같은 물음입니다).

탐구 구간 수를 여러분이 정한다면 학생 수(300명) · 값의 폭(가장 짧게~가장 길게) · 묻는 물음 셋 가운데 무엇을 먼저 보겠습니까? 고른 기준으로 나 학교의 구간 수를 하나 정해, 네 장 가운데 어느 것과 가까운지 보세요.

네 장 사이와 그 너머는 실험실에서 확인합니다 — 봉우리에 깃발을 꽂고, 판결을 잠그고, 다시 뽑기 20번에 물어봅니다. 2-3 에서 말한 그대로, 같은 학교에서 같은 방식으로 300명을 새로 뽑은 것이 한 벌이고 서랍에 20벌이 들어 있습니다. 도전 셋을 풀면 카드가 스스로 닫힙니다.

시뮬레이터

봉우리 깃발

이 봉우리는 진짜인가 — 다시 뽑기 20번이 증언하고, 다이얼 반 바퀴가 뒤집는다

  1. 1막대를 톡 쳐 봉우리에 깃발을 꽂는다
  2. 2판결 카드를 하나 골라 예측을 잠근다
  3. 3서랍(다시 뽑은 20벌)을 열고 다이얼을 돌려 증거를 본다
자료
구간 폭 (분)
시작점 다이얼
한 바퀴 = 폭 하나 0분부터
내 판결 — 고르면 예측이 잠긴다
0판 · 네 학교 한눈에같은 두 숫자, 네 모양

봉우리 = 양쪽 골짜기보다 가장 높은 막대의 15% 이상 솟은 막대 · 깃발 자리 = 다시 뽑은 20벌 가운데 같은 구간의 막대가 봉우리를 이룬 것이 16벌 이상이면 자리까지 굳은 깃발

판결 — 20벌의 봉우리 수가 제각각이면 뽑기의 우연, 한목소리인데 다이얼 한 바퀴 안에서 그 수가 바뀌면 구간의 착시, 둘 다 통과하면 진짜 무리

이번 뽑기 봉우리—개
평균30.0
표준편차10.0
꽂은 깃발0
같은 구간 증언—
점수0
도전 1

가 학교 · 폭 2분의 또렷한 봉우리 셋에 깃발을 꽂고 판결을 붙인 뒤 서랍을 열어라 — 같은 구간에 봉우리가 선 것은 20벌 가운데 몇 벌인가?

도전 2

나 학교 · 폭 10분에서 20벌이 모두 '봉우리 하나'라고 증언한다. 다이얼을 돌려 20장이 한꺼번에 둘로 뒤집히는 자리를 찾아라.

도전 3

네 학교 모두 정직한 폭 — 다이얼을 한 바퀴 돌려도, 20벌을 다 봐도 봉우리 수가 한 가지인 폭을 찾아라.

자료: 가상 네 학교 × 다시 뽑기 20번(난수 씨앗 2026~2045) 24,000명 — 1분 칸 인원 80벡터를 쪽 안에 실었다. 첫 뽑기(씨앗 2026)는 코드 ② ~ ④가 읽는 ../data/four_schools.csv 와 같은 값이다. 사건 ④의 실측: ../data/seoul_tmax_2018_2025.csv — 서울(108) 2018-01-01 ~ 2025-12-31 2,922일의 하루 최고기온, 기상청 종관기상관측(ASOS) 일자료. 기상청 제공(2026-09-23 내려받음). 0.1°C 칸 인원 여덟 해 벡터를 쪽 안에 실었다.

나 학교의 '진짜' 모양을 말하려면 구간 처럼 한 장의 그림이 아니라, 와 두 증거를 모두 통과한 모양을 믿는다.

확인 문제 4에 적어 제출 →
5

내 자료로 — 서울 하루 최고기온, 구간을 내가 고른다

3분

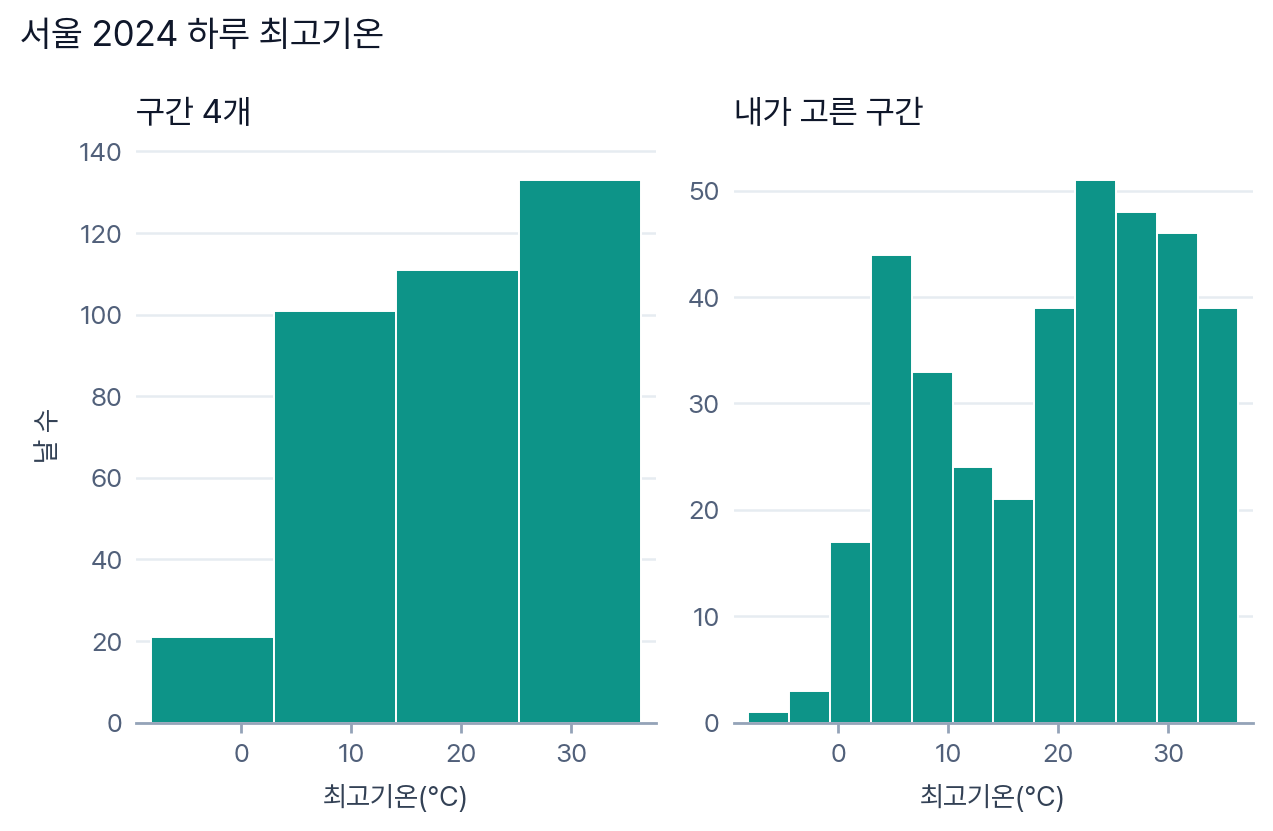
가상 학교를 떠나 진짜 자료로 갑니다. 기상청이 잰 서울 2024년 366일의 하루 최고기온입니다. 계절을 떠올려 보세요 — 이 366일을 히스토그램으로 그리면 봉우리가 몇 개로 보일까요?

기본 빈칸 ③에 내가 고른 구간을 채우고 ▶ 실행합니다. 수를 적으면 그만큼 등분하고(예: 12), range(시작, 끝, 폭) 을 적으면 경계를 직접 정합니다. 왼쪽 칸의 구간 4개는 고정이니, 두 장을 나란히 견주세요.

도전 MY_BINS 를 range(-10, 41, 3) 과 range(-9, 42, 3) 으로 바꿔 보세요. 폭도 자료도 그대로인데 시작점만 1도 옮기면 봉우리가 둘에서 셋이 됩니다 — 위 실험실의 다이얼이 한 그 일입니다.

탐구 최고기온 대신 평균기온이나 최저기온으로 그리면 봉우리 자리는 어디로 움직일까요? 읽는 열 이름만 바꾸면 됩니다("평균기온(°C)" · "최저기온(°C)").

이 366일을 보고서에 실을 때 나는 구간 을 고르겠다. 까닭은 이고, 그림 옆에 를 함께 적는다. 진짜 자료에는 정답 구간이 없다 — 고른 손을 밝히는 것이 정답 대신이다.

확인 문제 4의 ④에 적어 제출 →
체크포인트 3

그림 넉 장을 직접 그렸고, 봉우리 하나하나를 두 증거(다시 뽑기 · 시작점)로 갈랐고, 가상이 아닌 진짜 자료에서도 같은 일이 일어나는 것을 보았고, 보고할 구간을 골랐다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

  1. 찾은 것

    평균·표준편차가 같아도 모양은 넷이 다 달랐다 — 봉우리 하나 · 둘 · 오른쪽 꼬리 · 튀는 값.

  2. 도구의 한계

    상자그림은 봉우리 수를, 히스토그램은 구간을 고른 손을 숨긴다. 두 그림을 함께 본다.

  3. 보고의 규칙

    봉우리는 두 증거로 가린다 — 다시 뽑아도 서는가(우연), 시작점을 돌려도 서는가(착시).

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. 나 학교에서 통학 시간이 25~35분인 학생은 몇 %인가? 이 숫자가 "나 학교 학생들은 평균 30분 걸린다"는 말에 대해 알려 주는 것을 쓰시오.
📖 모범 답안

11%(300명 가운데 33명)이다.

나 학교는 봉우리가 20분 근처와 38분 근처에 둘 있어서, 평균 30분 자리가 오히려 비어 있다. "평균 30분 걸린다"는 말은 틀리지 않지만, 그 말을 듣고 "대부분 30분쯤 걸린다"고 읽으면 틀린다. 평균은 아무도 대표하지 못할 수 있다 — 그래서 평균을 보고할 때는 히스토그램이나 점그림으로 모양을 함께 보인다.

2. 미션 ③의 상자그림과 미션 ②의 히스토그램을 맞대어 아래 표를 채우시오. 그리고 상자그림만 보고 "가 학교와 나 학교는 통학 사정이 비슷하다"고 하면 무엇을 놓치는지, 그것을 보려면 무엇을 그려야 하는지 쓰시오.
학교히스토그램이 드러낸 것상자그림이 숨긴 것
가 학교
나 학교
다 학교
라 학교
📖 모범 답안

표 — 가: 봉우리 하나, 가운데가 가장 두껍다 / 상자는 모양을 거의 그대로 보인다. 나: 봉우리 둘(20분 · 38분 근처), 가운데가 빈다 / 봉우리 둘이 숨는다 — 상자가 가 학교와 거의 같다. 다: 오른쪽으로 긴 꼬리 / 꼬리의 길이는 수염과 빈 점으로 보이지만 막대의 몰림은 숨는다. 라: 대부분 좁게 몰리고 6명이 아주 멀리 / 6명은 빈 점으로 드러나지만, 나머지가 얼마나 좁게 모였는지는 상자만으로 덜 보인다.

상자그림은 Q1 · 중앙값 · Q3 · 수염만 그리므로 봉우리 수를 숨긴다. 가(Q1 23 · 중앙 30 · Q3 38)와 나(Q1 20 · 중앙 30.5 · Q3 39)는 상자가 거의 같지만, 나 학교에는 걸어오는 무리와 버스 타는 무리처럼 다른 두 집단이 있다. 그래서 히스토그램이나 점그림을 함께 그린다.

3. 다 학교의 중앙값(27.0분)이 평균(30.0분)보다 작은 까닭을 쓰시오. 그리고 라 학교에서 가장 긴 6명을 빼면 표준편차가 10.0분에서 6.0분이 되는 것이 "네 학교의 퍼짐이 같다"는 문장에 대해 말해 주는 것을 쓰시오.
📖 모범 답안

다 학교는 오른쪽으로 긴 꼬리가 있다. 멀리 사는 소수의 긴 통학 시간이 평균을 끌어올리지만, 가운데 사람의 값인 중앙값은 덜 움직인다. 그래서 치우친 자료를 보고할 때는 중앙값을 함께 쓴다.

표준편차는 튀는 값 몇 개에 크게 끌린다. 라 학교는 294명이 좁게 모여 있는데 6명(79 · 81 · 81 · 88 · 89 · 96분)이 표준편차를 10.0분으로 부풀렸다. 그래서 같은 10.0분이 '고르게 퍼짐'(가 학교)과 '대부분 좁게 + 몇 명이 아주 멀리'(라 학교)를 가리지 못한다 — "퍼짐이 같다"는 숫자만의 말이다.

4. 나 학교를 구간 4개로 그리면 봉우리가 하나로, 10개로 그리면 둘로 보인다. ① 둘 가운데 어느 쪽이 '진짜' 모양인지 답하고, ② 보고서에 무엇을 함께 적어야 하는지 쓰시오. ③ 그리고 실험실에서 찾은 네 학교가 모두 정직한 폭과 그렇게 판단한 까닭을 한 줄 덧붙이시오. ④ 끝으로 미션 ⑤의 서울 2024년 하루 최고기온 366일을 보고서에 실을 때 어느 구간을 고르겠는지, 그 구간과 함께 무엇을 적어야 하는지 쓰시오.
📖 모범 답안

① 둘 다 같은 자료의 요약이라 어느 한쪽만 '진짜'라고 할 수 없다. 다만 구간 4개는 넓어서 두 봉우리를 뭉갠다 — 게다가 '구간 4개면 봉우리 하나'는 이 300명에게만 맞는 말이라, 같은 방식으로 300명을 20번 다시 뽑으면 20벌 가운데 2벌에서만 하나로 보인다. 폭 3~8분에서는 다이얼을 어디에 두어도 20벌이 모두 봉우리 둘이라고 말한다 — 그 모양을 믿는다.

② 그림과 함께 고른 구간(폭 또는 개수)과 그 까닭을 적는다. 예: "폭 6분 — 4개로는 두 봉우리가 뭉개지고, 폭 3~8분에서는 시작점을 어디에 두어도 둘이라 가장 읽기 쉬운 6분을 골랐다."

③ 폭 6 · 7 · 8분. 이 폭에서는 다이얼을 한 바퀴 돌려도, 20벌을 다 펼쳐도 네 학교의 봉우리 수가 한 가지다(가 1 · 나 2 · 다 1 · 라 1). 코드 ②가 쓴 5분은 나 학교에는 정직하지만 가 · 다 학교에서는 시작점에 따라 우연 봉우리가 생길 수 있는 폭이다.

④ 예: "구간 12개(최솟값~최댓값 열두 등분) — 구간 4개로는 겨울과 여름 두 무리가 한 덩어리로 뭉개지고, 12개로 나누면 겨울 쪽 3~7°C 와 여름 쪽 21~25°C 의 두 봉우리, 그 사이 14~18°C 의 골짜기가 드러나 봄·가을이 짧다는 것까지 읽힌다." 그림 옆에는 고른 구간과 그 까닭을, 그리고 이 구간이 흔들리지 않는지를 함께 적는다 — 실험실에서 본 대로 여덟 해(2018~2025) 가운데 일곱 해가 12등분에서 봉우리 둘이고(2018만 하나), 4등분에서는 여덟 해 모두 하나다. 그러니 '두 봉우리'는 2024년만의 이야기가 아니고, '한 봉우리'는 구간이 넓어서 생긴 그림이다. 다만 시작점은 흔들린다 — 폭 3°C 를 −10.0°C 에서 시작하면 봉우리 둘, 1.0°C만 옮겨 −9.0°C 에서 시작하면 셋이다. 그래서 폭만이 아니라 시작점까지 적어야 남이 같은 그림을 다시 그릴 수 있다.

5. 네 학교 히스토그램을 plt.subplots(2, 2) 로 그릴 때 sharey=True 를 빼면 무엇이 잘못 보일 수 있는지 쓰고, 모양을 견줄 때 눈금과 구간을 어떻게 다뤄야 하는지 쓰시오.
📖 모범 답안

칸마다 세로 눈금이 제 최댓값에 맞춰진다. 5분 구간에서 가장 높은 막대는 가 학교 57명, 라 학교 92명인데, sharey 를 빼면 이 둘이 같은 높이로 보인다. 모양을 견줄 때는 눈금을 함께 쓰고(sharex · sharey), 눈금을 따로 쓸 수밖에 없을 때는 그림 아래에 그 사실을 적는다.

하나 더 — 눈금만으로는 모자란다. bins=10 은 학교마다 제 최솟값~최댓값을 10등분하므로 막대 폭도 학교마다 다르다 (가 4.9 · 나 4.2 · 다 5.5 · 라 8.4분). 높이를 공정하게 견주려면 bins=range(0, 101, 5) 처럼 구간 경계를 함께 써야 한다.

6. 미션 ①에서 요약표만 보고 적어 둔 한 줄을 먼저 그대로 옮겨 적고, 그림을 본 뒤 고쳐 쓴 한 줄을 그 아래에 적으시오. 그리고 무엇이 그 한 줄을 바꾸게 했는지 쓰시오.
📖 모범 답안

처음(예) "네 학교는 평균 30.0분 · 표준편차 10.0분으로 같으니 통학 사정도 비슷하다."

고쳐 쓰면(예) "네 학교의 중심과 퍼짐은 평균 30.0분 · 표준편차 10.0분으로 같다. 그러나 모양은 넷이 모두 다르다 — 가는 봉우리 하나, 나는 봉우리 둘(25~35분 학생이 11%뿐), 다는 오른쪽 꼬리(중앙값 27.0분), 라는 대부분 좁게 몰리고 6명이 79~96분이다. 통학 사정은 같지 않다."

바꾸게 한 것 — 숫자가 아니라 그림이다. 요약 숫자 둘은 중심과 퍼짐만 말하고 모양은 말하지 않는다. 보고서에 평균·표준편차를 쓸 때 분포 그림을 함께 싣는 까닭이 여기에 있다.

+
더 알아보기

탐험 밖의 이야기 셋

각 치수의 가운데 30% 띠띠 안?치수 1✓치수 2✓치수 3✕치수 4✓치수 5✕치수 6✓치수 7✓치수 8✕치수 9✓치수 10✕10가지 모두 띠 안에 든 조종사4,063명 중 0명
역사

평균적인 조종사는 없다

1950년대 초 미 공군 연구원 길버트 대니얼스는 조종사 4,063명의 신체 치수 10가지를 견주어 보았습니다. 치수마다 '평균 범위'를 가운데 30%로 넉넉하게 잡고, 10가지가 모두 그 범위에 드는 사람을 셌지요.

답은 한 명도 없다였습니다(1952년 보고서 「The "Average Man"?」). 평균 한 사람에게 맞춘 조종석은 누구에게도 꼭 맞지 않았고, 이 결과는 좌석과 페달을 조절식으로 바꾸는 계기가 됩니다. 오늘 나 학교의 평균 30분 자리가 비어 있던 것과 같은 이야기입니다 — 평균은 계산할 수 있지만, 그 자리에 사람이 있다는 보장은 없습니다.

도해: 치수마다 가운데 30% 띠를 칠하고 한 조종사가 띠 안에 드는지 표시했다. 점의 자리는 모양을 보인 예시이고, 4,063명 중 0명은 보고서의 값이다. · 출처: G. S. Daniels, The "Average Man"?, Wright Air Development Center, 1952

스터지스 규칙구간 10개 · 폭 4.20분프리드먼–디아코니스 규칙구간 8개 · 폭 5.25분밀도 곡선(커널 밀도 추정)구간 없음 · 언덕 폭 3.4분1020304050
방법 더 깊이

구간 수를 정하는 규칙들, 그리고 구간 없이 그리기

스터지스 규칙(1926)은 구간 수를 1 + log₂n 으로 잡습니다. 300명이면 약 9.2 — numpy 는 올려서 구간 10개를 씁니다. 프리드먼–디아코니스 규칙(1981)은 폭을 2 × IQR × n−1/3 으로 잡아, 나 학교(IQR 19분)는 폭 약 5.7분 — 범위 42분을 나누면 7.4라서 구간 8개가 됩니다. matplotlib 에서는 plt.hist(값, bins="sturges") · bins="fd" 처럼 규칙 이름으로 부를 수 있어요.

규칙이 내놓는 값도 출발점일 뿐입니다. 구간 경계를 아예 없애려면 값마다 작은 언덕을 쌓아 매끈한 곡선을 그립니다 — 커널 밀도 추정입니다. 이번엔 언덕의 폭을 골라야 하니 문제가 사라진 것은 아니지요. 이 곡선을 상자그림 양옆에 붙인 그림이 바이올린 그림(1998)입니다. 상자가 숨기던 봉우리가 옆구리에 드러납니다.

도해: 나 학교 300명을 두 규칙의 구간과 밀도 곡선으로 그렸다(언덕 폭은 실버먼 어림 규칙). 구간 수·폭은 numpy 로 계산한 값이다.

① 원자료 — 사람마다 한 값 (나 학교 300명)가로: 통학 시간(분)0102030405060② 공개본 — 10분 구간별 인원만10~95710~199220~298230~396740~49150~59이 안은 다시 나눌 수 없다③ ②만 받은 사람은 ①로 돌아갈 수 없다20~29분 칸의 92명이 21분에 몰렸는지 29분에 몰렸는지 알 길이 없다.그래서 공개 통계는 숫자보다 구간 경계를 먼저 확인한다.
현장

이미 구간으로 묶여 오는 통계

오늘 우리는 사람마다의 값 300개를 손에 쥐고 구간을 골랐습니다. 그런데 세상에 공개되는 통계에는 통근·통학 소요 시간처럼 처음부터 구간별 인원으로만 나오는 것이 많습니다. 개인을 알아볼 수 없게 하려고, 또 표를 작게 만들려고 만드는 쪽이 이미 한 번 묶은 것이지요.

묶는 순간 구간 안의 모양은 사라집니다. 그림 ②의 10~19분 칸에 57명이 있다는 것만 알 뿐, 그 57명이 11분에 몰렸는지 19분에 몰렸는지는 받는 쪽에서 되돌릴 수 없어요. 구간을 더 좁게 나눌 수도, 시작점을 옮겨 볼 수도 없습니다 — 오늘 우리가 다이얼로 했던 검사를 아예 할 수 없다는 뜻입니다. 그래서 공개 통계를 읽을 때는 숫자보다 구간 경계를 먼저 확인하고, 경계가 바뀐 해의 자료는 앞뒤 해와 곧바로 견주지 않습니다.

도해: 나 학교 300명을 ① 사람마다 한 점 ② 10분 구간별 인원(1 · 57 · 92 · 82 · 67 · 1명)으로 나란히 그렸다 — ②만 받은 사람은 ①로 돌아갈 수 없다. 막대 숫자는 원장 실측값이다.