💻
손으로 — 채점표를 직접 짜고 기준점을 훑는다
이제 여러분이 채점표를 짭니다. 오늘 짤 것은 함수 두 개입니다.
confusion(pairs) — (실제, 예측) 짝의 목록을 받아
(TP, FP, FN, TN) 네 수를 돌려준다. 이 함수는 이미 채워져 있습니다.
인자 순서와 돌려주는 순서를 눈으로 확인해 두세요.scores(TP, FP, FN, TN) — 네 칸을 받아
정확도·정밀도·재현율·F1을 돌려준다. 여기 빈칸 세 곳이 있습니다.
⚠️ 빈칸은 여섯 곳입니다
채우지 않고 실행하면 SyntaxError가 납니다 — 정상입니다.
?????를 전부 지우고 채우세요.
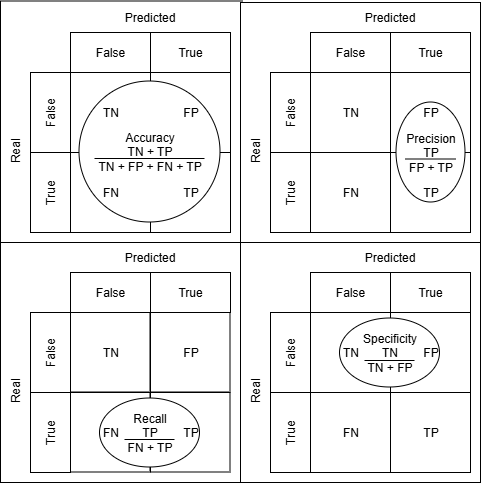
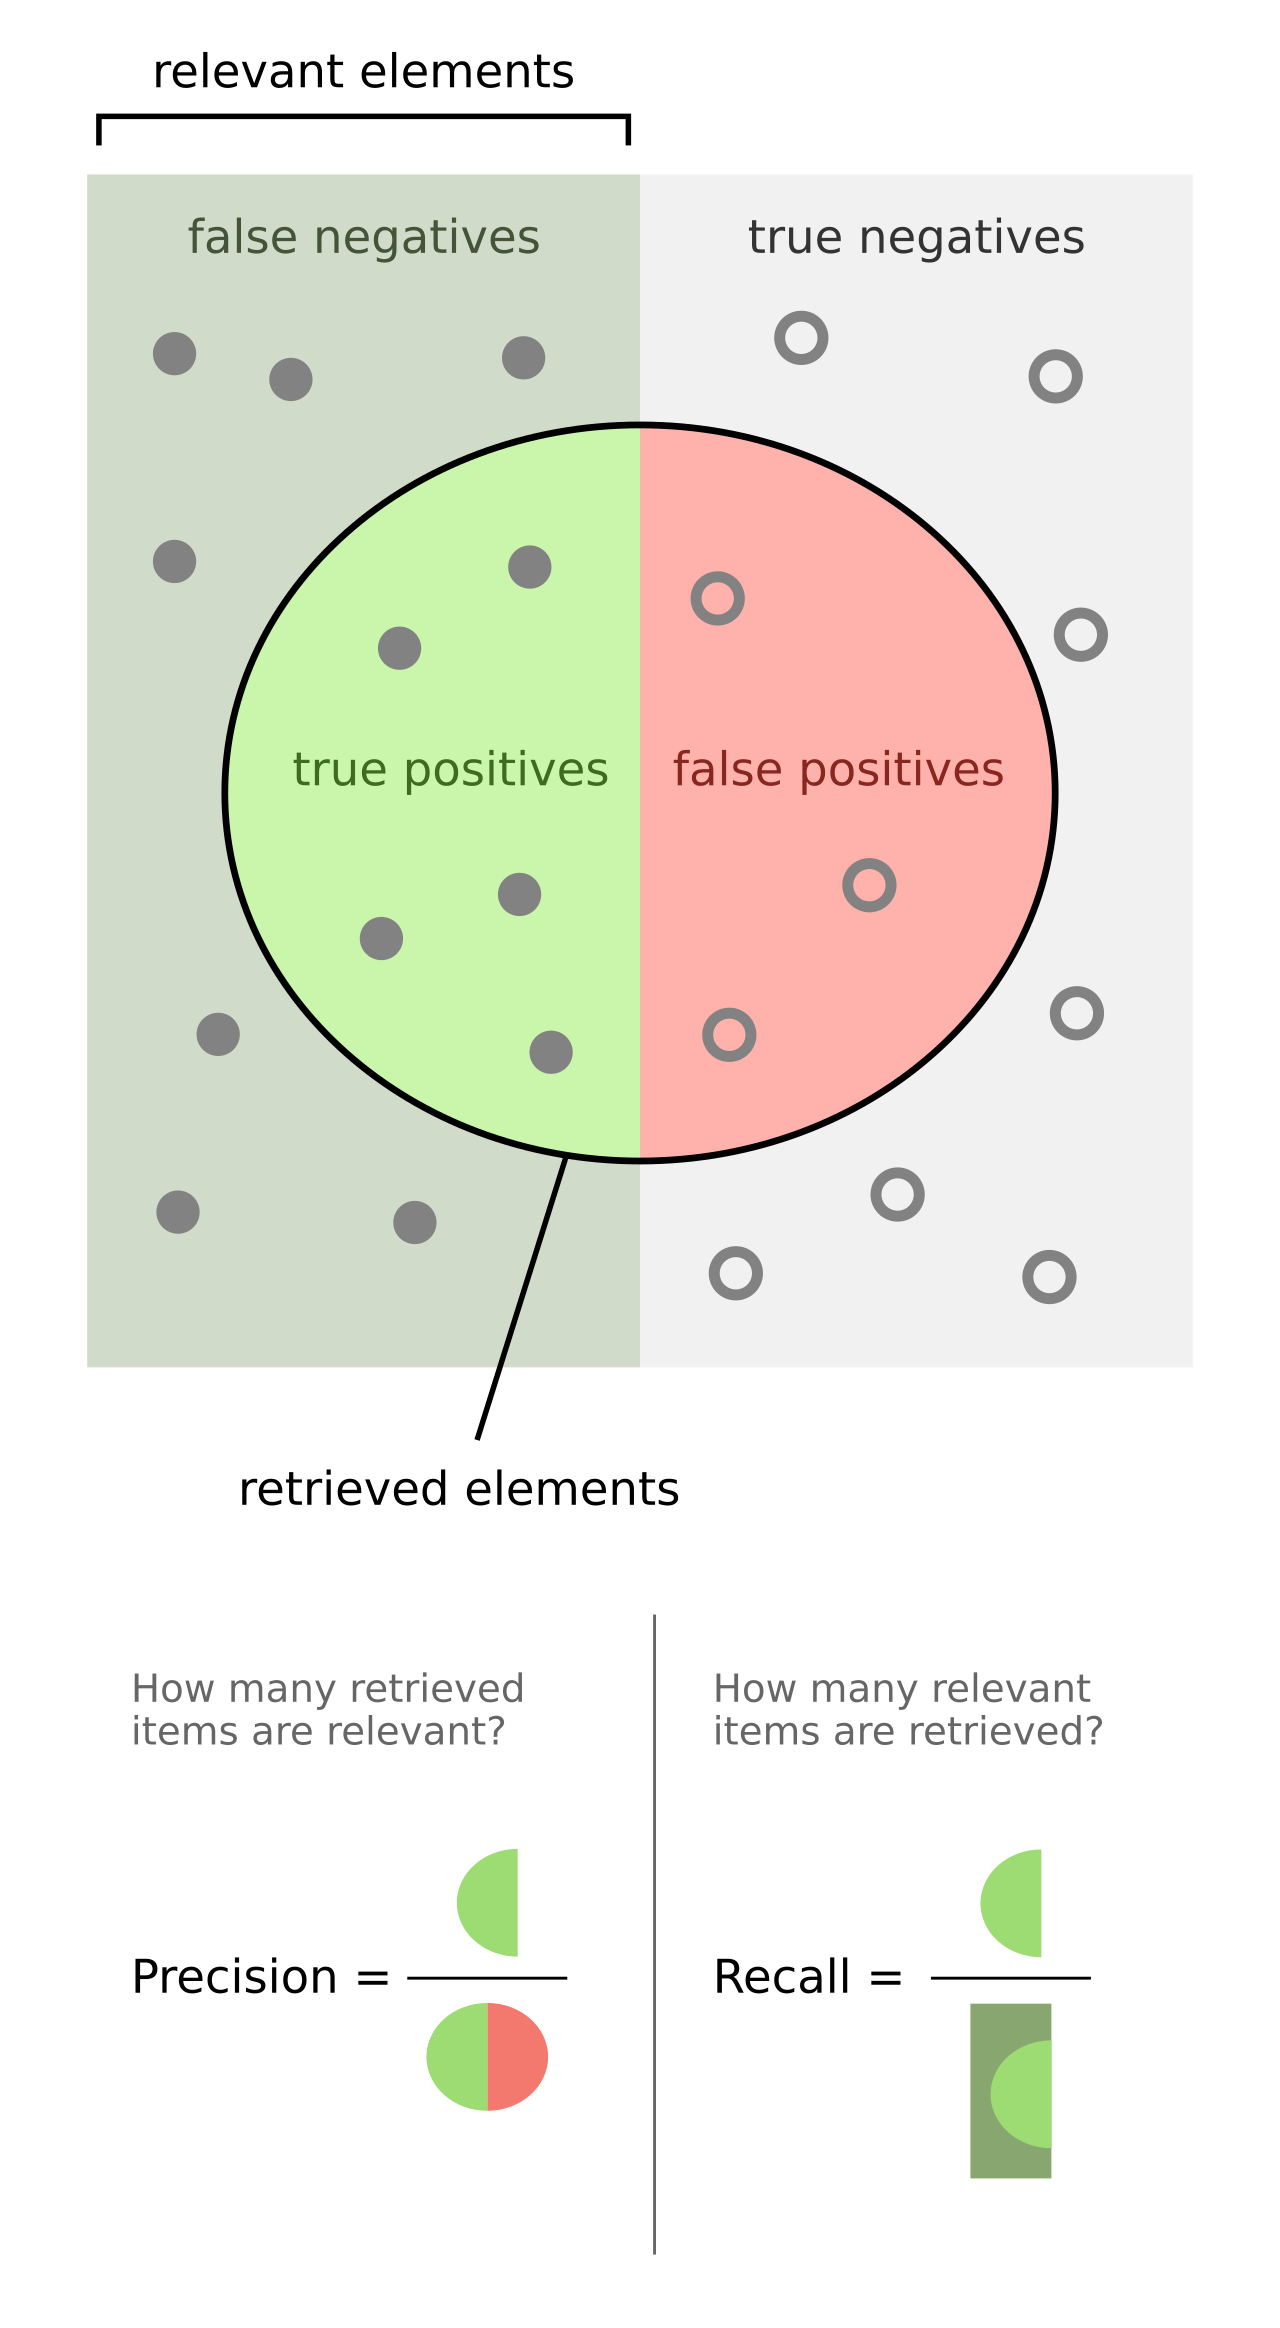
- ① 정밀도 — 분모가 '환자라고 부른 사람 전부'입니다. TP와 FP를 합친 수지요.
- ② 재현율 — 분모가 '진짜 환자 전부'입니다. 잡은 사람(TP)과 놓친 사람(FN)의 합입니다.
- ③ F1 — 두 수 a, b의 조화평균은
2*a*b / (a+b)입니다.
- ④ 기준점 판정 — 점수가 기준점 이상이면 1, 아니면 0.
>= 를 > 로 쓰면 경계에 딱 걸린 사람에서 답이 갈립니다.
- ⑤ 0~1로 눌러 넣기 — 5차시의 min-max입니다.
최저값을 빼고, 최고와 최저의 차로 나눕니다.
- ⑥ 총 손해 — 놓친 사람 수 × 그 대가 + 억울한 사람 수 × 그 대가.
TP와 TN이 식에 등장하지 않는 이유를 한 번 생각해 보세요.
ℹ️ 이 두 함수는 15차시가 그대로 가져갑니다
Ⅱ단원에는 차시를 건너 이어지는 코드가 몇 개 있습니다.
오늘 짜는 confusion과 scores가 그중 하나입니다.
15차시에서 우리는 급식 잔반을 예측하는 신경망을 학습시키고,
그 신경망의 성적을 오늘 만든 이 두 함수로 잽니다.
그래서 이름·인자 순서·돌려주는 순서를 바꾸면 안 됩니다.
특히 confusion(pairs)의 pairs는 (실제, 예측) 순서입니다.
뒤집어 넣어도 오류 없이 조용히 돌아가는데, FP와 FN만 자리가 바뀌어
정밀도와 재현율이 서로 뒤바뀝니다. 정확도와 F1은 한 자리도 안 바뀌므로 눈치채기 어렵습니다.
앞에서 익힌 검산법(재현율의 분모가 실제 환자 수 20과 같은가)을 이럴 때 씁니다.
✍️ 도전 — 실행 결과에서 세 가지를 찾는다
도전 ① 【3】의 숫자를 읽으세요.
기준점 999는 '모두 정상'이라고만 답하는 모델입니다. 정확도가 몇 %입니까?
재현율은 몇 %입니까? 두 숫자를 나란히 적고, 보건 선생님께 어느 쪽을 보고해야 하는지 쓰세요.
도전 ② 【4】의 마지막 두 줄을 보세요.
'정확도가 가장 높은 기준점'은 몇입니까? 그 기준점에서 놓친 환자는 몇 명입니까?
병원에서 실제로 써야 할 기준점과 같습니까? 다르다면 왜 다른지 한 문장으로 쓰세요.
도전 ③ 놓친 환자를 줄여 보세요.
FN을 3명 이하로 만드는 가장 높은 기준점은 몇이며, 그때 억울한 사람(FP)은 몇 명입니까?
한 명도 놓치지 않으려면(FN = 0) 기준점을 얼마까지 내려야 하고, 그때 FP는 몇 명입니까?
두 경우의 FP를 조원들과 견주어 보고, 우리 학교 보건실이라면
어느 쪽을 고를지 이야기해 보세요.
더 해 볼 것. 【2】의 if i < 20에서 20을
100이나 500으로 바꿔 다시 돌려 보세요.
'모두 정상' 모델의 정확도가 어떻게 변합니까? 재현율은요?
(원래대로 되돌리는 것을 잊지 마세요 — 뒤의 표가 전부 달라집니다.)
💡 실행 결과 【5】는 15차시로 가는 다리입니다
【5】는 같은 표를 0~1 위험도로 다시 만듭니다.
검사 점수를 5차시의 min-max로 0~1 구간에 눌러 넣은 뒤, 임계값을 0.1부터 0.9까지 올리는 것이지요.
결과는 이렇습니다 — 재현율은 100.0% → 5.0%로 내려가고,
정밀도는 2.0% → 100.0%로 올라갑니다. 정확히 반대로 움직입니다.
F1은 그 사이 임계값 0.7에서 28.0%로 가장 높습니다.
14차시에서 만들 신경망의 출력도 0~1 사이의 수입니다.
그래서 15차시에서 이 표를 그대로 다시 만들게 됩니다.
그때 임계값 0.5가 당연한 값이 아니라는 것을 오늘 미리 봐 두는 셈입니다.