단원 홈
2단원 · 8차시

가까운 것끼리
이웃 몇 명에게 물어볼 것인가

5차시에서 두 점 사이의 거리를 재는 dist()를 만들었습니다. 7차시에서는 정답이 붙은 데이터로 배우는 것을 지도학습이라 불렀지요. 오늘 그 둘을 합쳐 분류 알고리즘 하나를 처음부터 끝까지 직접 짭니다. 이름은 k-최근접 이웃, 규칙은 세 줄뿐입니다.

성취기준 12인기02-03 성취기준 12인기02-04
k-최근접 이웃다수결 결정 경계게으른 학습 정규화동점
🎯 학습 목표
  • k-최근접 이웃이 새 데이터를 분류하는 세 단계 — 거리 재기 · k개 뽑기 · 다수결 — 를 설명하고, 그 세 단계를 파이썬 함수 두 개로 직접 짤 수 있다.
  • 같은 씨앗 하나가 k에 따라 A와 B로 갈리는 것을 거리 목록으로 설명하고, k를 1에서 39까지 바꿔 가며 테스트 정확도가 60.0% → 93.3% → 33.3%로 움직이는 것을 직접 잰다.
  • 분류기가 하는 일이 특성 공간을 구역으로 나누는 것임을 알고, 경계가 흔들리는 폭을 mm 단위로 재어 k와 경계의 관계를 숫자로 말할 수 있다.
🤔

여는 장면 — 씨앗 한 알, 답이 둘

텃밭에서 씨앗 한 알을 주웠습니다. 봉투가 없어 품종을 모릅니다. 곁에는 품종을 아는 씨앗이 열 알 있어요. 우리가 가진 것은 두 가지 측정값뿐입니다 — 길이(mm)와 무게(g). 새로 주운 씨앗은 [6.1, 3.0]이었습니다.

가장 단순한 생각부터 해 봅시다. 가장 닮은 씨앗과 같은 품종일 것이다. '닮았다'를 숫자로 바꾸는 방법은 이미 배웠습니다. 5차시에서 만든 거리 함수를 쓰면 되지요. 실제로 재 보면 가장 가까운 씨앗은 [6.15, 2.95]이고 거리는 0.071, 품종은 A입니다. 답이 나왔습니다. 이 씨앗은 A입니다.

그런데 이웃을 하나 더 물어보면 어떨까요. 2위는 [6.0, 3.2], 거리 0.224, 품종 B. 3위도 B, 4위도 B, 5위도 B, 6위도 B입니다. 가까운 순서로 셋만 세면 A 1표 대 B 2표, 다섯을 세면 A 1표 대 B 4표예요. 이웃 하나에게 물으면 A, 셋에게 물으면 B입니다.

💭 오늘의 물음

이웃 몇 명에게 물어야 하는가? 그리고 그 수를 바꾸면 기계의 판단은 어디까지 달라지는가?

이 물음은 '몇 명'이라는 사소한 설정처럼 보이지만 그렇지 않습니다. 오늘 실제로 재 보면 이웃 수 하나를 바꾸는 것만으로 테스트 정확도가 60.0%에서 93.3%까지 오르내리고, 더 키우면 33.3%까지 무너집니다. 알고리즘은 한 글자도 바뀌지 않는데 말이지요.

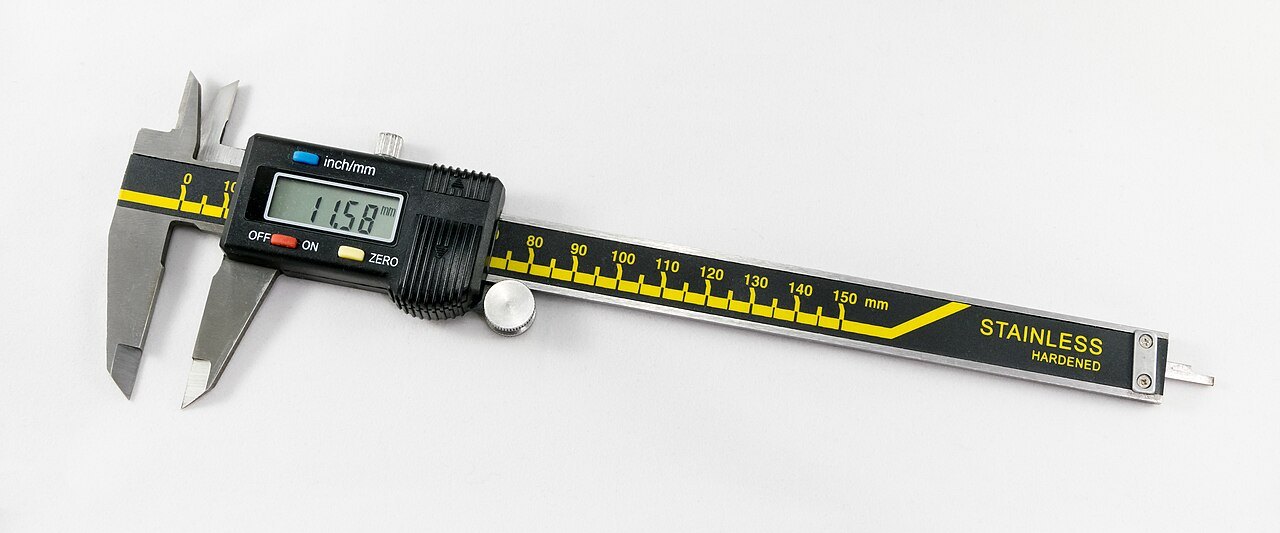
흰 바탕에 놓인 디지털 캘리퍼스. 표시창에 11.58 mm가 찍혀 있고 자에는 150 mm까지 눈금이 있다
길이를 잰다 — 첫 번째 특성. 디지털 캘리퍼스는 두 턱 사이에 물체를 끼워 길이를 0.01mm 단위로 읽는다(표시창의 11.58mm). 씨앗처럼 작은 것의 길이를 소수 둘째 자리까지 적을 수 있는 까닭이다. 출처: Jacek Halicki, Wikimedia Commons (CC BY-SA 4.0)
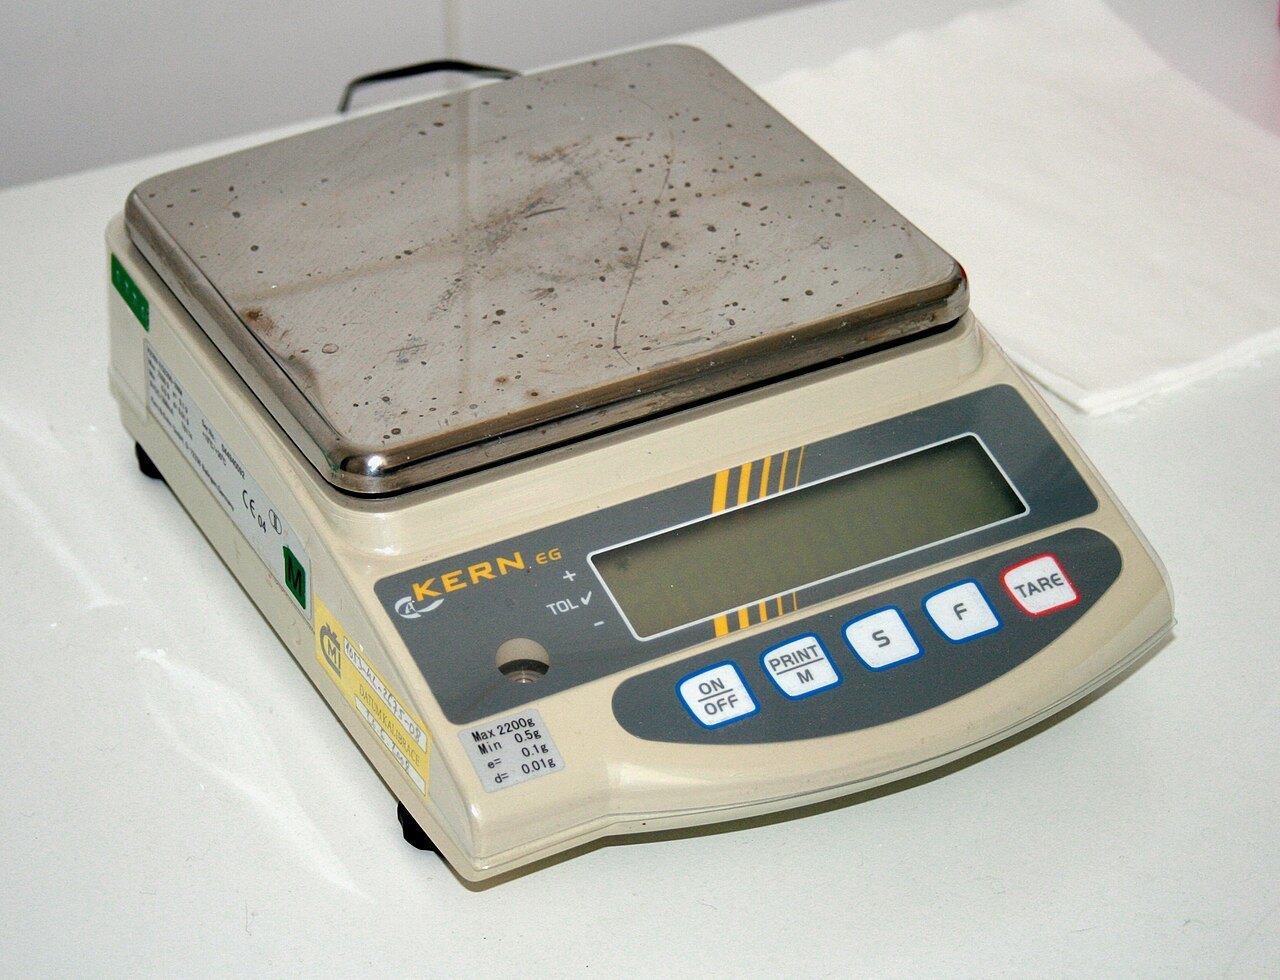
스테인리스 접시가 얹힌 실험실용 전자저울. 앞면에 ON/OFF·PRINT·TARE 단추가 있고 옆 스티커에 Max 2200g, d=0.01g이 적혀 있다
무게를 잰다 — 두 번째 특성. 왼쪽 아래 스티커의 d = 0.01g은 이 저울이 읽는 가장 작은 눈금이다. 같은 무게를 g으로 적을지 mg으로 적을지는 재는 사람이 정한 것이다. 오늘 그 선택이 판정을 뒤집는 것을 보게 된다. 출처: Karelj, Wikimedia Commons (Public domain)

씨앗 열 알의 값은 이렇습니다. 앞 넷이 A, 다음 넷이 B, 그리고 마지막 둘은 새 씨앗 바로 곁에 붙어 있는 두 알입니다.

씨앗 열 알과 새 씨앗. 이 열 줄은 뒤에서 쓸 마흔 줄짜리 데이터의 앞 열 줄이기도 하다. 손으로 따져 본 것과 코드가 낸 것이 같은 데이터 위에서 만나도록 그렇게 맞춰 두었다. 씨앗 값은 이 수업을 위해 지어낸 가상의 값이다.
번호길이(mm)무게(g)품종 새 씨앗 [6.1, 3.0]과의 거리가까운 순위
17.22.1A1.4218위
27.82.4A1.80310위
36.91.9A1.3607위
47.52.6A1.4569위
55.13.4B1.0774위
64.83.1B1.3046위
75.43.6B0.9223위
85.03.0B1.1005위
96.152.95A0.0711위
106.03.2B0.2242위

9번 씨앗을 눈여겨보세요. 길이 6.15에 무게 2.95인데 품종이 A로 적혀 있습니다. 그런데 그 둘레는 온통 B예요. 5·6·7·8·10번이 모두 B입니다. 이 한 알은 기록이 잘못됐을 수도 있습니다. 그런데 이웃을 하나만 묻는 방식은 바로 이 한 알에게 판단을 통째로 맡기는 셈입니다. 오늘 이야기의 씨앗이 여기 있습니다.

1

규칙이 세 줄뿐인 알고리즘

k-최근접 이웃(k-nearest neighbors, 줄여서 k-NN)이 하는 일은 전부입니다. 세 줄이면 다 적힙니다.

  1. 거리를 잰다. 새 데이터와 가지고 있는 모든 데이터 사이의 거리를 하나씩 계산해 가까운 순으로 줄을 세운다. — 5차시의 dist()가 여기서 쓰인다.
  2. 앞에서 k개를 뽑는다. 줄의 맨 앞 k개만 남기고 나머지는 잊는다.
  3. 다수결로 답한다. 뽑힌 k개의 이름표를 세어 표를 가장 많이 받은 이름표를 답으로 낸다.
① 거리를 잰다 A A B B A B B 모든 점까지 전부 잰다 ② 앞에서 k개만 k = 3 A 0.071 1위 B 0.224 2위 B 0.922 3위 B 1.077 4위 B 1.100 5위 ③ 다수결 A B 1 2 표 표 → 답은 B

k-NN 의 전부. 새 씨앗 [6.1, 3.0]에 k = 3을 적용한 실제 값이다. 1위는 A인데 2·3위가 B라서 표는 1 대 2, 답은 B가 된다.

학습이라고 부를 만한 단계가 없다

여기서 이상한 점이 하나 보입니다. 7차시에서 지도학습은 "정답이 붙은 데이터로 무언가를 배우는 것"이라 했는데, k-NN 에는 배우는 단계가 없습니다. 데이터를 그냥 들고 있을 뿐이에요. 가중치를 조정하지도, 규칙을 만들지도 않습니다.

그래서 k-NN 을 게으른 학습(lazy learning)이라 부릅니다. 공부는 하나도 안 해 두고 시험지를 받은 다음에야 교과서를 펼치는 셈이지요. 대신 대가를 치릅니다. 예측할 때마다 전체 데이터를 처음부터 끝까지 훑어야 합니다.

숫자로 따져 볼까요. 오늘 쓰는 데이터는 마흔 줄이라, 씨앗 하나를 판정하려면 거리를 마흔 번 계산합니다. 데이터가 백만 줄이면 백만 번이고, 씨앗 천 개를 판정하려면 십억 번입니다. 학습에 드는 시간은 0인데 예측에 드는 시간이 데이터 크기에 정비례해 늘어납니다. 13·14차시에서 만들 퍼셉트론과 층 쌓은 신경망은 정반대예요 — 학습에 오래 걸리지만, 다 배우고 나면 예측은 순식간입니다.

ℹ️ 그래도 k-NN 은 살아 있다

느린데 왜 아직도 쓸까요. 세 가지 이유가 있습니다.

첫째, 데이터를 더하기가 쉽습니다. 새 씨앗의 품종을 알게 되면 목록에 한 줄 붙이면 끝이에요. 신경망이라면 다시 학습시켜야 합니다.

둘째, 왜 그렇게 판정했는지 보여 줄 수 있습니다. "이 세 알과 가까워서 B라고 했다"고 이웃을 직접 내밀 수 있어요. 신경망은 가중치 수천 개를 내밀 수밖에 없습니다.

셋째, 실제로는 모든 데이터를 다 훑지 않아도 되는 자료구조(k-d 트리 등)가 있어서 생각보다 빠르게 만들 수 있습니다. 다만 그 방법도 특성이 수십 개를 넘어가면 힘을 잃습니다.

파이썬으로 옮기면 이렇게 짧습니다. 오늘 여러분이 채울 곳은 ????? 두 곳이에요.

def nearest(train, point, k):
    """① 거리를 재서 가까운 순으로 줄 세우고 ② 앞에서 k개를 뽑는다."""
    ranked = sorted(train, key=lambda item: ?????)
    return ranked[:k]


def knn(train, point, k):
    """③ 뽑힌 k개의 표를 세어 다수결로 답한다."""
    votes = {}
    for feat, label in nearest(train, point, k):
        votes[label] = votes.get(label, 0) + 1
    return ?????

여덟 줄입니다. 이 여덟 줄이 오늘 만들 분류기의 전부이고, 11차시에서 과적합을 재는 도구로 그대로 다시 쓰입니다.

2

k는 무엇을 정하는 수인가

새 씨앗 [6.1, 3.0]에 k를 바꿔 가며 물어본 결과입니다.

씨앗 열 알에 대한 실제 계산 결과. K = 1에서만 답이 A다.
K뽑힌 이웃의 품종(가까운 순)표예측
1AA 1A
3A B BA 1 · B 2B
5A B B B BA 1 · B 4B
9A B B B B B A A AA 4 · B 5B

K = 1이 갈리는 이유는 표의 두 줄에 전부 들어 있습니다. 1위 [6.15, 2.95]가 거리 0.071로 바짝 붙어 있고, 2위 [6.0, 3.2]가 0.224입니다. 세 배 넘게 차이 나지요. 그런데 3위부터 6위까지가 전부 B라서, 이웃을 셋만 늘려도 표가 뒤집힙니다.

여기서 k가 무엇을 정하는 수인지가 드러납니다. k는 기계가 한 알의 기록을 얼마나 믿을 것인가를 정하는 수입니다.

⚠️ k가 너무 작으면

가장 가까운 한 알이 잘못 적힌 기록이어도 그대로 따라갑니다. 잡음 하나에 답이 통째로 흔들려요. 실제로 위 열 알에서 [6.15, 2.95] 한 알을 지우면 K = 1의 답이 A에서 B로 바뀝니다 (K = 3·5·9는 그대로예요). 열 알 중 단 한 알이 답을 정하고 있었던 겁니다.

⚠️ k가 너무 크면

멀리 있는 데이터까지 투표에 끼어듭니다. 훈련 데이터가 마흔 개인데 k를 31로 두면, 어디를 물어도 답이 늘 A예요. 훈련 데이터에 A가 23개로 더 많기 때문입니다. 이쯤 되면 새 씨앗을 보지도 않고 답하는 기계입니다.

양 끝이 다 나쁘다면 가운데 어딘가가 좋을 겁니다. 그 '어딘가'를 실제로 재서 찾는 것이 오늘 손으로 할 일이에요. 그러려면 데이터를 두 몫으로 갈라 두어야 합니다.

💡 훈련 데이터와 테스트 데이터

씨앗 55알을 두 몫으로 갈랐습니다. 모델이 보고 배우는 훈련 데이터 40알과, 학습에 한 번도 쓰지 않고 채점에만 쓰는 테스트 데이터 15알입니다. 훈련 데이터에서 잰 성적은 외운 것일 수 있으니, 처음 보는 데이터로 다시 재야 뜻이 생깁니다.

⚠️ 오늘 돌릴 코드는 이것을 '시험'이라고 줄여 적습니다 (시험 정확도, 시험용 씨앗). 같은 말이에요. 이 책에서 쓰는 이름은 테스트 데이터이고, 11·12·15차시도 그 이름을 씁니다.

이 두 몫으로 k를 1부터 39까지 갈아 끼워 본 결과가 아래 표입니다. 미리 결과만 보면 이렇습니다.

훈련 씨앗 40개로 배우고, 학습에 한 번도 쓰지 않은 테스트 씨앗 15개로 채점한 결과 (0~1 정규화, 기준은 훈련 데이터에서만 뽑았다). 뒤에서 직접 돌려 볼 표다.
k훈련 정확도테스트 정확도맞은 개수
1100.0%60.0%9 / 15
377.5%73.3%11 / 15
577.5%93.3%14 / 15
780.0%86.7%13 / 15
980.0%86.7%13 / 15
1177.5%86.7%13 / 15
1577.5%86.7%13 / 15
1982.5%80.0%12 / 15
2577.5%73.3%11 / 15
3157.5%33.3%5 / 15
3957.5%33.3%5 / 15

표의 아래쪽 두 줄을 확인해 보세요. k = 31일 때 훈련 정확도가 57.5%인데, 훈련 씨앗 40개 중 A가 23개입니다. 23 ÷ 40 = 0.575지요. 테스트 정확도 33.3%도 마찬가지입니다. 테스트 씨앗 15개 중 A가 5개, 5 ÷ 15 = 0.333. 두 숫자가 품종 개수와 정확히 맞아떨어집니다. 이것이 "어디를 물어도 A라고만 답한다"의 증거입니다.

k = 1의 훈련 정확도가 100%인 까닭

표 맨 위가 이상하지 않나요. k = 1일 때 훈련 정확도가 정확히 100.0%입니다. 완벽해 보이지만, 잠깐 생각하면 당연합니다. 훈련 데이터 안의 어떤 씨앗을 골라 "이건 무슨 품종이니?"라고 물으면, 그 씨앗과 가장 가까운 씨앗은 자기 자신(거리 0)이에요. 자기가 자기에게 표를 던집니다.

그러니 k = 1의 100%는 외운 것이지 이해한 것이 아닙니다. 실제로 처음 보는 씨앗 15개로 채점하면 60.0%로 주저앉아요. 더 나쁜 소식이 있습니다. 테스트 씨앗 15개 중 B가 10개라서, 아무 생각 없이 "전부 B"라고만 우기는 기계의 정확도가 66.7%입니다. k = 1은 그것보다도 못합니다.

💡 정확도라는 숫자를 처음 의심하는 자리

"정확도 60%"만 들으면 절반보다 낫다고 느껴집니다. 그런데 아무 일도 안 하는 답이 66.7%를 받는 판이라면 60%는 실패예요. 모든 성적표에는 비교 대상이 있어야 합니다. 여기서 그 대상은 "늘 많은 쪽으로 답하기"이고, 이것을 기준선이라 부릅니다. 12차시에서 이 문제를 정면으로 다룹니다 — 거기서는 정확도 98%짜리 쓸모없는 모델이 나옵니다.

k를 홀수로 잡는 까닭

품종이 둘인데 k를 짝수로 두면 표가 갈릴 수 있습니다. k = 2에서 A 1표 B 1표가 되면 기계는 무엇을 골라야 할까요? 앞의 코드는 max(votes, key=votes.get)라고만 적혀 있어 동점일 때 무엇이 나올지 코드 어디에도 적혀 있지 않습니다.

실제로 돌려 보면 테스트 씨앗 15개 중 10개에서 동점이 납니다. 그런데 오류는 나지 않아요. 파이썬의 딕셔너리는 넣은 순서를 기억하고, max()는 값이 같으면 먼저 들어온 것을 돌려주기 때문입니다. 이웃을 가까운 순서로 넣었으니, 결과적으로 1위 이웃의 품종이 이깁니다.

증거는 이렇습니다. k = 2의 예측이 k = 1과 15개 모두 같습니다. 이웃을 하나 더 물었는데 바뀐 답이 하나도 없어요. 물어본 값이 없는 겁니다.

⚠️ 아무도 그렇게 하자고 정한 적이 없다

동점을 '1위 이웃 우선'으로 깨는 규칙은 k-NN 이 정한 것이 아닙니다. 파이썬 딕셔너리의 순서가 정한 것이에요. 다른 언어로 옮기면 답이 달라질 수 있습니다.

얼마나 달라질까요. k = 4에서 동점을 '가나다순'으로 깨도록 바꾸면 예측 3개가 통째로 뒤집히고 정확도가 12/15 = 80.0%에서 13/15 = 86.7%가 됩니다. 알고리즘은 한 글자도 안 바뀌었는데요. → 동점을 처리하는 규칙은 알고리즘의 일부입니다. 적어 두지 않으면 알고리즘이 덜 적힌 것이에요.

가장 간단한 해결은 k를 홀수로 잡는 것입니다. 품종이 둘일 때 홀수 k에서는 동점이 구조적으로 불가능해요. 실제로 k가 1·3·5·7·9·11일 때 동점은 단 한 번도 나지 않습니다. 다만 품종이 셋 이상이면 홀수로도 동점이 납니다(3표·3표·1표). 그때는 규칙을 직접 정해 적어야 해요.

3

분류기가 실제로 하는 일 — 평면을 구역으로 나눈다

지금까지는 씨앗 하나를 판정했습니다. 이제 시야를 넓혀 봅시다. 길이 4.4mm~8.6mm, 무게 1.4g~4.2g 사이의 모든 자리에 대해 "여기 씨앗이 있다면 무슨 품종일까"를 물으면 어떻게 될까요.

답은 그림이 됩니다. 평면이 A라고 답하는 구역과 B라고 답하는 구역으로 갈라지고, 그 사이에 선이 생깁니다. 이 선을 결정 경계(decision boundary)라 부릅니다.

분류기가 만들어 내는 것은 이 선입니다. 예측 하나하나가 아니라 평면 전체를 나누는 선이에요. 그리고 k를 바꾸면 이 선의 모양이 바뀝니다. 아래는 씨앗 열 알로 그린 두 장의 지도입니다. 계산은 실제로 21 × 13 = 273자리에서 돌렸습니다.

K = 1 · 경계가 1.58mm 휜다 A A A A B B B B A B K = 9 · 경계가 0.60mm 안에 든다 A A A A B B B B A B 4.4mm 8.6mm 길이(mm) → 4.4mm 8.6mm 길이(mm) → 무게 1.4g → 4.2g 품종 A 씨앗 품종 B 씨앗 A로 판정하는 자리 B로 판정하는 자리 새 씨앗 [6.1, 3.0]

같은 씨앗 열 알, 같은 알고리즘. 바뀐 것은 이웃 수 하나뿐이다. 왼쪽 K = 1의 경계는 무게 1.6g에서 2.8g까지 여섯 줄 동안 같은 자리에 못 박힌 듯 서 있다가, 그 위 3.0 · 3.3 · 3.5g에서 한 번에 두 칸씩 오른쪽으로 건너뛴다. 맨 아래 줄과 맨 위 줄의 차이가 아홉 칸이다. 오른쪽 K = 9의 경계는 한 줄에 한 칸씩 고르게 올라 그 차이가 다섯 칸뿐이다 — 거의 곧은 선이다. 왼쪽 지도의 무게 3.0g 줄을 짚어 보라. A 구역의 왼쪽 끝이 [6.15, 2.95]가 놓인 칸에서 딱 멈춘다 — 그 한 알이 선을 거기 붙잡고 있다. K = 9에서는 같은 줄의 경계가 두 칸 더 오른쪽에 있다. 그 한 알이 더는 선을 붙잡지 못한다.

'매끄러워진다'를 눈이 아니라 자로 잰다

지도 두 장을 나란히 놓으면 차이가 보이긴 합니다. 그런데 "매끄러워졌다"는 말은 느낌이지 측정이 아니에요. 숫자로 재 봅시다.

방법은 간단합니다. 무게를 하나로 고정하고, 길이를 4.4mm부터 0.01mm씩 늘려 가며 답이 A에서 B로(또는 그 반대로) 바뀌는 지점을 찾습니다. 무게를 여섯 가지로 바꿔 가며 같은 일을 하면, 경계가 어디를 지나는지 여섯 점이 나옵니다.

무게를 고정하고 길이를 0.01mm씩 옮겨 찾은 경계 좌표(mm). 씨앗 열 알, 정규화 없음. 맨 아래 줄이 이 절의 결론이다.
무게K = 1K = 3K = 9
1.8 g5.535.456.00
2.2 g5.555.816.18
2.6 g5.566.046.27
3.0 g5.956.416.36
3.4 g6.626.606.46
3.8 g7.116.796.60
흔들리는 폭1.58 mm 1.34 mm0.60 mm

K = 1의 경계는 무게가 달라짐에 따라 1.58mm나 좌우로 휘청입니다. K = 9에서는 0.60mm, 곧 거의 곧은 선이에요. 2.6배 차이입니다. 이제 "K를 키우면 경계가 매끄러워진다"가 느낌이 아니라 잰 값이 되었습니다.

🔗 11차시로 이어지는 자리

이 '울퉁불퉁함'에는 이름이 있습니다. K = 1의 경계는 씨앗 한 알 한 알을 전부 맞히려고 휘어진 것이고, 그렇게 데이터의 잡음까지 따라간 결과가 훈련 100% · 테스트 60.0%라는 성적입니다. 이것을 과적합(overfitting)이라 부르고, 11차시가 통째로 이 문제를 다룹니다. 그때 다시 쓸 도구가 오늘 짜는 knn()입니다.

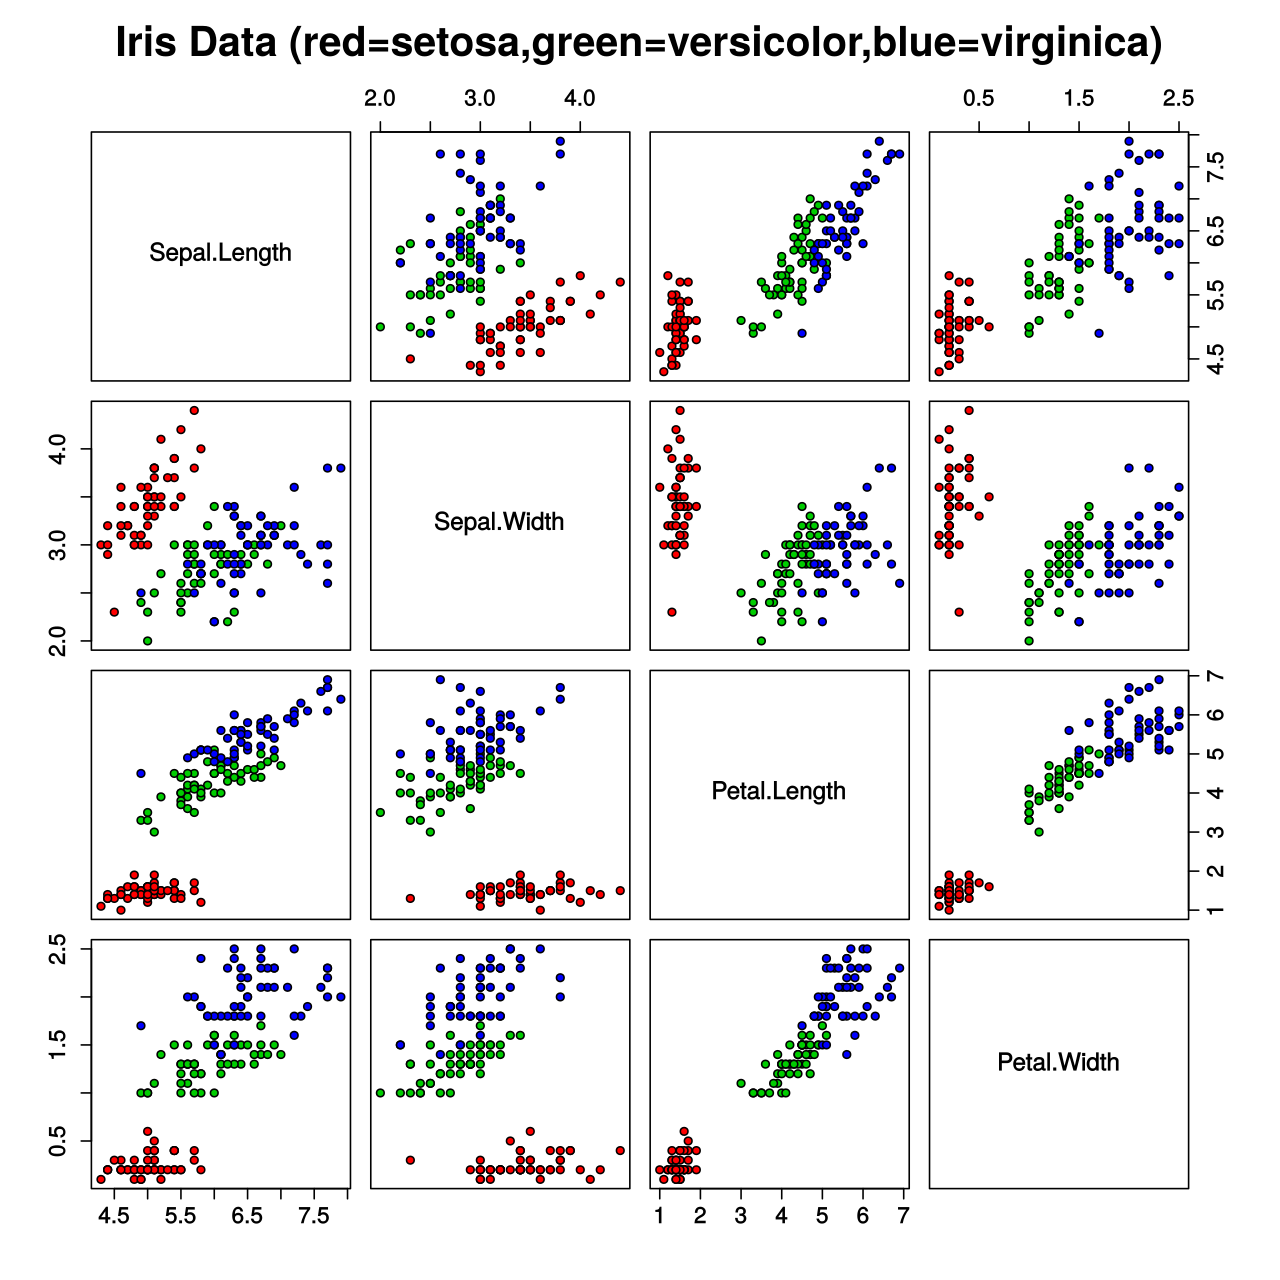
실제 데이터에서도 결정 경계는 이렇게 그려집니다. 아래 산점도를 보세요. 붓꽃의 특성 네 개(꽃받침 길이·너비, 꽃잎 길이·너비)를 둘씩 짝지어 그린 작은 그림 열두 장입니다. 어느 두 특성을 골라도 빨간 점(세토사)은 따로 떨어진 무리를 이룹니다. 하지만 초록(버시컬러)과 파랑(버지니카)은 맞닿아 겹치는 자리가 있고, 그 자리에서는 어떤 분류기든 틀립니다.

붓꽃 데이터의 산점도 행렬. 꽃받침과 꽃잎의 길이·너비 네 특성을 둘씩 짝지은 작은 산점도 열두 장에 세토사는 빨강, 버시컬러는 초록, 버지니카는 파랑 점으로 찍혀 있다. 빨간 점은 늘 따로 모여 있고 초록과 파랑은 일부 겹친다.
붓꽃(Iris) 데이터 산점도 — 1936년부터 쓰여 온 분류 예제다. 특성 두 개를 축으로 삼으면 세 품종이 구역으로 나뉜다는 것이 눈으로 보인다. 특히 꽃잎 길이·너비 칸에서는 빨강·초록·파랑이 거의 한 줄로 늘어서 갈라진다. k-NN 이 하는 일은 이 그림 위에 경계선을 긋는 것이고, 초록과 파랑이 겹치는 자리에서는 반드시 틀린다. 오늘 우리 씨앗 데이터도 서로 모순되는 두 알 때문에 100%가 나올 수 없다. 출처: Nicoguaro, Wikimedia Commons (CC BY 4.0)
4

거리를 재는 알고리즘이라는 것의 대가

k-NN 은 처음부터 끝까지 거리로만 움직입니다. 그러니 거리 계산이 흔들리면 알고리즘 전체가 흔들려요. 그런데 거리는 우리가 생각하는 것보다 훨씬 쉽게 흔들립니다. 저울의 단위를 바꾸기만 해도 흔들립니다.

실험해 봅시다. 무게를 g 대신 mg으로 적어 보는 겁니다. 2.1g은 2100mg이 되지요. 데이터는 하나도 안 바뀌었습니다. 같은 씨앗, 같은 무게예요. 적는 방식만 바꿨습니다.

테스트 씨앗 15개에 대한 정확도(%). 가로는 k = 1 · 3 · 5 · 7 · 9 · 11. 가로 한 줄이 한 가지 설정이다.
데이터를 적은 방식13 57911
무게를 g으로 · 정규화 안 함 60.080.093.3 86.793.386.7
무게를 mg으로 · 정규화 안 함 53.360.046.7 60.066.760.0
무게를 kg으로 · 정규화 안 함 46.766.780.0 80.080.073.3
g · 0~1 정규화 60.073.393.3 86.786.786.7
mg · 0~1 정규화 60.073.393.3 86.786.786.7
kg · 0~1 정규화 60.073.393.3 86.786.786.7
참고 — 무게만 쓴 것 53.3 60.0 46.7 60.0 66.7 60.0
참고 — 길이만 쓴 것 40.066.780.0 80.080.073.3

표를 위아래로 읽어 보세요. 두 가지가 한꺼번에 드러납니다.

첫째, mg으로 적은 줄과 '무게만' 쓴 줄이 여섯 칸 모두 같습니다. 우연이 아니에요. 예측 15개도 15개 모두 같습니다. 무게를 mg으로 적으면 두 씨앗의 무게 차이가 수백~수천이 되고, 길이 차이는 기껏해야 4입니다. 제곱해서 더하면 길이 쪽 값은 있으나 마나가 되지요. 길이라는 특성이 계산에서 사라진 것이고, 위 표가 그것을 증명합니다. kg으로 적은 줄이 '길이만' 쓴 줄과 닮은 것도 같은 이유입니다 — 이번엔 무게가 사라졌어요.

둘째, 정규화를 켠 세 줄은 완전히 같습니다. 소수점 한 자리도 다르지 않아요. 5차시에서 만든 minmax_fit()·minmax_apply()가 두 특성을 모두 0~1 사이로 눌러 놓으면, 원래 g으로 적었든 mg으로 적었든 같은 좌표가 됩니다. 정규화가 하는 일은 단위를 지우는 것입니다.

⚠️ 그런데 정규화가 정확도를 올려 주지는 않는다

표의 첫 줄과 넷째 줄을 견줘 보세요. 둘 다 g 단위입니다. 정규화를 안 한 쪽이 k = 3에서 80.0 대 73.3, k = 9에서 93.3 대 86.7로 오히려 높습니다.

왜 그럴까요. 이 데이터에서 길이의 폭은 4.17(4.51~8.68mm), 무게의 폭은 2.75(1.42~4.17g)입니다. 두 특성의 크기가 애초에 비슷해요. 정규화가 할 일이 별로 없는 판입니다.

그러니 "정규화하면 정확도가 오른다"는 문장은 틀렸습니다. 맞는 문장은 이렇습니다 — 정규화는 '단위를 어떻게 적을지'라는 사람의 선택이 결과를 정하지 못하게 막는 장치다. 성적을 올리는 도구가 아니라 손을 떼게 하는 도구예요. 이 데이터에서 g으로 적을지 mg으로 적을지는 저울 산 사람 마음인데, 정규화를 켜 두면 그 마음이 판정에 끼어들지 못합니다.

거리 재는 방식도 하나가 아니다

5차시에서 쓴 거리는 유클리드 거리였습니다. 가로 차와 세로 차를 제곱해 더하고 뿌리를 씌우는, 자로 잰 직선 거리예요. 그런데 거리를 재는 방식은 여럿입니다. 맨해튼 거리는 제곱하지 않고 차의 절댓값을 그냥 더합니다.

거리 재는 방식만 바꾼 결과(0~1 정규화, 테스트 15개 정확도 %). 데이터도 k도 그대로다.
거리13 57911
유클리드 (5차시의 그 거리) 60.073.393.3 86.786.786.7
맨해튼 53.373.386.7 93.386.786.7

가장 좋은 k가 5에서 7로 옮겨 갔습니다. k-NN 을 쓴다는 것은 이웃 수 k만 고르는 일이 아니라, 거리를 어떻게 잴지도 함께 고르는 일입니다. 정규화 방식(0~1 / z-점수), 거리 방식(유클리드 / 맨해튼), 이웃 수(k) — 정할 것이 최소 셋이에요. 알고리즘이 여덟 줄이라고 해서 결정할 것까지 적은 것은 아닙니다.

💻

손으로 ① — 씨앗을 놓아 보고, 경계를 자로 잰다

아래 판을 누르면 그 자리에 새 씨앗이 놓입니다. 누른 채 끌면 씨앗이 따라오고, 판정은 그때그때 다시 계산됩니다. 가까운 k개 이웃까지 노란 선이 이어지고, 배경의 옅은 색이 결정 경계예요. k 슬라이더를 움직이면 그 경계가 눈앞에서 다시 그려집니다.

공책을 펴 두세요. 아래 세 과제의 답을 확인 문제에서 다시 묻습니다.

🌱 씨앗 판별기 — 이웃 몇 명에게 물어볼 것인가 INTERACTIVE

판을 누르거나 끌어 새 씨앗을 놓습니다(길이는 0.01mm, 무게는 0.1g 단위로 붙습니다). 정확한 좌표가 필요하면 아래 숫자 칸에 직접 적어도 됩니다. 📏 경계 찾기는 지금 무게를 고정한 채 길이를 4.4mm부터 0.01mm씩 늘려 판정이 처음 뒤집히는 자리를 찾아 줍니다 — 개념 3의 표를 여러분이 직접 만드는 단추예요.

새 씨앗—
판정—
표 (A · B)—
1위 이웃 거리—
테스트 15개 정확도—
훈련 정확도—
1
씨앗을 아직 놓지 않았습니다. 판을 누르거나 🌱 씨앗 [6.1, 3.0] 놓기를 눌러 보세요.
[안내] 씨앗 열 알 · 정규화 안 함 · g · 유클리드 — 개념 2·3의 표와 같은 설정입니다.

※ 배경의 결정 경계는 5픽셀 격자마다 실제로 k-NN 을 돌려 칠한 것입니다(미리 그려 둔 그림이 아닙니다). 동점 처리는 파이썬 코드와 똑같이 1위 이웃 우선으로 맞춰 두었으므로, 뒤에서 파이썬으로 낸 값과 이 화면의 값이 같아야 정상입니다. 다르면 둘 중 하나가 틀린 것입니다.
※ 정확도 두 칸은 씨앗을 열 알로 두든 마흔 알로 두든 같은 테스트 씨앗 15개로 잽니다. 열 알로 두면 테스트 정확도가 오히려 높게 나오는데(k = 1에서 86.7%), 씨앗이 적을수록 좋다는 뜻이 아닙니다. 손으로 따지기 좋게 고른 앞 열 알이 유난히 깔끔해서 그런 것이고, 마흔 알에는 잘못 적힌 씨앗이 여럿 섞여 있습니다. 진짜 데이터가 그렇습니다.

과제 ① 표를 채운다 — 경계가 흔들리는 폭을 잰다

설정을 씨앗 열 알 · 정규화 안 함 · g · 유클리드로 두고(초기 상태입니다), k와 무게를 바꿔 가며 📏 경계 찾기를 열여덟 번 누릅니다. 무게는 숫자 칸에 직접 적는 편이 빠릅니다.

무게(g)K = 1 경계K = 3 경계K = 9 경계
1.8
2.2
2.6
3.0
3.4
3.8
최대 − 최소

맨 아랫줄이 경계가 흔들리는 폭입니다. 세 값을 견주어 "K를 키우면 경계는 ○○해진다"를 한 문장으로 적어 보세요. (여러분이 채운 값은 개념 3의 표와 같아야 합니다. 다르면 설정을 다시 확인하세요.)

과제 ② 반례를 만든다 — 판정이 뒤집히는 자리

씨앗을 마흔 알로, 정규화를 0~1로 바꿉니다. 이제 씨앗을 이리저리 끌면서 k = 1과 k = 5의 판정이 서로 다른 자리를 찾으세요. k를 1로 두고 판정을 본 뒤 슬라이더를 5로 옮겨 보면 됩니다.

  • 그런 자리를 세 곳 찾아 좌표를 적으세요.
  • 세 자리에는 공통점이 하나 있습니다. 무엇인가요? (힌트: 1위 이웃의 품종과, k = 5일 때 뽑힌 다섯 알의 표(A·B)를 나란히 적어 보세요)
  • 거꾸로, k를 1에서 11까지 아무리 바꿔도 판정이 안 바뀌는 자리도 한 곳 찾아 적으세요.

과제 ③ 문턱을 찾는다 — 단위가 판을 뒤집는 지점

설정을 마흔 알 · 정규화 안 함 · g로 두고 k를 5로 맞춥니다. 테스트 15개 정확도 칸을 읽어 적으세요. 그다음 무게 단위만 mg으로 바꿉니다.

  1. 정확도가 얼마에서 얼마로 떨어졌는지 적으세요.
  2. 배경의 결정 경계 모양이 어떻게 변했는지 한 문장으로 적으세요. (세로선이던 것이 무엇이 되었나요?)
  3. 정규화를 0~1로 켜 보세요. 정확도가 돌아옵니까? 경계 모양도 돌아옵니까?
  4. 단위를 kg으로 바꾸면 경계는 어느 방향의 곧은 선이 됩니까? mg일 때와 정확히 반대인 까닭도 함께 적으세요.
💡 화면과 코드가 같은 값을 내야 한다

이 시뮬레이터는 뒤에서 여러분이 돌릴 파이썬과 같은 알고리즘·같은 동점 규칙으로 짜여 있습니다. 정규화 기준을 훈련 데이터에서만 뽑는 것까지 같아요. 그러니 화면에서 읽은 숫자와 파이썬이 찍은 숫자는 같아야 합니다. 직접 대조해 보세요 — 그것이 이 책의 문법입니다.

💻

손으로 ② — 여덟 줄을 직접 채운다

이제 화면이 대신 해 주던 계산을 직접 짭니다. 채울 곳은 두 곳이에요.

💡 빈칸 ① — 무엇을 기준으로 줄을 세울까

sorted(train, key=lambda item: ?????)

item은 ([6.15, 2.95], "A")처럼 생겼습니다. 좌표는 item[0]이고 품종은 item[1]이에요. 우리가 줄 세우고 싶은 기준은 새 점과 이 항목 사이의 거리입니다. 주의 — dist(point, item)이라고 쓰면 리스트와 문자열을 빼려다 TypeError로 죽습니다. 그건 바로 들키니 오히려 안전한 오류예요.

💡 빈칸 ② — 표를 가장 많이 받은 품종 꺼내기

votes는 {'A': 1, 'B': 2}처럼 생겼습니다. 여기서 값이 가장 큰 키를 꺼내야 해요. max()는 key=로 '무엇을 기준으로 비교할지'를 정할 수 있습니다.

함정 — key=를 빠뜨리고 max(votes)라고만 쓰면 표를 세지 않고 가나다순으로 고릅니다. 그런데 【1】의 열 알짜리 장면에서는 A·B·B·B로 정답과 똑같이 나와서 절대 안 들킵니다. 뒤 칸에서 k를 키웠는데 답이 전부 한 품종으로 굳으면 이 자리를 의심하세요.

돌린 뒤에 할 것

  1. 【1】의 거리 목록에서 1위와 2위의 거리를 공책에 적으세요. 그리고 "K = 1만 A인 이유"를 그 두 줄만 근거로 두 문장으로 쓰세요.
  2. 【2】의 마지막에 찍히는 경계 폭 세 개를 시뮬레이터에서 손으로 채운 표와 견주세요. 같습니까? 다르다면 어느 설정이 달랐을까요?
  3. 씨앗 ([6.15, 2.95], "A") 줄을 지우고 다시 돌려 보세요. K = 1의 답이 무엇으로 바뀝니까? K = 3·5·9는요?
  4. 새 씨앗 좌표 new를 바꿔 가며, K = 1과 K = 3의 답이 갈리는 자리를 두 곳 더 찾아 적으세요.
💻

손으로 ③ — 마흔 알로 k를 갈아 끼우고 채점한다

열 알로는 정확도를 잴 수 없습니다. 그래서 씨앗을 마흔 알로 늘리고, 학습에 한 번도 쓰지 않는 테스트용 열다섯 알을 따로 두었습니다. 앞 열 줄은 방금 손으로 따진 그 열 알이에요 — 같은 데이터가 이어집니다.

이 칸에서 채울 곳은 한 곳입니다. 5차시의 규칙을 다시 묻는 자리예요.

⚠️ 빈칸 ③ — 정규화 기준을 무엇으로 잡는가

LO, HI = minmax_fit(?????)

0~1로 누를 기준(최솟값·최댓값)을 어디서 뽑아야 할까요. 훈련 데이터만입니까, 훈련 + 테스트입니까? 5차시에서 정한 규칙을 떠올리세요.

여기가 오늘 가장 고약한 자리입니다. 이 데이터에서는 훈련 + 테스트를 다 넣어도 결과가 한 자리도 안 바뀝니다. 테스트 씨앗 15개가 전부 훈련 씨앗의 범위 안에 들어 있어서 최솟값·최댓값이 그대로거든요. 실행으로는 이 실수를 절대 잡을 수 없습니다. 그런데도 규칙을 지켜야 하는 까닭이 【6】에 나옵니다.

돌린 뒤에 할 것

  1. 【3】의 표에서 테스트 정확도가 가장 높은 k와 그 값을 적으세요. 그리고 "무조건 B"의 점수 66.7%보다 낮은 k가 있는지 찾아 적으세요.
  2. 【4】에서 홀수 k의 동점 개수를 확인하세요. 전부 몇 개입니까? 왜 그렇습니까?
  3. 【5】에서 mg 줄과 무게만 줄이 같은지 여섯 칸을 하나씩 대조하세요. 같다면 그것이 무엇을 뜻합니까?
  4. 【6】의 마지막 씨앗 [9.1, 2.0]이 0~1로 눌렸을 때 1.101이 나옵니다. 이것이 왜 버그가 아닌지 두 문장으로 쓰세요.
  5. 부수어 보기. k = 0으로 두면 어떻게 됩니까? k = 41(훈련 40개보다 크게)로 두면요? 하나는 죽고 하나는 조용히 도는데, 어느 쪽이 더 위험한 오류일까요?
ℹ️ 여기서 만든 세 함수는 11차시로 간다

nearest() · knn() · accuracy() 셋은 11차시가 글자 그대로 다시 싣습니다. 거기서는 이 셋이 과적합을 재는 자로 쓰여요 — 데이터 수를 20 → 160으로 늘려 가며 훈련 정확도와 테스트 정확도가 벌어지는 폭을 잽니다. 오늘 k = 1에서 본 100.0% 대 60.0%가 바로 그 벌어짐의 첫 사례입니다.
📖

정리 — 여덟 줄이 만든 선 하나

오늘 우리는 분류 알고리즘 하나를 통째로 짰습니다. 세 단계, 여덟 줄이었어요. 그런데 그 여덟 줄을 돌리는 동안 정할 것이 셋이나 나왔습니다.

k-NN 을 쓴다는 것은 이 넷을 정한다는 뜻이다. 알고리즘이 짧다고 결정이 적은 것은 아니다.
정해야 할 것안 정하면오늘 잰 값
이웃 수 k k = 1은 잡음 한 알을 그대로 믿고, k = 31은 아무나 물어도 A라고 답한다 테스트 정확도 60.0 → 93.3 → 33.3%
k를 홀수로 둘 것인가 동점이 나는데 코드 어디에도 처리 규칙이 안 적혀 있다 k = 2에서 동점 10/15, 답은 k = 1과 15/15 같음
정규화를 할 것인가 저울 단위를 고른 사람이 판정을 정한다 mg으로 적으면 93.3 → 46.7%
거리를 어떻게 잴 것인가 가장 좋은 k가 어디인지도 달라진다 맨해튼으로 바꾸면 정점이 k = 5 → 7

그리고 오늘 처음 만난 눈이 하나 더 있습니다. 결정 경계예요. 분류기가 실제로 만들어 내는 것은 예측 하나하나가 아니라 평면을 나누는 선이고, 그 선이 얼마나 구불구불한지를 1.58mm 대 0.60mm처럼 잴 수 있었습니다. 이 '구불구불함'을 11차시에서 과적합이라는 이름으로 다시 만납니다.

⚠️ 오늘 우리가 한 일 중 하나는 사실 반칙이다

테스트 정확도 표를 쭉 보고 "k = 5가 제일 높네" 하고 골랐지요. 그런데 테스트 데이터는 학습에 쓰면 안 되는 데이터입니다. 점수를 보고 설정을 고르는 것도 학습에 쓰는 것이에요. 지금 우리는 시험지를 미리 보고 답을 맞춘 셈입니다. 왜 반칙인지, 그러면 k를 어떻게 골라야 하는지는 11차시에서 정면으로 다룹니다. 오늘은 "이건 반칙이다"라는 것만 알고 넘어갑니다.

🔗 이 차시가 이어지는 곳
  • 5차시에서 받은 것 — dist()·minmax_fit()·minmax_apply(). 거리를 재고 단위를 지우는 부품을 글자 하나 안 고치고 그대로 실었습니다.
  • 11차시로 넘기는 것 — nearest()·knn()·accuracy(). 거기서는 이 셋이 과적합을 재는 자가 됩니다.
  • 12차시로 넘기는 물음 — "정확도 60%는 좋은 성적인가?" 오늘은 66.7%라는 기준선 하나로 답했지만, 12차시에서는 정확도라는 숫자 자체를 네 칸(혼동행렬)으로 갈라 봅니다.
🔁 되돌아보기

오늘 여덟 줄짜리 분류기를 직접 짜고, 이웃 수 하나를 바꾸는 것만으로 테스트 정확도가 60.0% → 93.3% → 33.3%로 움직이는 것을 재 보았습니다. 경계가 흔들리는 폭도 1.58mm 대 0.60mm로 잴 수 있었지요. 다음 시간에는 방향을 바꿉니다 — 이웃에게 물어보는 대신, 답에서 얼마나 틀렸는지를 재어 조금씩 고쳐 가는 법(경사하강법)을 배웁니다. 그 방법이 13·14차시의 신경망으로 이어집니다.

✅

확인 문제

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. k-최근접 이웃이 새 데이터를 분류하는 세 단계를 순서대로 쓰시오. 그리고 이 알고리즘을 왜 '게으른 학습'이라 부르는지, 세 단계 중 어느 단계도 하지 않는 일이 무엇인지에 근거해 설명하시오.
📖 모범 답안

세 단계 — ① 새 데이터와 가지고 있는 모든 데이터 사이의 거리를 재어 가까운 순으로 줄을 세운다. ② 그 줄의 앞에서 k개를 뽑는다. ③ 뽑힌 k개의 이름표를 세어 다수결로 답한다.

게으른 학습인 까닭 — 세 단계 어디에도 미리 무언가를 만들어 두는 일이 없다. 가중치를 조정하지도, 규칙을 뽑아내지도 않는다. 데이터를 그냥 저장해 둘 뿐이고, 계산은 예측을 요청받은 그 순간에야 시작된다. 그래서 학습에 드는 시간은 사실상 0이다.

대신 예측이 느리다. 데이터가 마흔 줄이면 거리를 마흔 번, 백만 줄이면 백만 번 계산한다. 예측 시간이 데이터 크기에 정비례해 늘어난다. 데이터가 크고 실시간 응답이 필요한 곳(예: 초당 수천 건을 판정해야 하는 서비스)에서 불리하다.

2. 손으로 ②에서 돌린 【1】의 출력을 보고 답하시오. 새 씨앗 [6.1, 3.0]에 대해 K = 1과 K = 3의 예측이 갈린 이유를 거리 목록의 구체적인 값을 근거로 설명하시오. 그리고 K를 5·9로 키워도 답이 바뀌지 않은 까닭도 함께 쓰시오.
📖 모범 답안

K = 1은 A, K = 3은 B다. 거리 목록의 위 세 줄이 이유를 다 말한다.

1위 [6.15, 2.95] 품종 A, 거리 0.071 — 거의 붙어 있다. 2위 [6.0, 3.2] 품종 B, 거리 0.224. 3위 [5.4, 3.6] 품종 B, 거리 0.922. K = 1은 1위만 보므로 A. K = 3은 A 1표 대 B 2표라서 B가 된다.

K를 키워도 안 바뀌는 까닭 — 4위부터 6위까지도 전부 B다 (1.077 · 1.100 · 1.304). 그래서 K = 5에서는 A 1표 대 B 4표로 오히려 벌어진다. A가 다시 나오는 것은 7위(거리 1.360)부터인데, K = 9에서도 A 4표 대 B 5표로 여전히 B가 이긴다. 새 씨앗 둘레가 B 무리 쪽에 놓여 있고, A 한 알만 그 안에 섞여 있는 것이다.

3. 훈련 씨앗 마흔 알로 k = 1을 돌리면 훈련 정확도가 정확히 100.0%가 나온다. 이 값이 왜 당연한지 설명하시오. 그리고 같은 설정의 테스트 정확도가 60.0%인데, 이 성적을 "절반보다 낫다"고 평가하면 안 되는 까닭을 숫자 하나를 들어 반박하시오.
📖 모범 답안

100.0%가 당연한 까닭 — 훈련 데이터 안의 씨앗을 채점할 때, 그 씨앗과 가장 가까운 씨앗은 자기 자신이다(거리 0). k = 1은 1위 이웃 하나만 보므로 늘 자기 이름표를 그대로 돌려준다. 즉 이 100%는 외운 것이지 이해한 것이 아니다.

60.0%를 반박하는 숫자 = 66.7%. 테스트 씨앗 15개 중 B가 10개다. 그러므로 아무 계산도 하지 않고 "전부 B"라고만 우기는 기계의 정확도가 10/15 = 66.7%다. k = 1의 60.0%는 그보다 낮다. 데이터를 마흔 줄이나 쓰고 거리를 6백 번 계산한 결과가, 아무것도 안 하는 답보다 못한 것이다.

모든 정확도는 기준선과 견주어야 뜻이 생긴다. 기준선을 밝히지 않은 정확도는 성적표가 아니다.

4. 품종이 둘일 때 k를 짝수로 잡으면 무엇이 곤란한가? 오늘 코드가 동점을 실제로 어떻게 처리했는지 쓰고, 그 처리 방식이 'k-NN 이라는 알고리즘이 정한 것'이 아닌 까닭을 설명하시오. 그리고 그 규칙을 바꾸면 결과가 얼마나 달라졌는지 오늘 잰 값을 들어 쓰시오.
📖 모범 답안

곤란한 점 — 표가 갈릴 수 있다. k = 2에서 A 1표 B 1표가 되면 무엇을 답해야 할지 코드에 적혀 있지 않다. 실제로 테스트 씨앗 15개 중 10개에서 동점이 났다.

오늘 코드의 처리 — 오류 없이 답이 나왔다. votes 딕셔너리가 가까운 이웃 순서대로 채워지고, max()는 값이 같으면 먼저 들어온 키를 돌려주기 때문이다. 결과적으로 1위 이웃의 품종이 이긴다. 증거는 k = 2의 예측이 k = 1과 15개 모두 같다는 것이다 — 이웃을 하나 더 물었는데 바뀐 답이 하나도 없었다.

k-NN 이 정한 것이 아닌 까닭 — 이 동작은 파이썬 딕셔너리가 넣은 순서를 기억한다는 성질에서 나온 것이지, 알고리즘 어디에도 그렇게 하라고 적혀 있지 않다. 다른 언어로 옮기면 답이 달라질 수 있다.

바꿔 보면 — k = 4에서 동점을 '가나다순'으로 깨도록 바꾸면 예측 3개가 통째로 뒤집히고 정확도가 12/15 = 80.0%에서 13/15 = 86.7%가 된다. 알고리즘 본문은 한 글자도 안 바뀌었다. → 동점 처리 규칙은 알고리즘의 일부이며, 적어 두지 않으면 알고리즘이 덜 적힌 것이다. 가장 간단한 예방책은 k를 홀수로 잡는 것이다(품종이 둘일 때 동점이 구조적으로 불가능해진다).

5. 시뮬레이터 과제 ①에서 채운 표를 보시오. 여섯 무게에서 찾은 경계 좌표로 K = 1과 K = 9의 경계선을 각각 그리고, 두 값의 최대 − 최소를 계산해 견주시오. 이 두 숫자로 "K를 키우면 경계가 어떻게 되는가"를 한 문장으로 쓰고, 그 성질이 훈련 정확도와 테스트 정확도에 각각 어떻게 나타났는지 연결하시오.
📖 모범 답안

경계 좌표(mm)

무게 1.8 → K1 5.53 · K3 5.45 · K9 6.00
무게 2.2 → K1 5.55 · K3 5.81 · K9 6.18
무게 2.6 → K1 5.56 · K3 6.04 · K9 6.27
무게 3.0 → K1 5.95 · K3 6.41 · K9 6.36
무게 3.4 → K1 6.62 · K3 6.60 · K9 6.46
무게 3.8 → K1 7.11 · K3 6.79 · K9 6.60

흔들리는 폭 — K = 1은 7.11 − 5.53 = 1.58mm, K = 3은 6.79 − 5.45 = 1.34mm, K = 9는 6.60 − 6.00 = 0.60mm.

한 문장 — K를 키우면 경계가 곧게 펴진다(휘는 폭이 1.58mm에서 0.60mm로 2.6배 줄어든다).

정확도와의 연결 — K = 1의 경계는 씨앗 한 알 한 알을 전부 맞히려고 휘어진 것이라 훈련 데이터는 100.0% 맞힌다. 그런데 그 휘어짐은 데이터의 잡음까지 따라간 것이라 처음 보는 씨앗에서는 60.0%로 무너진다. K를 5로 키우면 훈련은 77.5%로 내려가지만 테스트는 93.3%로 올라간다. 훈련 성적을 조금 포기하고 테스트 성적을 얻은 것이며, 이 맞바꿈이 11차시의 주제다.

6. 무게를 g 대신 mg으로 적었더니 테스트 정확도가 k = 5에서 93.3%에서 46.7%로 떨어졌다. (가) 5차시의 어떤 처리를 빠뜨린 것인가? (나) 이때 길이라는 특성이 사라졌다는 주장을 오늘 낸 표로 증명하시오. (다) 그렇다면 "정규화를 하면 정확도가 오른다"고 말해도 되는가? 오늘 표에서 반례를 찾아 답하시오.
📖 모범 답안

(가) 5차시의 정규화(0~1 min-max 또는 z-점수)를 빠뜨렸다. k-NN 은 거리로만 움직이는데, mg으로 적으면 무게 차이가 수백~수천이 되고 길이 차이는 최대 4쯤이다. 제곱해 더하면 무게 항이 거의 전부를 차지한다.

(나) 증명 — mg · 정규화 안 함 줄과 무게 하나만 쓴 줄을 견주면 여섯 칸이 모두 같다: 53.3 · 60.0 · 46.7 · 60.0 · 66.7 · 60.0. 게다가 테스트 씨앗 15개의 예측도 15개 모두 같다. 길이를 넣었든 안 넣었든 결과가 똑같다면, 길이는 계산에 참여하지 않은 것이다. (kg으로 적으면 반대로 길이만 쓴 줄과 닮아진다 — 이번엔 무게가 사라진다.)

(다) 말하면 안 된다. 반례가 오늘 표 안에 있다. g 단위에서는 정규화를 안 한 쪽이 k = 3에서 80.0 대 73.3, k = 9에서 93.3 대 86.7로 오히려 높다. 이 데이터는 길이 폭 4.17, 무게 폭 2.75로 두 특성의 크기가 애초에 비슷해서 정규화가 할 일이 없다.

맞는 문장은 이렇다 — 정규화는 '단위를 어떻게 적을지'라는 사람의 선택이 결과를 정하지 못하게 막는 장치다. 실제로 정규화를 켜면 g·mg·kg 세 줄이 소수점 한 자리도 다르지 않게 완전히 같아진다.

🔎

더 알아보기

진짜 씨앗을 잰 데이터, 어떤 k로도 못 맞히는 한 알, 특성이 늘면 무너지는 '가깝다'

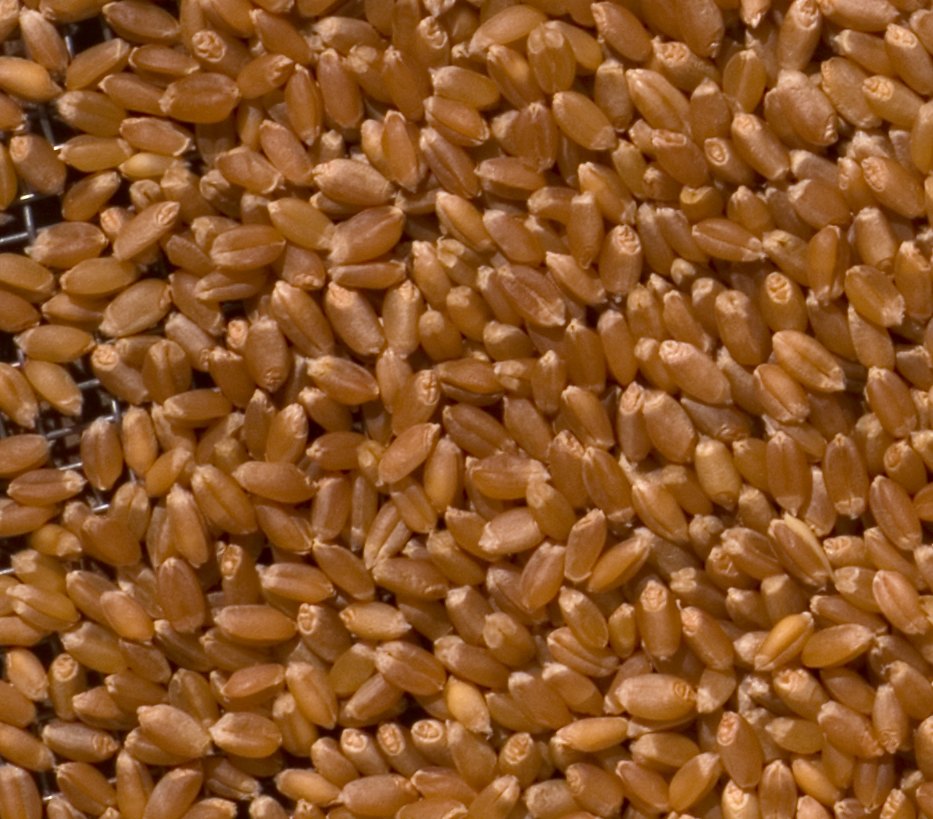
철망 위에 수북이 쌓인 갈색 밀 낟알. 낟알마다 길쭉한 타원형이다
현장

진짜 씨앗을 재서 품종을 가른다 — 밀알 210알

오늘 쓴 씨앗 값은 수업을 위해 지어낸 것이지만, 실제로 씨앗을 재서 품종을 가르는 데이터도 있습니다. 폴란드 루블린의 농업물리학 연구소(폴란드 과학원)가 밀 세 품종(Kama · Rosa · Canadian)의 낟알을 품종마다 70알씩, 모두 210알 골라 약한 X선으로 찍은 뒤, 낟알 하나하나의 모양을 숫자로 옮긴 것입니다. 기계학습 연구자들이 함께 쓰는 UCI 데이터 저장소에 'Seeds'라는 이름으로 공개되어 있어요.

이 데이터의 특성은 둘이 아니라 일곱입니다 — 넓이, 둘레, 조밀도, 낟알 길이, 낟알 너비, 비대칭 계수, 홈 길이. 눈여겨볼 것은 단위가 제각각이라는 점입니다. 넓이는 mm²라서 십몇에서 이십 남짓의 값이고, 조밀도(4π × 넓이 ÷ 둘레²)는 단위가 없는 비율이라 1을 넘지 못합니다. 오늘 개념 4에서 본 대로, 이대로 거리를 재면 값이 큰 넓이가 계산을 휩쓸고 조밀도는 있으나 마나가 됩니다.

그래서 이 데이터로 k-NN 을 돌릴 때도 순서는 오늘과 같습니다. 정규화 기준은 훈련 몫에서만 뽑고, 품종이 셋이라 홀수 k로도 동점이 날 수 있으니 동점 규칙을 따로 적고, 테스트 몫은 마지막에 한 번만 씁니다. 사진처럼 비슷비슷해 보이는 낟알도 일곱 개의 자로 재면 구역이 갈립니다.

사진: 밀 낟알(Triticum aestivum) · 출처: Peer Schilperoord, Wikimedia Commons (CC BY-SA 4.0)

길이 7.2~8.7mm · 무게 3.0~3.9g 자리를 크게 본 것 15번 · 정답 A 5번 · 정답 B 길이 → 훈련 A 훈련 B 두 알 사이 거리 0.073 — 그런데 품종은 반대다. 5번의 가까운 이웃 다섯은 모두 A(회색 점선). → k를 1~40 어느 값으로 둬도 5번은 틀린다.
원리 더 깊이

왜 93.3%에서 멈추나 — 데이터 안의 모순 한 쌍

k를 아무리 잘 골라도 테스트 정확도는 93.3%(14/15)에서 멈춥니다. k를 1부터 40까지 전부 돌려 봐도 그 위로는 못 올라가요. 까닭은 모델이 아니라 데이터 안에 있습니다. 테스트 씨앗 5번은 [8.45, 3.24] 품종 B, 15번은 [8.43, 3.31] 품종 A입니다. 두 점 사이 거리가 0.073밖에 안 되는데 이름표가 반대예요.

그림처럼 두 알 둘레의 훈련 씨앗은 거의 다 A입니다. 5번에서 가장 가까운 다섯 알이 전부 A라서 k-NN 은 5번을 늘 A라고 답합니다. 실제로 k = 1부터 40까지 확인하면 5번은 한 번도 맞지 않고, k = 5에서 틀린 단 하나가 바로 5번입니다. 데이터에 모순이 있으면 어떤 모델도 100%가 될 수 없습니다.

그렇다고 수상한 씨앗을 지우면 해결될까요? 둘레가 온통 B인데 혼자 A인 훈련 씨앗 [6.15, 2.95]를 지우고 다시 재면, k = 1의 테스트 정확도는 60.0%에서 53.3%로 오히려 내려갑니다. 이상해 보이는 기록이 잘못 적힌 것인지 드물지만 진짜인 것인지는 데이터만 봐서는 알 수 없어요. 지우는 일은 되돌릴 수 없지만 k는 언제든 되돌릴 수 있습니다 — k를 키우는 것이 데이터를 지우지 않고 잡음을 누그러뜨리는 방법입니다.

가장 가까운 점 ÷ 가장 먼 점 (거리의 비) 특성 2개 0.03 10개 0.30 100개 0.70 1000개 0.90 1 1에 가까울수록 가장 가까운 점도 가장 먼 점만큼 멀다. 0~1 사이 무작위 점 500개 · 20번 재어 평균한 값
원리 더 깊이

특성이 많아지면 '가깝다'가 뜻을 잃는다 — 차원의 저주

오늘은 특성이 둘(길이 · 무게)이었습니다. 특성을 열 개, 백 개로 늘리면 k-NN 이 더 똑똑해질까요? 오히려 반대입니다. 특성이 많아지면 점들이 공간에 성기게 흩어져 서로 고르게 멀어집니다. 그래프는 0과 1 사이 무작위 점 500개를 두고, 새 점에서 가장 가까운 점까지의 거리를 가장 먼 점까지의 거리로 나눈 값을 직접 재 본 것입니다. 특성이 2개일 때는 0.03이라 '가까운 이웃'이 확실히 가깝지만, 1000개가 되면 0.90 — 가장 가까운 점도 가장 먼 점과 별 차이 없이 멉니다.

이 현상을 차원의 저주(curse of dimensionality)라 부릅니다. 거리로만 움직이는 k-NN 은 이 저주를 정면으로 맞습니다. 이웃이 모두 비슷하게 멀면 누구에게 표를 받든 결과가 제비뽑기에 가까워지니까요.

그래서 실제로 k-NN 을 쓸 때는 특성을 줄이는 일이 먼저입니다 — 6차시에서 다룬 특성 고르기가 그 일이에요. 6차시의 학생 260명 데이터에서 점수를 정하는 것은 공부시간과 지난점수 둘뿐이었고 나머지 열세 개는 아무 뜻 없는 특성이었지요. 그 열세 개를 그대로 두고 거리를 재면, 뜻 없는 차이 열세 개가 진짜 특성 둘의 차이를 덮어 버립니다.